
智能制造与工业软件 / 系统课时
微调检测模型定位细小缺陷
微调检测模型定位细小缺陷
工业相机拍到的划痕、针孔和局部破损可能只有几个像素,直接使用通用目标检测模型往往容易漏检。本篇使用 PyTorch 2.x 与预训练 YOLO11 检测模型,完成工业缺陷数据准备、迁移训练、细小目标优化和推理结果验证,得到能够输出缺陷类别、置信度及位置的模型。
学习目标
- 将工业缺陷标注转换为 YOLO 检测格式,并正确划分训练、验证和测试数据。
- 使用预训练权重微调检测模型,通过分辨率与数据采样改善细小缺陷识别。
- 读取检测框、类别和置信度,结合漏检率、误报率及定位指标评估模型。
把工业缺陷标注整理成训练数据
假设产线使用 2048×1536 工业相机检测金属板,目标是识别划痕(scratch)与针孔(pinhole)两类缺陷。相机、光源、曝光和工件位置应先保持稳定,否则模型容易把照明变化误认为缺陷。
统一标注格式
Ultralytics YOLO 检测数据使用归一化的中心点坐标与宽高,每个缺陷占一行,格式为 class_id x_center y_center width height。类别从 0 开始编号,坐标和宽高通常处于 0~1 范围。
例如原始图像宽 2048、高 1536,针孔框中心位于 (800,600),宽 12 像素、高 8 像素。如果当前将针孔定义为类别 1,对应标注为:
1 0.390625 0.390625 0.005859 0.005208这些数值分别来自中心横坐标除以图像宽度、中心纵坐标除以图像高度,以及缺陷框宽高除以原图宽高。归一化必须使用标注所在图像的实际尺寸,裁切后应重新计算。
按生产批次划分数据
建议初次实验按原始工件或生产批次划分约 80% 训练集、10% 验证集、10% 测试集。同一个工件连续拍摄的图像不能同时进入不同集合,避免模型记住工件纹理而得到虚高的验证指标。
在项目目录中建立 defect_data/images/train、defect_data/images/val、defect_data/images/test,分别存放图像,并在对应的 defect_data/labels/train、defect_data/labels/val、defect_data/labels/test 下存放同名 TXT 标注。
正常图像没有目标框时,可以使用空标注文件或不创建对应的 TXT 文件。不要把正常工件错误标成某一种缺陷。
在项目根目录创建 defect.yaml:
path: ./defect_data
train: images/train
val: images/val
test: images/test
names:
  0: scratch
  1: pinhole
该配置声明数据目录和类别映射。后续从项目根目录运行训练脚本;如果使用其他工作目录,应把 path 改为数据集绝对路径。
检查时至少确认每张有缺陷的图像能找到对应标注,类别 ID 只能为 0 或 1,框宽高必须大于 0,且缺陷框不能越过图像边界。尤其要检查针孔是否被标成包含大片正常背景的矩形。
通过输入分辨率保留细小缺陷
检测模型通常会缩放输入图像。假设原图为 2048×1536,一个针孔宽 12 像素、高 8 像素。如果把长边缩到 640 像素,该缺陷在输入图像中只剩约 3.75×2.5 像素,经过特征下采样后就很难可靠定位。
一种直接方案是增加训练输入尺寸,例如将 imgsz 从 640 提高到 960 或 1280。但输入面积和显存需求也会增加,必须结合实际 GPU 容量和推理节拍选择。
对于大幅面工业图像,另一种方案是先裁切局部图块,再送入检测模型。比如把 2048×1536 原图裁成 1024×1024 的图块,采用 128 像素重叠,再将图块缩放到 960 输入尺寸。这样同一个 12 像素宽缺陷,在不发生裁切的情况下仍能保留约 11.25 像素宽度。
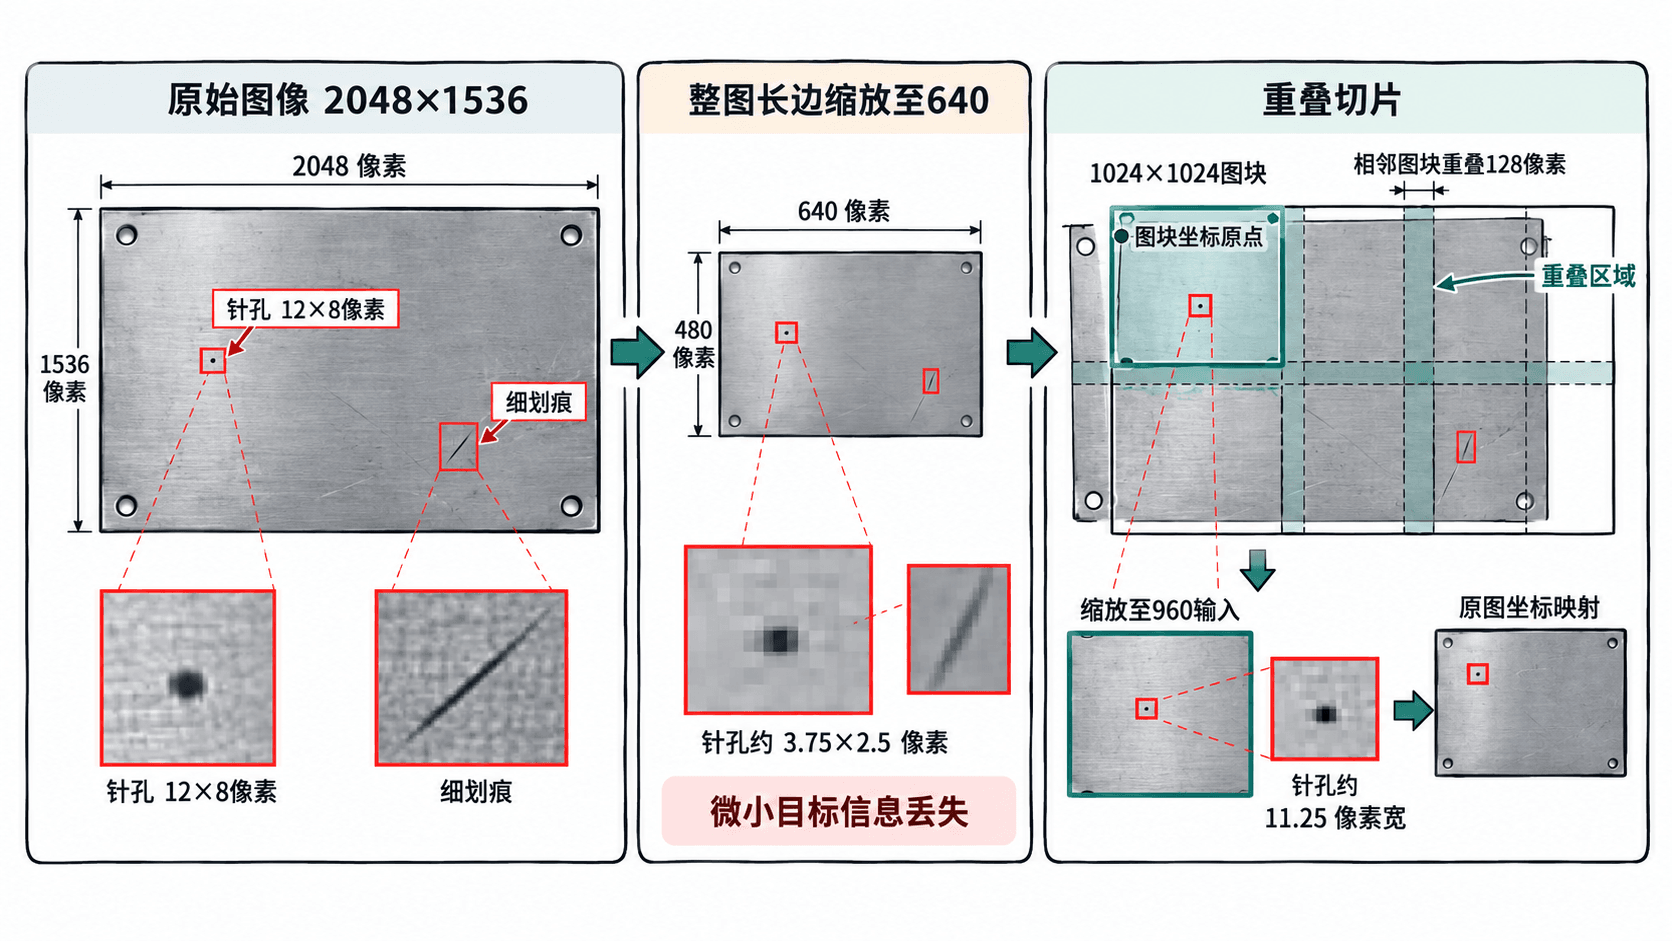
切片时必须把原始检测框转换到图块局部坐标,并对超出图块的部分进行裁剪。严重截断、无法辨认的缺陷不应直接当作完整目标训练。更重要的是先按原始工件划分数据集,再分别裁切,避免相邻图块泄漏到验证集。
推理时同样采用切片策略,检测框需要加上图块左上角在原图中的偏移量,再做跨图块重复框合并。训练使用切片而上线直接缩放整图,会造成明显的输入尺度不一致。
使用预训练 YOLO11 完成迁移训练
这里采用 Ultralytics YOLO11 检测模型,其训练和推理基于 PyTorch。选择 yolo11n.pt 作为轻量级起点,它包含在通用目标数据上训练得到的权重;微调时框架会根据新数据集的类别数适配检测输出。
建议使用 Python 3.10 或 3.11、PyTorch 2.x,并优先配置可用的 NVIDIA CUDA GPU。新建独立虚拟环境后,在项目根目录执行:
python -m pip install "torch>=2,<3" torchvision ultralytics
python -c "import torch; from ultralytics import YOLO; print(torch.__version__); print(torch.cuda.is_available())"
预期结果:第一条命令正常结束,第二条命令打印已安装的 PyTorch 版本以及 CUDA 是否可用。True 表示当前 PyTorch 可以使用 CUDA;False 表示没有检测到可用 CUDA 环境,仍可在 CPU 上运行,但高分辨率训练会较慢。不同操作系统及 CUDA 版本可能需要按 PyTorch 官方安装说明选择对应安装源。
创建 train_defect.py,确保 defect.yaml、defect_data 和脚本处于同一项目根目录。下面的脚本将训练、验证及单张图像推理串联在一起。
from pathlib import Path

import torch
from ultralytics import YOLO

ROOT = Path(__file__).resolve().parent
DATA = ROOT / "defect.yaml"
VAL_DIR = ROOT / "defect_data" / "images" / "val"
RUN_DIR = ROOT / "runs" / "defects"

# 避免误用不符合本课环境要求的 PyTorch 大版本
assert torch.__version__.split(".")[0] == "2"
assert DATA.is_file(), f"Missing dataset config: {DATA}"
assert VAL_DIR.is_dir(), f"Missing validation images: {VAL_DIR}"

model = YOLO("yolo11n.pt")
model.train(
    data=str(DATA),
    epochs=80,
    imgsz=960,
    batch=4,
    patience=20,
    mosaic=0.0,
    fliplr=0.0,
    seed=42,
    device=0 if torch.cuda.is_available() else "cpu",
    project=str(RUN_DIR),
    name="tile960",
    exist_ok=True,
)

# 使用验证表现最好的权重,而不是直接使用最后一轮权重
best_path = RUN_DIR / "tile960" / "weights" / "best.pt"
assert best_path.is_file(), f"Missing checkpoint: {best_path}"
best = YOLO(str(best_path))
metrics = best.val(data=str(DATA), split="val", imgsz=960)
print(f"mAP50={metrics.box.map50:.3f}")
print(f"mAP50-95={metrics.box.map:.3f}")

for index, score in enumerate(metrics.box.maps):
    print(f"{best.names[index]} mAP50-95={score:.3f}")

# 用验证集图块检查推理框的坐标与类别
images = sorted(
    p for p in VAL_DIR.iterdir()
    if p.suffix.lower() in {".jpg", ".jpeg", ".png", ".bmp"}
)
if not images:
    raise RuntimeError("Validation image directory is empty")

result = best.predict(
    source=str(images[0]), imgsz=960, conf=0.25, verbose=False
)[0]

if len(result.boxes) == 0:
    print("NO_DEFECT_CANDIDATE")

for xyxy, conf, cls in zip(
    result.boxes.xyxy.cpu().tolist(),
    result.boxes.conf.cpu().tolist(),
    result.boxes.cls.cpu().tolist(),
):
    print(
        f"{result.names[int(cls)]} "
        f"conf={conf:.3f} "
        f"xyxy={[round(v, 1) for v in xyxy]}"
    )
在项目根目录执行 python train_defect.py。预期结果:训练完成后生成 runs/defects/tile960/weights/best.pt,控制台打印整体及各类别的 mAP 指标。如果预测到缺陷,会打印类别、置信度和四个检测框坐标;否则打印 NO_DEFECT_CANDIDATE。具体指标和检测框取决于实际数据,不能预先固定。
当前 imgsz=960、batch=4 和 epochs=80 是实验起点,不是所有产线的最优配置。如果出现 CUDA 显存不足,先把 batch 降至 2 或 1,再考虑适当降低输入尺寸。脚本设置 mosaic=0.0,是为了避免多图拼接改变细小缺陷的尺寸及局部背景分布;是否启用其他增强应通过验证集实验确定。
处理缺陷类别不均衡与推理边界
实际产线可能存在 1200 个划痕框、80 个针孔框和大量正常图像。直接训练时,模型可能优先优化数量更多的划痕,而针孔召回率长期偏低。
可以先统计每种缺陷的图像数、实例框数和独立工件数,再采取以下调整:
- 优先补采真实针孔样本,覆盖不同金属表面、缺陷尺寸和光照批次,而不是重复导入完全相同的图片。
- 仅在训练集中对稀有类别做定向采样或适度增强。比如先让针孔出现的有效训练样本数量提高约 2~3 倍,再观察验证集变化。
- 保留有代表性的正常图像,例如初次训练可让无缺陷图像占训练图像的约 20%~40%,但具体比例需要根据误报结果调整。
- 避免会改变真实缺陷属性的增强。例如依赖颜色识别氧化斑时,不应随意使用强烈色相变化;具有方向性的轧制纹理也不应默认水平翻转。
推理结果中的 result.boxes.xyxy 是检测框左上角和右下角坐标,result.boxes.conf 是置信度,result.boxes.cls 是类别编号。框坐标对应当前输入图像的像素坐标;对于切片推理,还必须转换回原始相机图像坐标。
例如图块原点位于原图 (896,0),某检测框在图块中的坐标为 (120,200,135,211),则原图坐标为 (1016,200,1031,211)。重叠切片可能产生多个指向同一缺陷的框,应在原图坐标系中采用 NMS 等方法消除重复检测。
conf=0.25 仅是初始推理阈值。降低阈值通常能保留更多候选缺陷,但也可能增加误报。不能因为输出为空就直接把整件工件视为合格,还需要确认成像、模型加载、切片覆盖和推理过程均正常。
用独立测试集确定模型能否进入产线
训练脚本中的 mAP50 衡量在 IoU 为 0.5 时的平均精度,mAP50-95 综合多个更严格的 IoU 阈值。它们适合比较模型,但不能直接替代工业现场的漏检率和误剔率。
建议在验证阶段针对不同置信度阈值统计缺陷召回率和正常件误剔率,并在最终确定模型、切片策略和阈值后,使用未参与调参的独立测试批次验收。
例如固定一个实验阈值,对 200 件已确认存在缺陷的工件测试,其中 198 件至少检出一个符合判定规则的真实缺陷,则按工件计算的缺陷检出率为 198÷200=99%。再用 200 件正常工件测试,如果其中 3 件被错误判为 NG,则正常件误剔率为 3÷200=1.5%。这两个数值只是计算示例,并非推荐的合格标准。
还应按缺陷尺寸分层统计结果,例如将针孔分为小于 8 像素、8~16 像素和大于 16 像素三组。若整体 mAP 很高,但最小尺寸组漏检严重,就应优先检查成像放大倍率、切片分辨率和标签质量,而不是只增加训练轮数。
最终验收至少记录模型权重版本、测试批次、类别及尺寸分组召回率、正常件误剔率、定位误差和端到端推理耗时。端到端耗时应包含裁切、模型推理、重复框合并及 PLC 判定接口处理,并与产线允许的处理节拍比较。
如果模型在独立批次中对微小针孔仍不稳定,应先验证相机是否采集到了足够清晰的缺陷像素。对于肉眼在原始图像中都难以稳定辨认的目标,单纯更换更大的检测网络通常无法从已经丢失的图像信息中恢复真实缺陷。