
高等数学 / 系统课时
回归模型诊断
回归模型诊断
回归方程拟合完成后,不能只凭较高的决定系数判断模型可靠。本课使用残差检查线性、正态、同方差和异常观测,并给出一套从发现信号到修复验证的诊断顺序。
学习目标
- 理解残差在模型诊断中的作用
- 识别四类典型残差图形和异常信号
- 按顺序定位问题、选择修复方法并重新验证
先看残差而不是只看拟合优度
第 个观测的残差定义为:
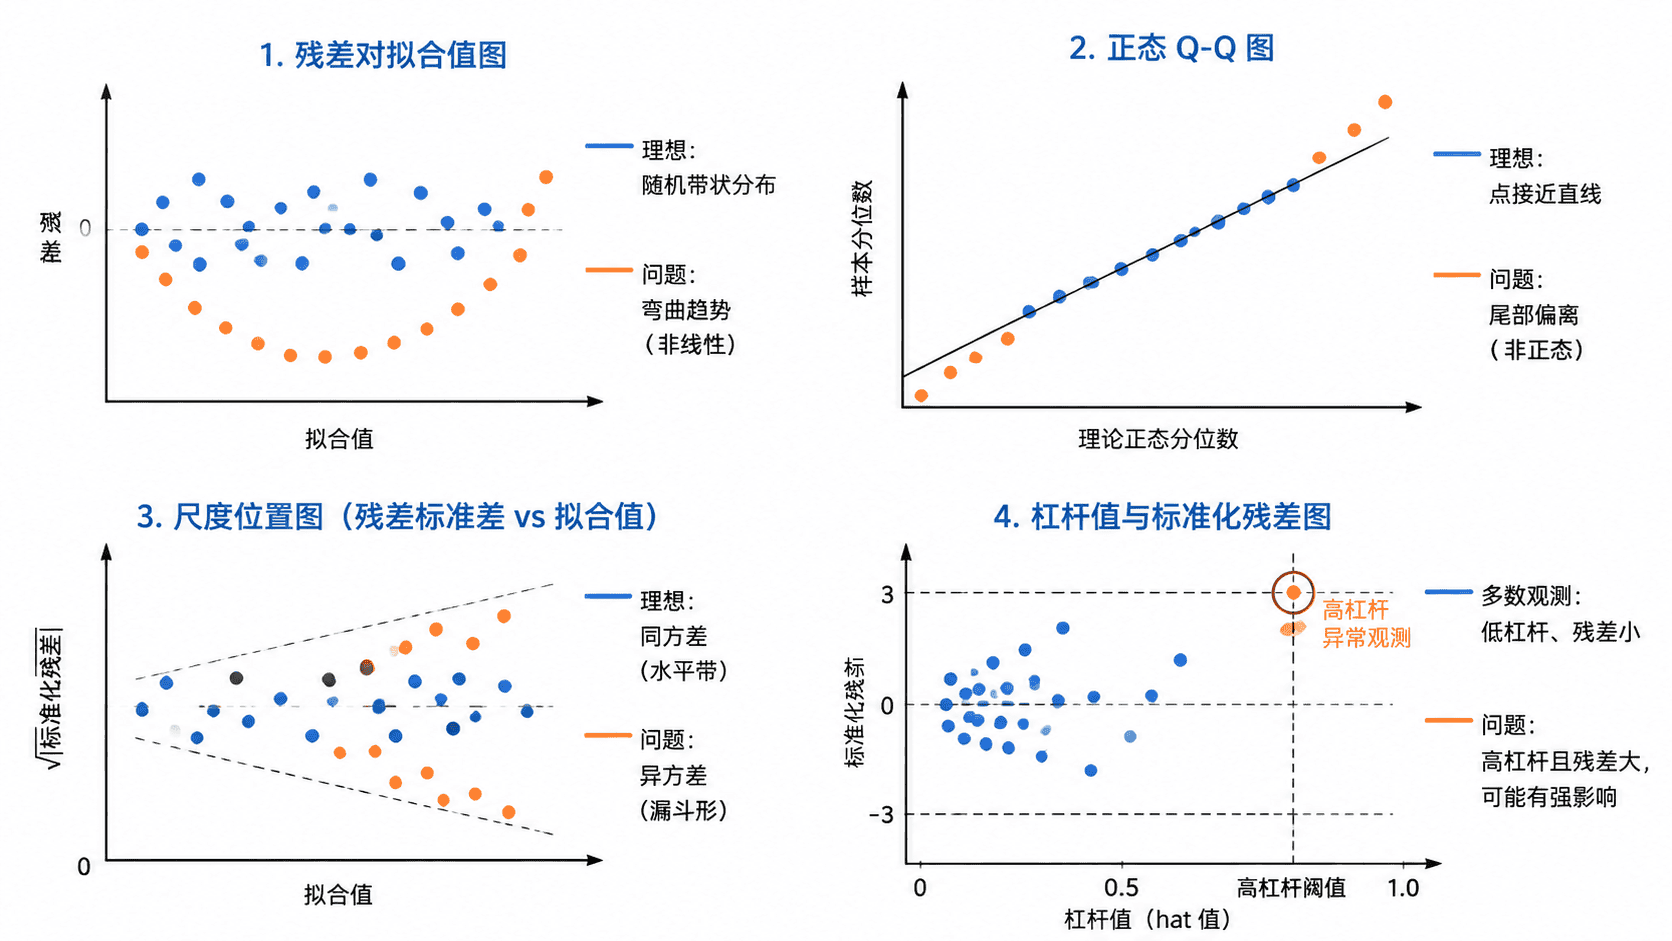
残差是实际值与预测值之间的差。若线性模型设定合理,残差应围绕 0 随机波动,不应随着拟合值或某个自变量呈现明显曲线、漏斗形、分组结构或孤立极端点。
决定系数只能说明模型解释了多少样本波动,不能证明线性关系正确、误差方差稳定或异常点不存在。因此,诊断应在解释系数和进行显著性推断之前完成。
四类假设分别看什么
| 检查目标 | 主要工具 | 理想信号 | 问题信号 |
|---|---|---|---|
| 线性 | 残差对拟合值图 | 点在 0 附近随机分布 | 弧形、波浪形或分组结构 |
| 正态 | Q-Q 图 | 大多数点贴近参考直线 | 两端系统偏离或明显偏斜 |
| 同方差 | 残差散点图、尺度位置图 | 垂直散布宽度大致稳定 | 漏斗形或波动随拟合值增大 |
| 异常观测 | 标准化残差、杠杆值、Cook 距离 | 无孤立且强影响的点 | 大残差、高杠杆或高影响点 |
正态性主要影响小样本下的置信区间和显著性检验,并不要求因变量本身服从正态分布。同方差性被破坏时,普通最小二乘系数仍可能无偏,但标准误和检验结论可能不可靠。
最小可运行检查
下面的 Python 示例用两个自变量拟合线性模型,并计算残差、标准化残差以及拟合值与残差绝对值的相关系数。示例依赖 NumPy,数据固定,因此输出可重复。
import numpy as np

x1 = np.array([1, 2, 3, 4, 5, 6, 7, 8], dtype=float)
x2 = np.array([2, 1, 3, 2, 4, 3, 5, 4], dtype=float)
y = np.array([5.0, 6.1, 8.8, 9.6, 13.7, 14.2, 19.4, 21.8])

# 设计矩阵第一列为 1,用于估计截距
X = np.column_stack([np.ones(len(y)), x1, x2])
beta = np.linalg.lstsq(X, y, rcond=None)[0]
fitted = X @ beta
residuals = y - fitted

# 利用帽子矩阵对残差进行标准化,便于比较不同观测
hat = X @ np.linalg.inv(X.T @ X) @ X.T
sigma = np.sqrt(np.sum(residuals ** 2) / (len(y) - X.shape[1]))
standardized = residuals / (sigma * np.sqrt(1 - np.diag(hat)))
corr = np.corrcoef(fitted, np.abs(residuals))[0, 1]

print(f'b0={beta[0]:.3f}, b1={beta[1]:.3f}, b2={beta[2]:.3f}')
print(f'corr(fitted, |residual|)={corr:.3f}')
print(f'max|standardized residual|={np.max(np.abs(standardized)):.3f}')
print(f'observation={np.argmax(np.abs(standardized)) + 1}')
预期输出:
b0=0.450, b1=2.063, b2=0.863
corr(fitted, |residual|)=0.222
max|standardized residual|=1.810
observation=8
相关系数 0.222 没有显示残差绝对值随拟合值明显增大,但样本仅有 8 个,不能据此单独确认同方差。第 8 个观测的标准化残差绝对值最大,但仍未超过常用的 2 倍警戒线;实际分析还应结合残差图、杠杆值和业务背景。
从信号到修复的顺序
先检查数据质量,包括录入错误、单位混用、重复记录和类别编码问题。数据错误未排除前,不应急于改变模型。
若残差呈曲线,可考虑加入多项式项、交互项或对变量做合理变换;若出现漏斗形,可尝试对数变换、加权最小二乘或异方差稳健标准误。
遇到高杠杆或高影响观测,应追查其来源,并比较保留与剔除后的结果。不能只因为一个点让结论不显著就删除它;删除必须有数据错误、目标总体不一致或预先定义规则作为依据。
修复后必须重新拟合并再次查看全部诊断图。只修复一个信号而不复查其他假设,可能把问题从一种形式转移成另一种形式。