
高等数学 / 系统课时
指数分布
指数分布
指数分布用于描述某个随机事件发生前需要等待多长时间。本课将从概率密度和分布函数出发,计算等待时间概率,并重点理解无记忆性以及它与泊松过程之间的联系。
学习目标
- 掌握指数分布的概率密度、分布函数和常用参数
- 能够计算等待时间超过或落在某一区间内的概率
- 理解无记忆性及其在泊松过程中的含义
指数分布解决什么问题
当事件以相对稳定的平均速率随机发生时,可以用指数分布描述相邻两次事件之间的等待时间。例如顾客到店间隔、设备故障前的运行时间,以及请求到达服务器的时间间隔。
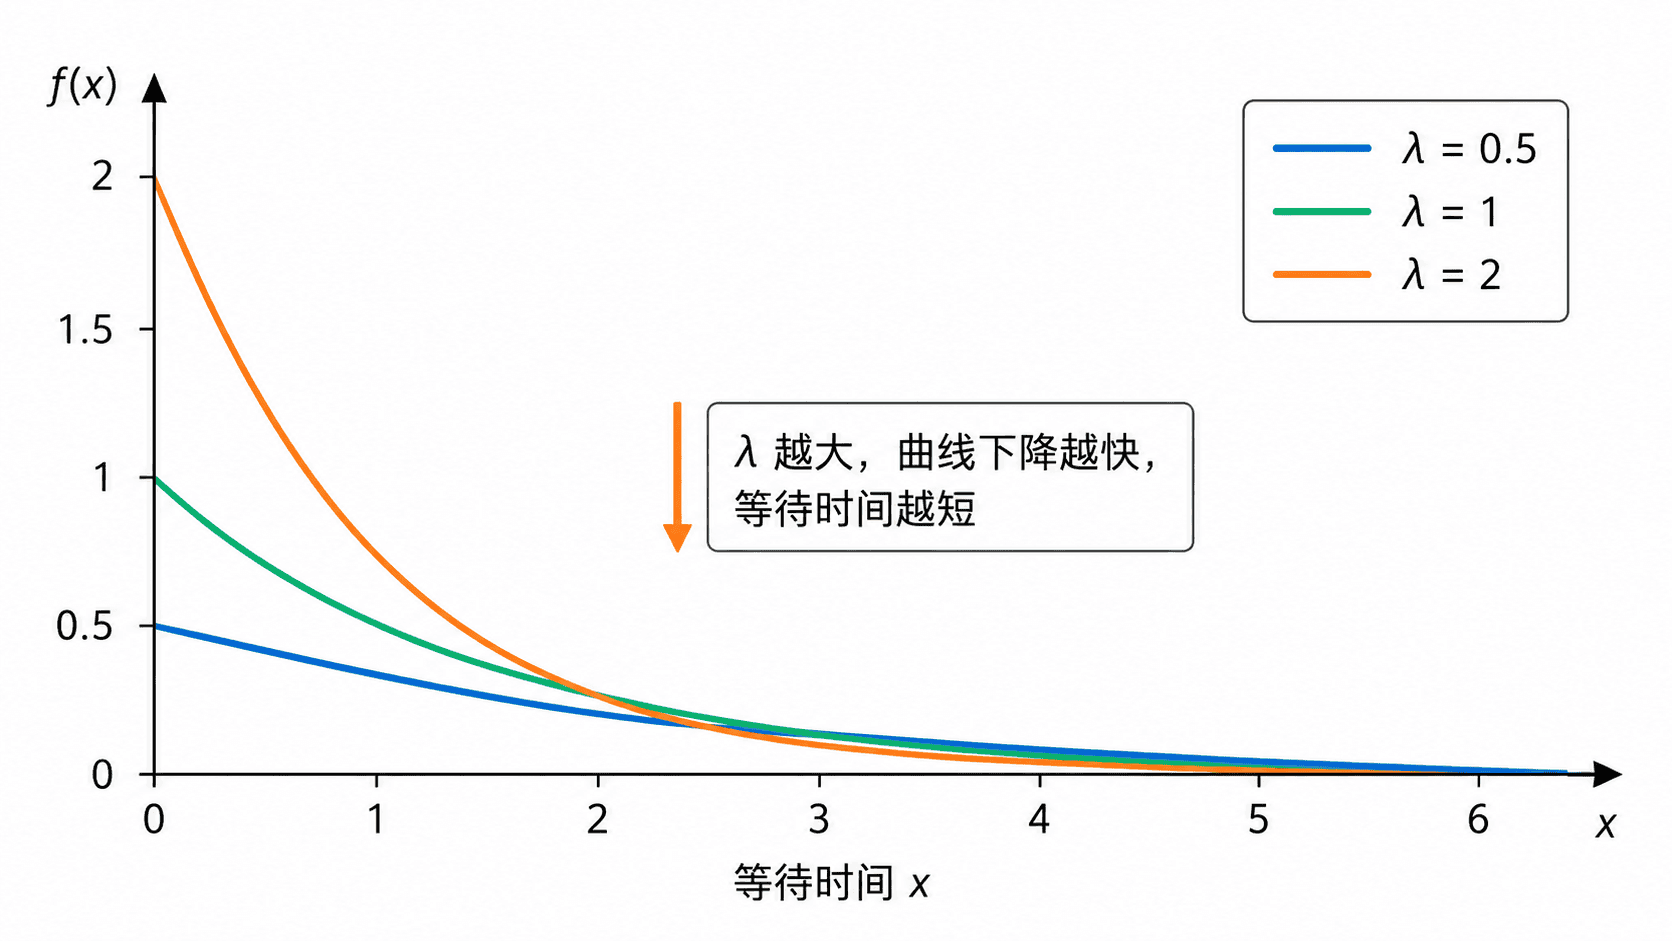
设连续随机变量 表示等待时间,参数 表示单位时间内事件发生的平均速率,记作 。它的概率密度函数为:
等待时间不可能为负,因此密度只在 的区域内取正值。 越大,事件发生越频繁,等待时间通常越短。
分布函数与等待概率
指数分布的分布函数表示等待时间不超过 的概率:
在实际问题中,更常见的是计算事件在某段时间后仍未发生的概率。由补集关系可得生存函数:
若事件平均每 10 分钟发生一次,则每分钟平均速率为 。等待超过 15 分钟的概率为:
。等待时间落在 5 到 15 分钟之间的概率为:
计算区间概率时,也可以直接使用“超过左端点的概率减去超过右端点的概率”,结果与分布函数相减完全一致。
期望、方差与参数含义
指数分布的期望和方差分别为:
因此, 是发生速率,而 才是平均等待时间。若平均每小时发生 4 次事件,则 ,平均等待时间为 小时,也就是 15 分钟。
使用参数前必须先统一时间单位。若 的单位是“次/小时”,代入公式的等待时间也必须使用小时。
无记忆性
指数分布最重要的性质是无记忆性。对于任意 ,都有:
它表示已经等待了 个单位时间,并不会改变还需要继续等待至少 个单位时间的概率。例如某类设备寿命服从指数分布,在已经正常运行 100 小时的条件下,它再运行 20 小时的概率,与一台刚开始运行的同类设备运行超过 20 小时的概率相同。
无记忆性并不意味着过去没有发生过,而是说明在当前模型中,未来等待时间的概率规律不依赖已经等待的时长。现实中会老化的设备通常不满足这一假设,因此不能机械套用指数分布。
与泊松过程的联系
在速率为 的泊松过程中,固定时间内发生的事件数量服从泊松分布,而从当前时刻等待下一次事件所需的时间服从参数为 的指数分布。
二者描述的是同一随机过程的不同角度:泊松分布回答“一段时间内发生多少次”,指数分布回答“下一次事件还要等多久”。这种联系成立的前提是事件独立发生,并且平均发生速率保持稳定。