
高等数学 / 系统课时
函数、指数与对数
函数、指数与对数
概率模型经常用函数描述变量关系,用指数表达增长或衰减,再用对数把乘法关系转成加法。本课将用一组相互关联的规则完成回顾,并说明它们为什么会反复出现在概率分布、似然计算和数据变换中。
学习目标
- 说清函数的输入、输出、定义域和值域
- 理解指数与对数互为反运算的关系
- 识别指数和对数在概率模型中的典型用途
函数:把输入映射为输出
函数可以看成一条确定的映射规则:给定定义域中的输入 ,就得到唯一输出 。例如 表示先把输入乘以 2,再加 1;当 时,输出为 7。
理解函数时应同时检查三件事:允许输入哪些值、可能输出哪些值,以及输入增大时输出如何变化。概率统计中的密度函数、分布函数和损失函数,本质上都在描述不同对象之间的映射关系。
函数不要求不同输入产生不同输出。例如 中, 与 都得到 4;但同一个输入不能同时对应两个不同输出。
指数和对数:成对理解
指数函数的一般形式是 ,其中 且 。当 时,函数随 增大而增长;当 时,函数随 增大而衰减。
对数回答相反的问题:已知底数 和结果 ,指数是多少。关系可以写成 当且仅当 。因此,指数函数与同底对数函数互为反函数。
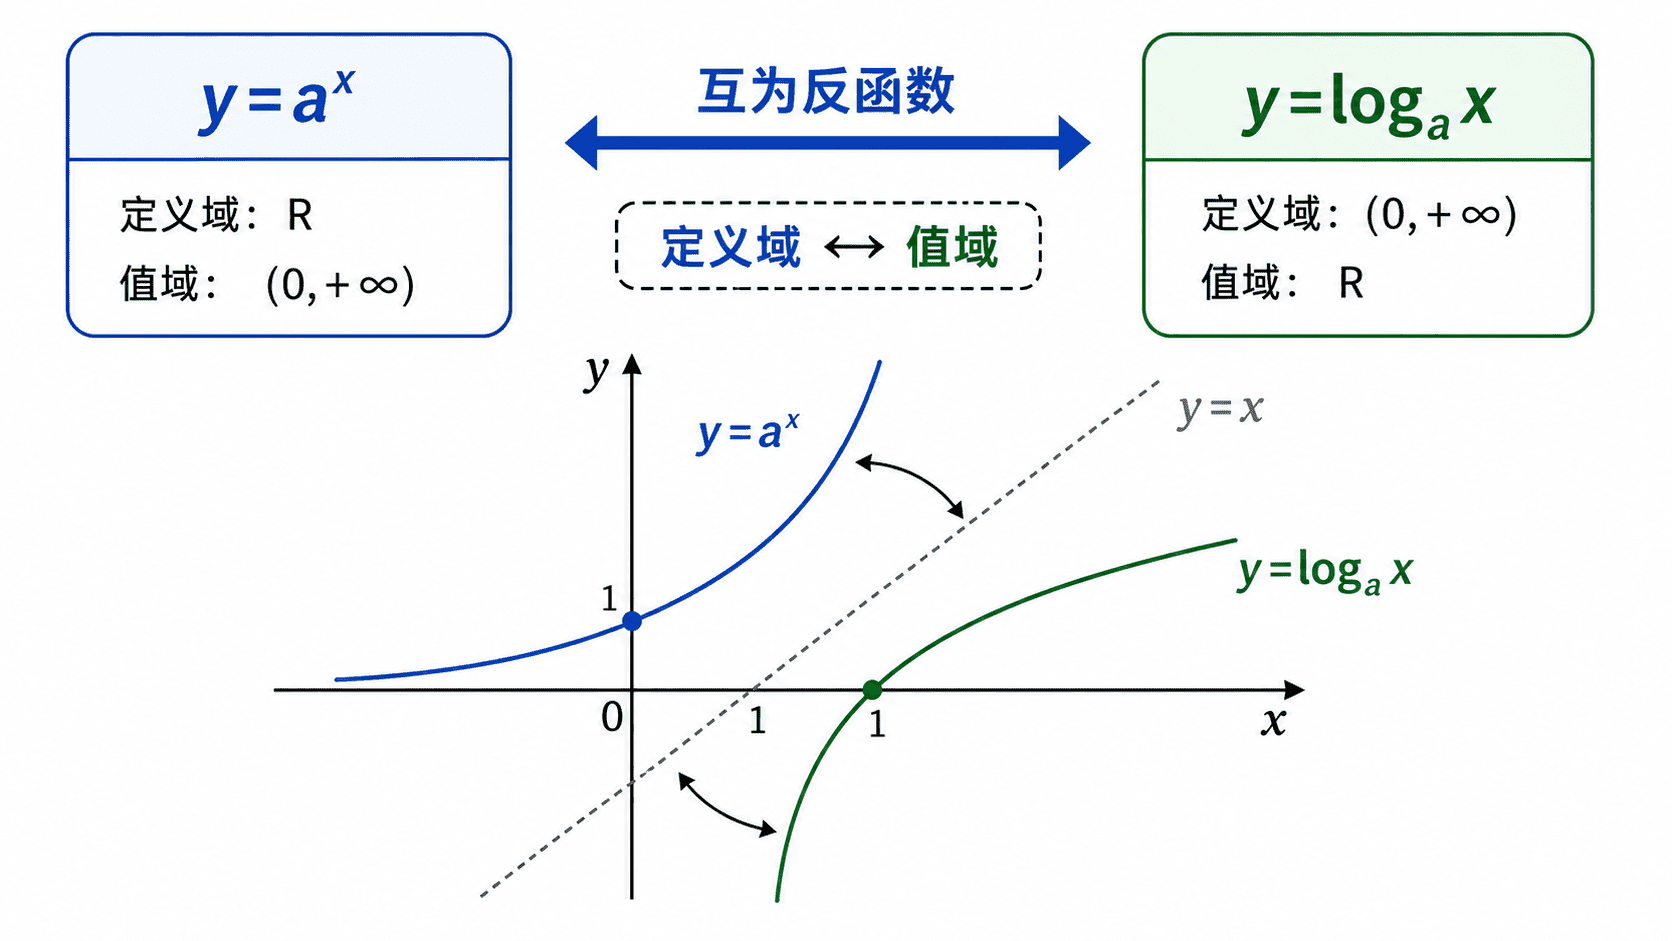
对数最重要的运算价值是把乘法变成加法。对正数 、,有 ;幂也可以移到前面,即 。这使得很小概率的连乘更容易计算,也更便于优化。
概率模型中的用途与边界
指数常用来描述连续衰减。例如等待时间模型中,超过时间 仍未发生事件的概率可以写成 ,其中 控制衰减速度。 越大,概率下降得越快。
对数常用于似然计算。若独立样本对应的概率为 ,联合似然是它们的乘积;取对数后得到求和:
求和比连乘更稳定,也更容易求导。实际建模中常最大化对数似然,而不是直接最大化原始似然;只要所有概率为正,两者得到的最优参数相同。
函数还用于数据变换。右偏且跨度很大的正数数据,经过对数变换后常更容易观察相对差异。不过,对数只接受正数,数据中存在 0 或负数时必须先说明处理规则。
使用前检查
指数的底数不能为负数,也不能等于 1;对数的真数必须大于 0。看到 时,底数是自然常数 ;看到 时,表示以 为底的对数。
不要把“函数值为概率”和“函数本身是概率分布”混为一谈。概率密度可以大于 1,但在有效区间上的积分必须为 1;离散概率质量函数则要求每个概率位于 0 到 1 之间,且总和为 1。
可以用反运算快速自检:若 ,那么 ;若计算结果不一致,通常是底数、括号或运算顺序出现了问题。