
高等数学 / 系统课时
完成综合分析项目
完成综合分析项目
本课将把问题定义、数据检查、描述分析、统计推断和结果汇报串成一个可运行项目。你将使用 scikit-learn 内置的糖尿病真实数据集,完成多元线性回归,并形成可复核、不过度解读的分析结论。
学习目标
- 把宽泛业务问题改写为可检验的统计问题
- 使用完整 Python 脚本完成数据检查、建模和可视化
- 根据系数、显著性与拟合优度撰写规范结论
项目问题与验收口径
本项目研究的问题是:在糖尿病数据中,体质指数 bmi、平均血压 bp 和血清指标 s5 是否与疾病进展指标存在统计关联?因变量为数据集中的 progression,自变量均已标准化,因此系数主要用于判断方向、相对影响和统计证据,不宜直接解释为原始量纲下的变化。
正式分析前,先写清四项口径:分析对象是 442 条样本记录;核心指标是回归系数、p 值和决定系数 ;显著性水平取 ;结论只描述关联,不宣称因果。项目验收时,代码应能重复运行,数据缺失情况应被检查,统计输出应能对应到文字结论。
分析流程与数据选择
综合分析不是“先跑代码再找故事”,而是按问题、数据、方法、证据和表达的顺序推进。每一步都要留下可复核结果,避免只展示最终的 p 值。
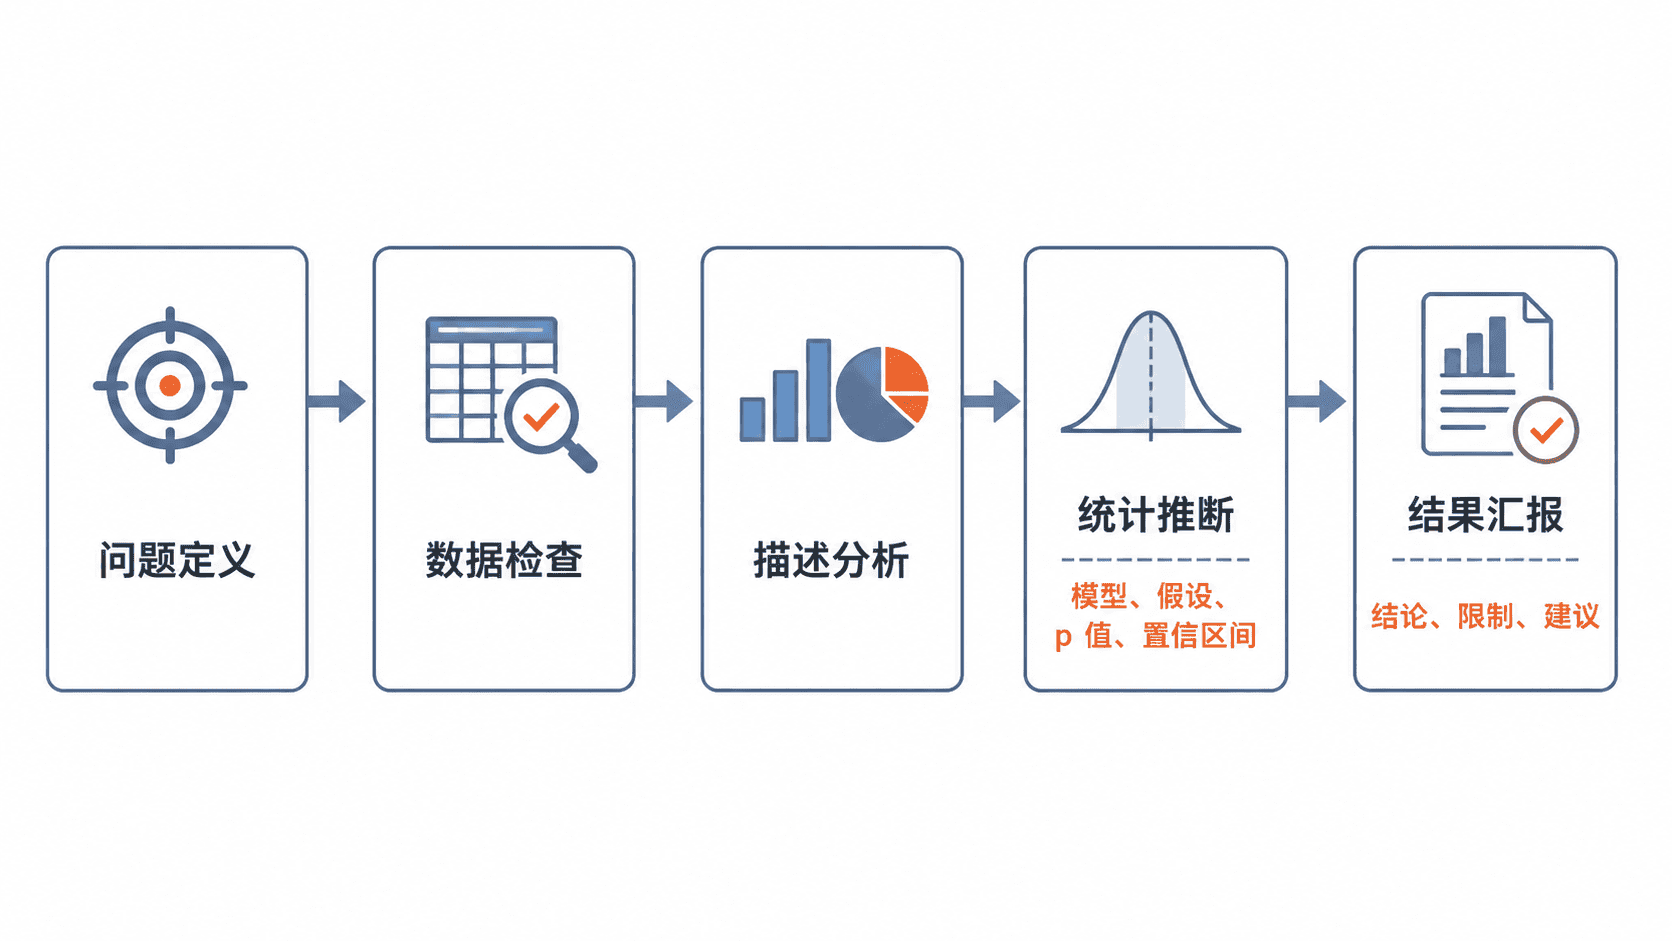
这里选择 scikit-learn 自带的糖尿病数据集,是因为它无需额外下载,字段定义稳定,适合复现。bmi、bp 和 s5 只是候选解释变量,并不代表已经控制所有潜在混杂因素。建模前仍需检查缺失值、变量分布和异常点,建模后还要查看残差,而不是仅凭一个显著性结果结束分析。
完整实现与预期结果
下面的脚本完成数据加载、字段重命名、缺失检查、多元线性回归、系数输出和两张诊断图保存。运行环境需要 Python 3,以及 pandas、scikit-learn、statsmodels 和 matplotlib。
from pathlib import Path

import matplotlib.pyplot as plt
import statsmodels.api as sm
from sklearn.datasets import load_diabetes

def main() -> None:
    # 数据集随 scikit-learn 安装,避免外部地址失效影响复现
    dataset = load_diabetes(as_frame=True)
    df = dataset.frame.rename(columns={"target": "progression"})

    features = ["bmi", "bp", "s5"]
    missing_count = int(df[features + ["progression"]].isna().sum().sum())

    # statsmodels 需要显式加入截距项
    x = sm.add_constant(df[features])
    model = sm.OLS(df["progression"], x).fit()

    print(f"samples={len(df)}")
    print(f"missing={missing_count}")
    print(f"r_squared={model.rsquared:.3f}")
    print(f"adjusted_r_squared={model.rsquared_adj:.3f}")

    for name in ["const", *features]:
        coefficient = model.params[name]
        p_value = model.pvalues[name]
        print(
            f"{name}: coefficient={coefficient:.3f}, "
            f"p_value={p_value:.3e}"
        )

    # 左图观察单变量关系,右图检查残差是否出现明显结构
    figure, axes = plt.subplots(1, 2, figsize=(10, 4))
    axes[0].scatter(df["bmi"], df["progression"], alpha=0.6)
    axes[0].set_xlabel("standardized bmi")
    axes[0].set_ylabel("progression")
    axes[0].set_title("BMI and progression")

    axes[1].scatter(model.fittedvalues, model.resid, alpha=0.6)
    axes[1].axhline(0, linewidth=1)
    axes[1].set_xlabel("fitted values")
    axes[1].set_ylabel("residuals")
    axes[1].set_title("Residual diagnostic")

    output_path = Path("diabetes_analysis.png")
    figure.tight_layout()
    figure.savefig(output_path, dpi=150)
    print(f"chart={output_path.name}")

if __name__ == "__main__":
    main()
预期输出如下。不同依赖版本可能产生末位舍入差异,但样本数、变量方向和主要结论应保持一致。
samples=442
missing=0
r_squared=0.480
adjusted_r_squared=0.477
const: coefficient=152.133, p_value=9.693e-206
bmi: coefficient=603.078, p_value=5.551e-19
bp: coefficient=262.272, p_value=3.743e-05
s5: coefficient=543.871, p_value=5.557e-16
chart=diabetes_analysis.png
运行后还会生成 diabetes_analysis.png。左图用于观察 bmi 与进展指标的总体关系,右图用于检查拟合值与残差。如果残差呈明显弧形、漏斗形或存在极端点,应进一步考虑非线性项、方差不齐处理或异常值敏感性分析。
从统计结果到结论
模型的 ,表示这三个变量共同解释了样本中约 48% 的进展指标变异。它说明模型具有一定解释力,但仍有超过一半的变异未被当前变量解释,因此不能把模型当作完整医学预测工具。
三个自变量的系数均为正,且 p 值小于 0.05。在其他入模变量保持不变的条件下,较高的标准化 bmi、bp 和 s5 与较高的疾病进展指标相关。其中 bmi 的系数最大,但不能只凭系数大小断言它是“最重要原因”;变量相关性、量纲处理、遗漏变量和模型设定都会影响系数。
规范结论可以写成:本样本中,bmi、bp 和 s5 均与疾病进展指标呈显著正向关联,三变量模型解释约 48% 的样本变异。该结果支持进一步研究这些指标的预测价值,但由于分析属于观察性关联,且未纳入全部潜在影响因素,不能据此作出因果判断或临床决策。
结果汇报与验收
一份合格的项目汇报应让读者能够回答“为什么分析、用了什么数据、如何分析、得到什么证据、结论有哪些限制”。正文可按问题定义、数据说明、方法与假设、核心结果、图形诊断、结论与限制六部分组织,并在附录保留可运行脚本。
交付前逐项验收:问题必须能对应因变量和自变量;数据检查不能只写“已清洗”;每个结论都要能追溯到输出或图形;显著性不能替代实际意义;观察性数据不得写成因果关系;图表标题、坐标和文件名应清楚。只要其中一项无法复核,项目就还没有真正完成。