
高等数学 / 系统课时
置换检验
置换检验
当样本量较小、总体分布难以判断,或传统参数检验的条件不可靠时,可以用置换检验直接从现有数据构造零假设下的参考分布。本课将从“标签可交换”出发,完成一次组间均值差的精确枚举与随机重排实现。
学习目标
- 理解置换检验中“标签可交换”的含义
- 能够根据观测统计量构造置换分布并计算 值
- 能够用随机重排实现双侧两独立样本检验
核心思想:零假设下标签可交换
设两组数据分别来自处理组和对照组。零假设认为组别处理没有造成系统性差异,因此在控制实验设计条件后,观测值与组别标签可以交换。置换检验保留全部观测值不变,只重新分配标签,并在每次分配后重新计算统计量。
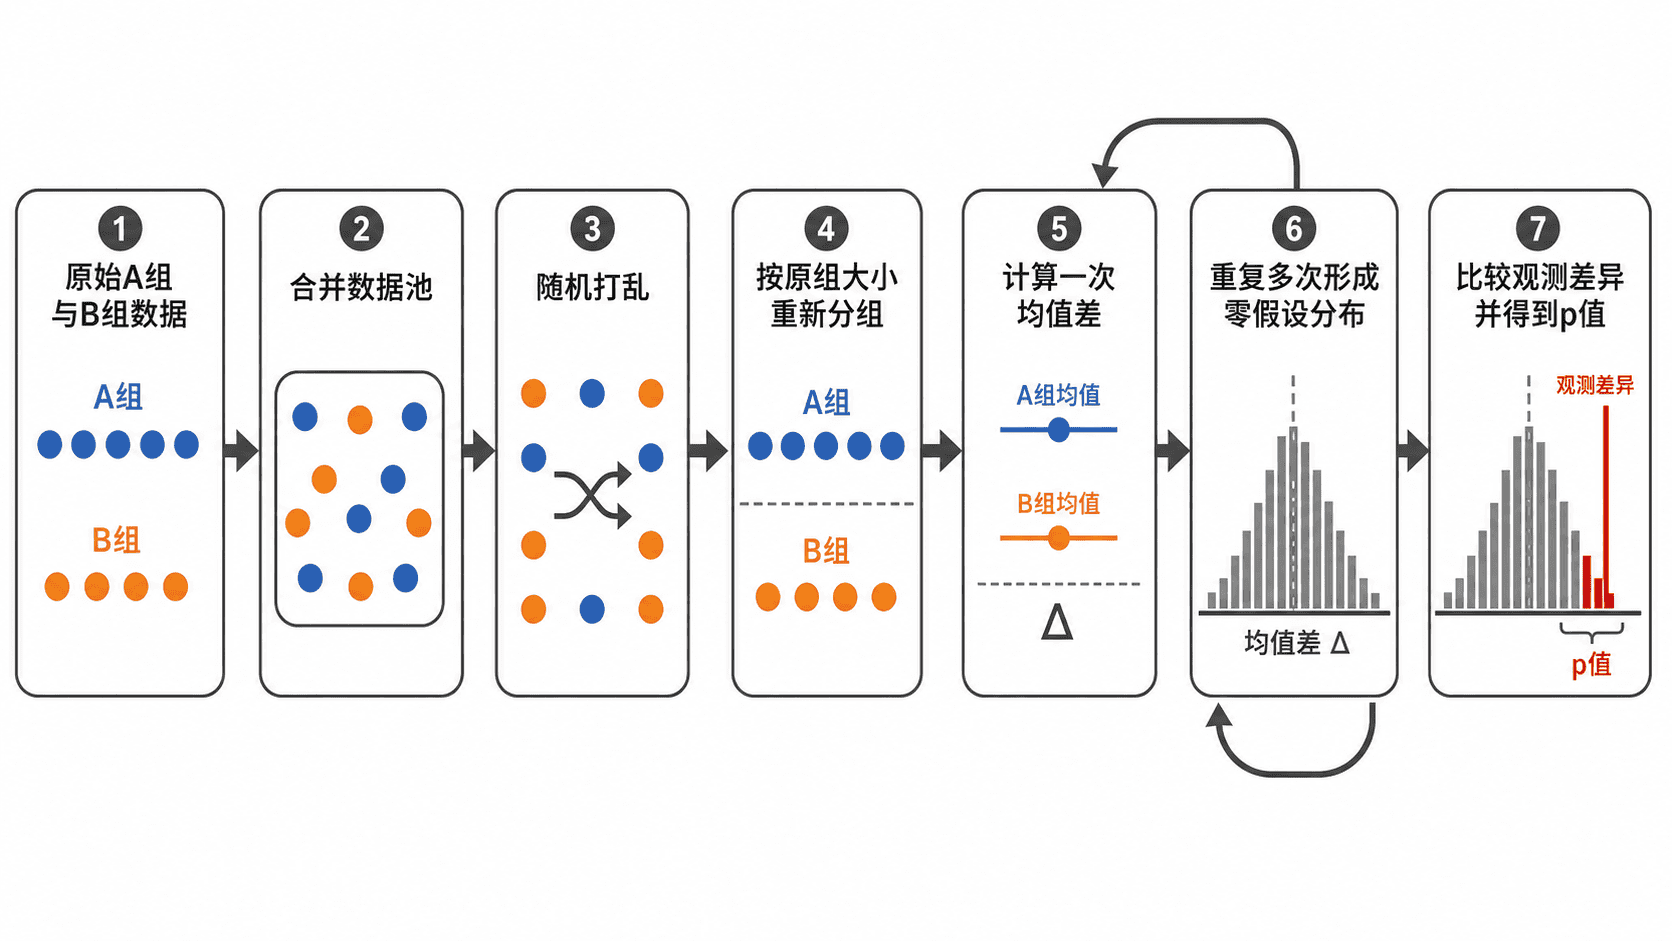
常用统计量可以是均值差、中位数差、相关系数或模型系数。检验的关键不是某个固定公式,而是统计量必须与研究问题一致,并且每次重排都按同一规则计算。
从精确枚举到随机重排
设 A 组为 ,B 组为 ,观测到的双侧统计量为均值差绝对值:
合并后共有 4 个观测,从中选择 2 个分给 A 组,共有 种不同分法。六种均值差依次为 ,其中绝对值不小于 4 的有 2 种,因此精确双侧 值为:
数据量增大后,全部枚举可能非常昂贵。此时可随机重排 次,并使用加一修正:
其中 是置换统计量至少与观测统计量同样极端的次数。加一修正可避免有限次随机模拟得到不合理的零 值。
下面的完整 Python 示例固定随机种子,进行 100000 次随机重排。实际项目中,迭代次数越多,蒙特卡洛误差通常越小,但运行时间也会增加。
import random
from statistics import mean

group_a = [8, 9]
group_b = [4, 5]
observed = abs(mean(group_a) - mean(group_b))

pool = group_a + group_b
iterations = 100000
extreme_count = 0

# 固定随机种子,使教学示例可以重复得到相同结果
random.seed(42)

for _ in range(iterations):
    shuffled = pool[:]
    random.shuffle(shuffled)

    perm_a = shuffled[:len(group_a)]
    perm_b = shuffled[len(group_a):]
    statistic = abs(mean(perm_a) - mean(perm_b))

    # 双侧检验比较统计量的绝对值
    if statistic >= observed:
        extreme_count += 1

p_value = (extreme_count + 1) / (iterations + 1)

print(f"observed difference: {observed:.1f}")
print(f"extreme count: {extreme_count}")
print(f"p-value: {p_value:.6f}")
预期输出
observed difference: 4.0
extreme count: 33379
p-value: 0.333797
模拟结果接近精确值 。由于随机重排只抽取全部可能分法中的一部分,不同随机种子可能产生略有差异的结果;报告时应同时说明统计量、置换次数、单侧或双侧方向以及随机种子。
正确使用的边界
独立两组置换要求观测之间相互独立,并且在零假设下组别标签确实可交换。配对实验不能把所有观测任意混合,而应在每一对内部交换标签或对差值随机翻转符号。
检验方向必须在查看结果前确定。双侧检验比较“至少同样极端”的绝对统计量,单侧检验则只统计预先指定方向。若样本存在分层、时间序列或聚类结构,重排也必须保留这些结构,否则得到的参考分布会失真。