
高等数学 / 系统课时
分析工具与可重复计算
分析工具与可重复计算
本课解决两个实际问题:面对同一份数据时如何选择合适的分析工具,以及怎样让别人按相同步骤得到相同结果。完成后,你将能把一次临时计算整理成可检查、可重跑、可追溯的分析过程。
学习目标
- 区分电子表格、Python 与专业统计工具的适用场景
- 理解可重复分析所需的数据、代码、环境和输出记录
- 使用一个完整 Python 示例固化计算并验证结果
根据任务选择分析工具
电子表格适合数据量较小、需要人工查看和快速制作透视表的任务。它的优势是上手快,但公式可能分散在单元格中,复制、排序或手工修改也容易改变结果,因此重要分析应保留原始文件和清晰的计算区域。
Python 适合需要重复运行、批量处理、自动清洗或与系统集成的任务。代码能明确记录每一步操作,也便于版本管理。专业统计软件则适合成熟的统计检验、调查分析或组织已经统一使用某套工具的场景。
| 场景 | 更合适的工具 | 主要原因 |
|---|---|---|
| 临时整理几十行数据 | 电子表格 | 查看和修改直观 |
| 每周重复生成同一报表 | Python | 可自动运行并减少手工操作 |
| 规范化统计检验 | 专业统计工具或 Python/R | 方法完整,结果便于审查 |
可重复分析的最小链路
一次分析要能重复,至少要固定四类信息:原始数据、处理步骤、运行环境和最终输出。只保存截图或结论不够,因为后来无法确认数据是否变化,也无法知道中间做过哪些筛选与转换。
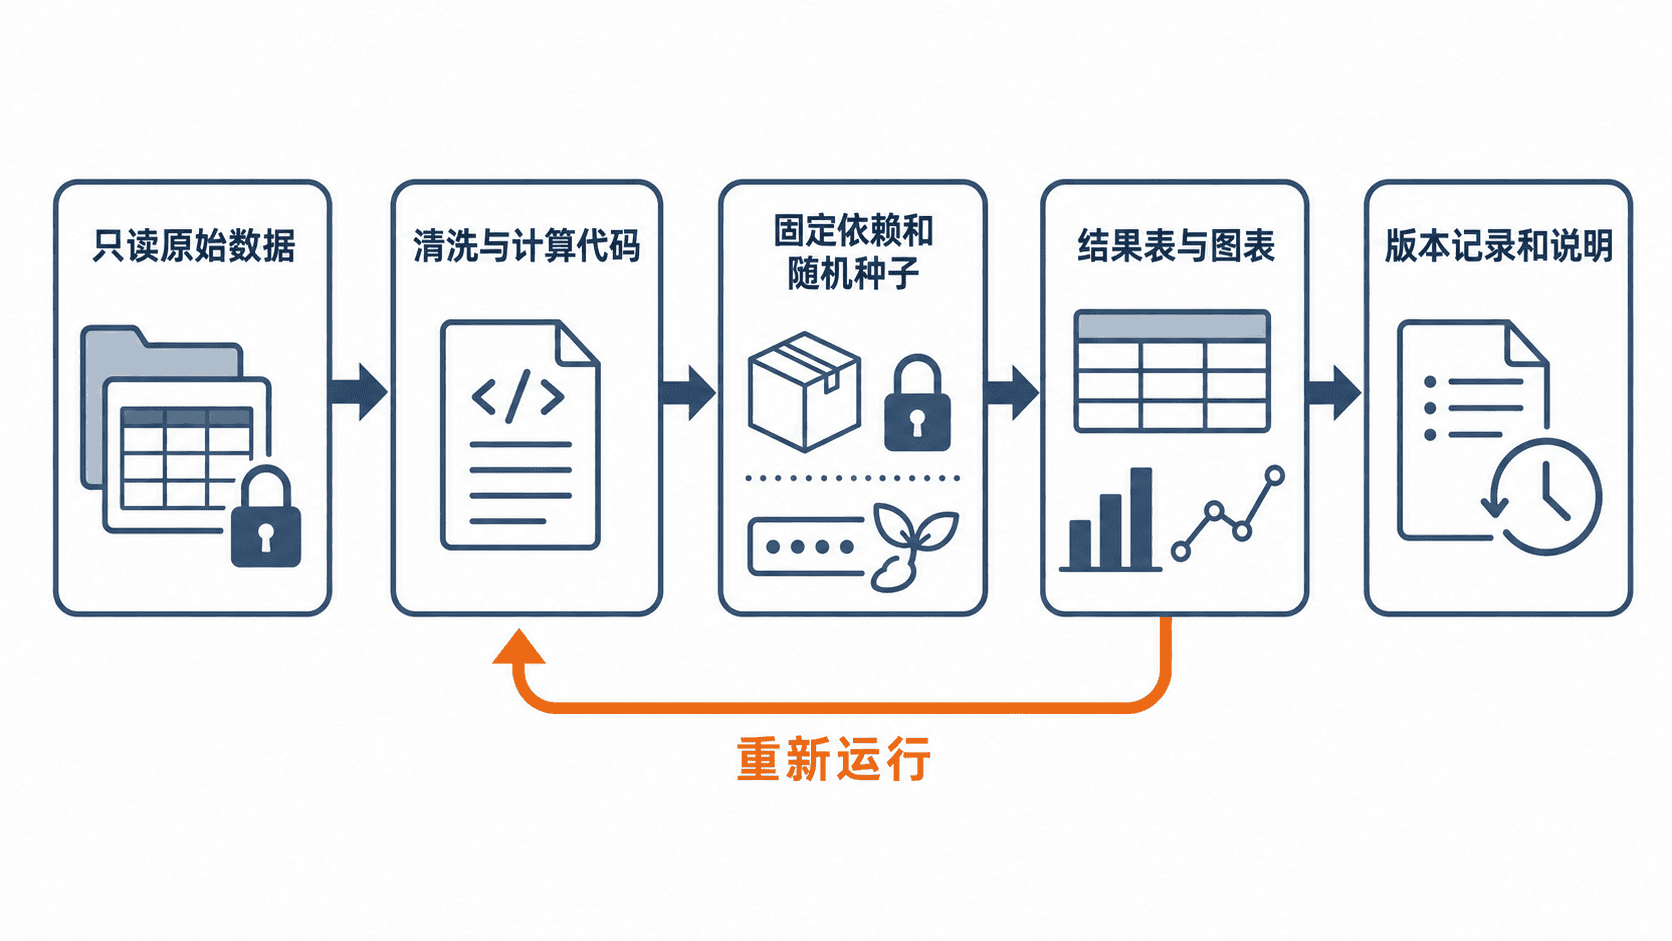
实践中应把原始数据设为只读,清洗后的数据另行输出;把计算步骤写进脚本或明确的表格公式;记录 Python 与依赖版本;最后保存结果和运行日期。涉及随机抽样或模拟时,还要固定随机种子。
用 Python 固化一次计算
下面的程序只使用 Python 标准库。数据写在字符串中,便于直接运行;真实项目中可替换为受版本管理的 CSV 文件。程序同时计算样本数、均值、中位数,并生成输入指纹,用于判断原始内容是否改变。
import csv
import hashlib
import io
import statistics

SOURCE = """name,score
A,72
B,85
C,85
D,98
"""

rows = list(csv.DictReader(io.StringIO(SOURCE)))
scores = [int(row["score"]) for row in rows]

# 输入指纹用于快速发现源数据是否被修改
fingerprint = hashlib.sha256(SOURCE.encode("utf-8")).hexdigest()[:12]

print(f"样本数: {len(scores)}")
print(f"均值: {statistics.mean(scores):.1f}")
print(f"中位数: {statistics.median(scores):.1f}")
print(f"输入指纹: {fingerprint}")
预期输出如下:
样本数: 4
均值: 85.0
中位数: 85.0
输入指纹: 925b38fb7b9c
若再次运行得到相同指纹和统计量,说明输入与计算逻辑没有变化。实际项目中的路径、时间和文件名可能不同,但应通过配置传入,而不是在多个位置手工修改。
建立可重复分析习惯
提交分析结果时,建议同时保存原始数据来源、脚本或公式、运行说明和结果文件。运行说明至少写清使用的工具版本、启动命令、输入位置和输出位置。
不要在原始数据上直接删除异常值,也不要只记录“已清洗”。应明确记录筛选条件,例如“删除缺失分数的记录”,并输出清洗前后的行数。这样才能区分正常的数据处理与无意的数据丢失。