
高等数学 / 系统课时
统计分析常见错误
统计分析常见错误
统计分析的主要风险往往不在计算公式,而在样本形成、变量选择、模型训练和结果解释。识别这些错误,可以避免得到“数字正确、结论错误”的分析结果。
学习目标
- 识别选择偏差、混杂变量和过度拟合
- 区分相关关系与因果关系
- 用检查清单减少结果挑选和解释偏差
从分析链条定位错误
统计错误可以按数据、方法和解释三个阶段定位。数据阶段决定样本是否代表目标总体,方法阶段决定模型是否真正学到规律,解释阶段决定结论是否超出证据范围。
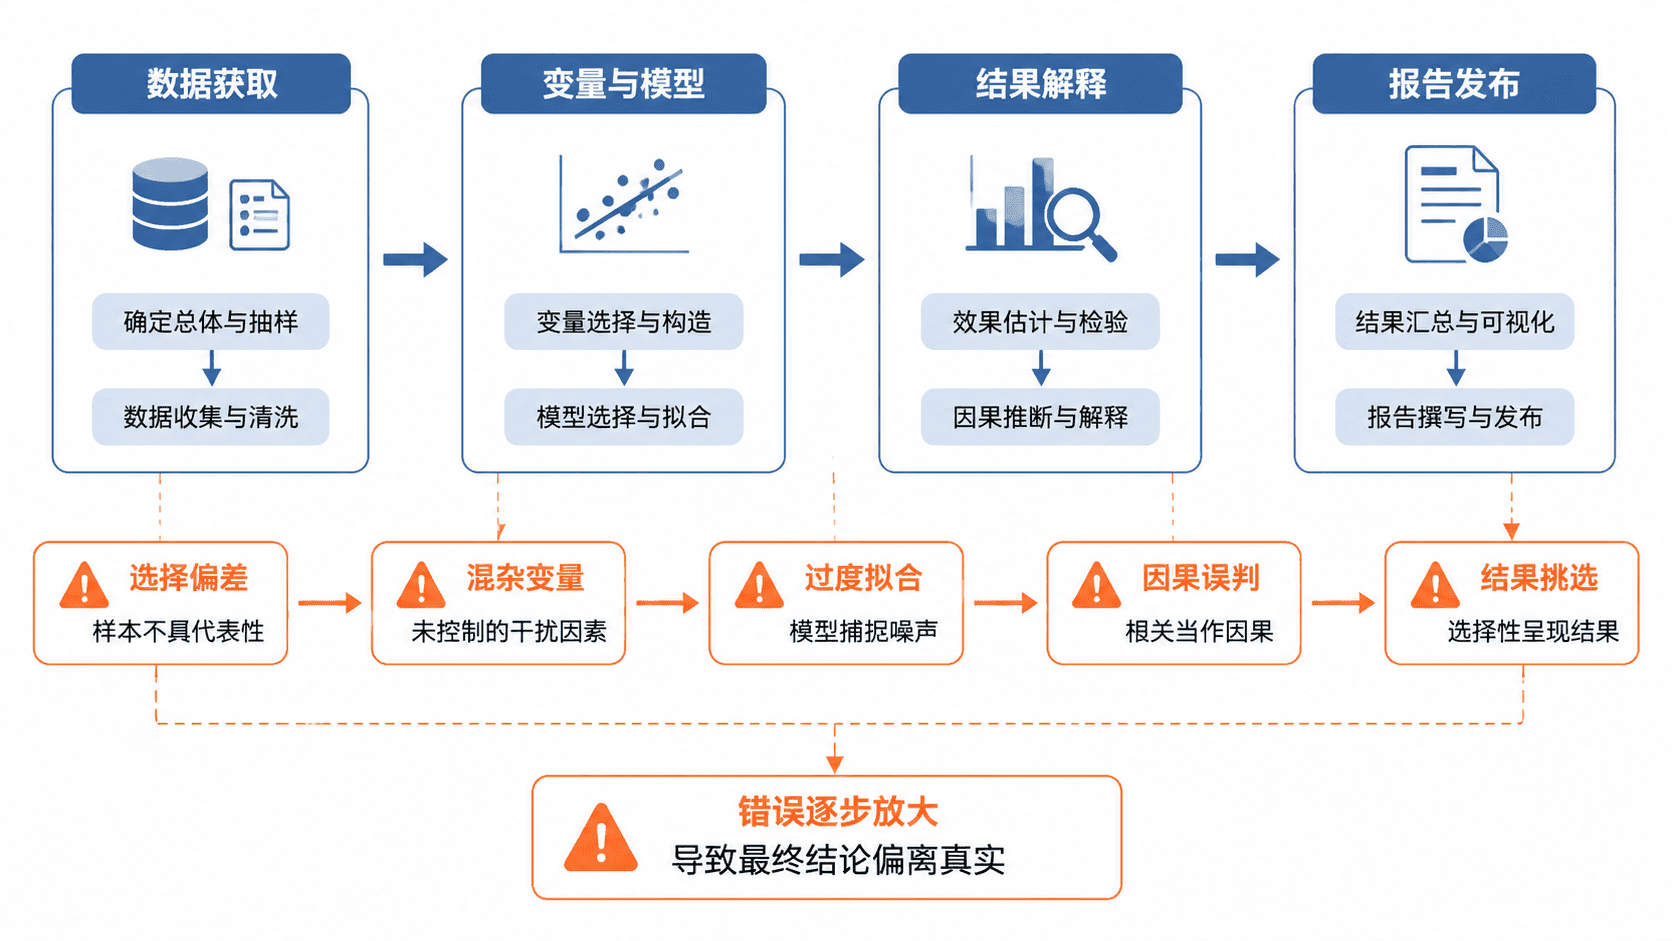
定位时不要先问“用了什么高级模型”,而要先问“样本如何进入数据集”“变量之间是否还有共同原因”“结论是否在新数据上成立”。这些问题通常比更换算法更重要。
选择偏差:样本不是总体的缩影
选择偏差发生在进入样本的概率与研究目标有关时。例如,只调查活跃用户对产品的满意度,会系统性遗漏已经流失的用户,从而高估整体满意度。
判断选择偏差时,应比较目标总体与实际样本的来源、时间范围、渠道和关键特征。扩大样本量不能自动修复偏差;如果抽样机制有问题,更大的样本只会更稳定地得到错误结论。
常见修复方法包括改进随机抽样、补充缺失群体、使用分层权重,并在报告中明确结论适用范围。
混杂变量:第三个因素同时影响两端
混杂变量同时影响自变量和结果变量,会让两者看起来存在直接关系。例如,冰淇淋销量与溺水事件同时上升,并不表示前者导致后者;高温可能同时推动两者变化。
处理混杂不能只依赖相关系数。应结合研究设计、领域知识和因果路径,决定是否分层、匹配、回归控制或开展随机实验。
即使模型已经加入多个控制变量,也不能宣称所有混杂都被消除。未观测变量、测量误差和错误的控制变量选择仍可能造成偏差。
过度拟合:模型记住样本噪声
过度拟合表现为训练数据效果很好,但在新数据上明显下降。常见原因包括模型过复杂、特征过多、样本过少,以及反复依据测试集调整模型。
应将数据划分为训练集、验证集和测试集,或使用交叉验证评估泛化能力。最终测试集只用于一次独立评估,不能在每轮调参后反复查看。
降低复杂度、增加正则化、减少无效特征和收集更多代表性数据,通常比继续堆叠模型更有效。
因果误判与结果挑选
相关关系只能说明变量共同变化,不能单独证明因果。因果结论通常需要随机实验、自然实验、时间顺序和机制证据等更强设计支持。
结果挑选是指尝试多种指标、分组、时间窗口或模型后,只报告显著结果。这样会抬高假阳性概率,即使每次检验都使用相同显著性水平。
可以通过预先注册分析方案、明确主指标、记录全部尝试、实施多重比较校正,以及同时报告不显著结果来降低风险。
用检查清单完成最终复核
交付分析前,可以依次检查以下问题:
- 样本是否覆盖目标总体,是否遗漏关键群体
- 是否存在同时影响解释变量和结果变量的因素
- 模型在独立数据上的表现是否稳定
- 因果措辞是否超过研究设计能够支持的范围
- 是否完整披露尝试过的指标、分组和模型
若任一问题无法回答,应在结论中降低确定性,并把缺失证据写进限制部分,而不是用更强措辞掩盖不确定性。