高等数学 / 系统课时

两总体参数的区间估计

两总体参数的区间估计

比较两个总体时,真正关心的通常不是各自参数,而是均值差或比例差。本课将先判断样本关系与参数类型,再选择标准误和临界分布,最终构造并解释差值的置信区间。

学习目标

  • 根据独立样本、配对样本和参数类型选择区间公式
  • 构造两个总体均值差或比例差的置信区间
  • 正确解释区间是否包含零以及差值方向

先判断数据结构

两总体区间估计统一写成“点估计 ±\pm 临界值 ×\times 标准误”,但标准误和临界值取决于数据结构。首先判断观测是否独立,再区分估计均值差还是比例差;若估计均值差,还要判断总体方差是否已知以及能否认为方差相等。
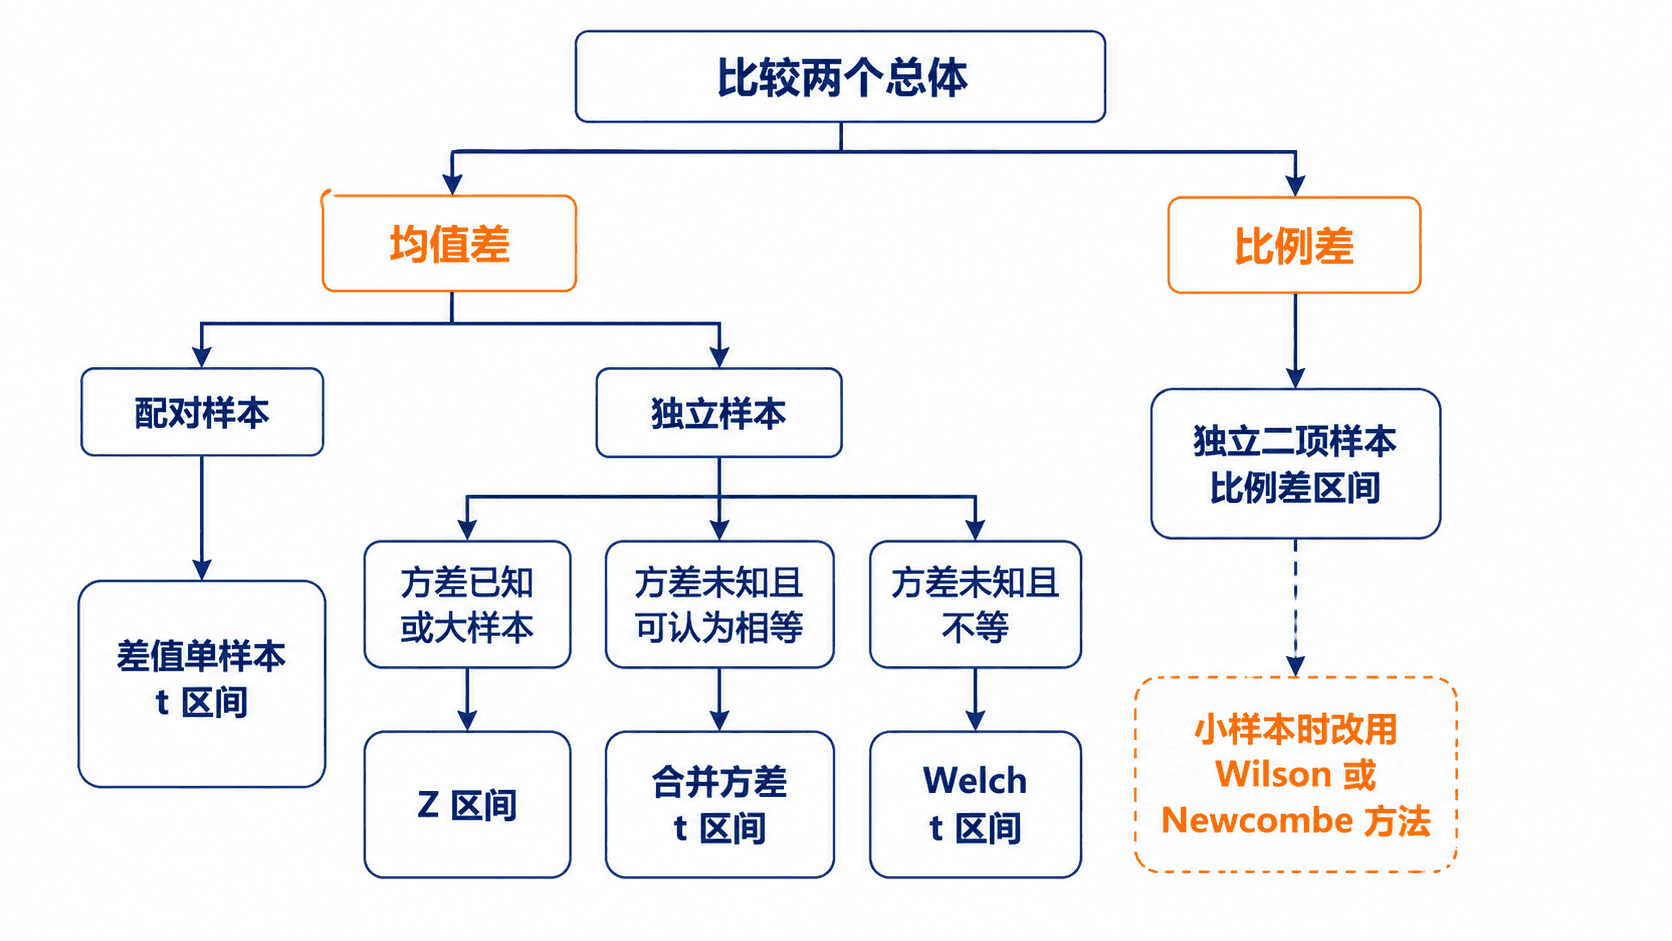
两总体参数置信区间选择流程

区间中差值的顺序必须预先固定。例如估计 μ1−μ2\mu_1-\mu_2,点估计、标准误和最终解释都要保持“总体 1 减总体 2”,不能在计算中途交换顺序。

两总体均值差

独立样本且方差已知

若两个总体独立,且总体方差 σ12\sigma_1^2、σ22\sigma_2^2 已知,则 μ1−μ2\mu_1-\mu_2 的置信区间为

(Xˉ1−Xˉ2)±z1−α/2σ12n1+σ22n2(\bar X_1-\bar X_2)\pm z_{1-\alpha/2}\sqrt{\frac{\sigma_1^2}{n_1}+\frac{\sigma_2^2}{n_2}}

总体方差未知但两个样本都足够大时,常用 S12S_1^2、S22S_2^2 代替总体方差,得到大样本近似区间。

方差未知且可认为相等

若两个正态总体方差相等,可先计算合并方差。

Sp2=(n1−1)S12+(n2−1)S22n1+n2−2S_p^2=\frac{(n_1-1)S_1^2+(n_2-1)S_2^2}{n_1+n_2-2}

再使用自由度 n1+n2−2n_1+n_2-2 的 tt 分布:

(Xˉ1−Xˉ2)±t1−α/2,n1+n2−2Sp1n1+1n2(\bar X_1-\bar X_2)\pm t_{1-\alpha/2,n_1+n_2-2}S_p\sqrt{\frac{1}{n_1}+\frac{1}{n_2}}

方差未知且不等

不应强行合并方差,而应使用 Welch 区间:

(Xˉ1−Xˉ2)±t1−α/2,νS12n1+S22n2(\bar X_1-\bar X_2)\pm t_{1-\alpha/2,\nu}\sqrt{\frac{S_1^2}{n_1}+\frac{S_2^2}{n_2}}

其中自由度采用 Welch–Satterthwaite 近似:

ν=(S12/n1+S22/n2)2(S12/n1)2n1−1+(S22/n2)2n2−1\nu=\frac{\left(S_1^2/n_1+S_2^2/n_2\right)^2}{\frac{(S_1^2/n_1)^2}{n_1-1}+\frac{(S_2^2/n_2)^2}{n_2-1}}

配对样本

若同一对象在两个条件下被重复测量,应先定义差值 Di=Xi−YiD_i=X_i-Y_i,再对差值样本做单总体均值区间:

Dˉ±t1−α/2,n−1SDn\bar D\pm t_{1-\alpha/2,n-1}\frac{S_D}{\sqrt n}

配对设计利用了个体内关联,不能误用两个独立样本公式。

两总体比例差

设两个独立样本中成功次数分别为 x1x_1、x2x_2,样本比例为 p^1=x1/n1\hat p_1=x_1/n_1、p^2=x2/n2\hat p_2=x_2/n_2。当每组的成功和失败数量都足够大时,p1−p2p_1-p_2 的常用近似区间为

(p^1−p^2)±z1−α/2p^1(1−p^1)n1+p^2(1−p^2)n2(\hat p_1-\hat p_2)\pm z_{1-\alpha/2}\sqrt{\frac{\hat p_1(1-\hat p_1)}{n_1}+\frac{\hat p_2(1-\hat p_2)}{n_2}}

构造置信区间时,两组比例分别估计各自方差,不使用假设检验中“两个比例相等”前提下的合并比例。若成功或失败次数很少,普通正态近似可能越过 [−1,1][-1,1] 或覆盖率不足,应改用 Wilson、Newcombe 或精确方法。

完整例题

方案 A 有 200200 名用户,其中 120120 人完成转化;方案 B 有 180180 名用户,其中 9090 人完成转化。估计两方案总体转化率之差 pA−pBp_A-p_B 的 95%95\% 置信区间。

样本比例为 p^A=0.60\hat p_A=0.60、p^B=0.50\hat p_B=0.50,点估计为 0.100.10。标准误为

SE=0.60×0.40200+0.50×0.50180≈0.0509SE=\sqrt{\frac{0.60\times0.40}{200}+\frac{0.50\times0.50}{180}}\approx0.0509

取 z0.975=1.96z_{0.975}=1.96,误差界约为 1.96×0.0509=0.09971.96\times0.0509=0.0997,因此

pA−pB∈[0.10−0.0997,0.10+0.0997]≈[0.0003,0.1997]p_A-p_B\in[0.10-0.0997,0.10+0.0997]\approx[0.0003,0.1997]

区间几乎贴近零,说明方案 A 的转化率可能只略高,也可能高出约 2020 个百分点。虽然本次区间未包含零,但下限非常接近零,仍应结合样本质量、业务成本和实际提升幅度判断是否值得采用。

选择与解释边界

独立样本和配对样本的区别比样本量大小更优先。只要观测存在一一对应关系,就应先计算差值;忽略配对会丢失关联信息,并可能扩大标准误。

区间包含零,表示数据与“两个总体参数相等”相容;不包含零,表示差异在相应双侧显著性水平下具有统计证据。但统计显著不等于实际重要,仍需检查区间宽度和业务上可接受的最小差异。

按自己的节奏,确认真正理解。

目录与阅读设置

阅读设置

17

记录一个想法

两总体参数的区间估计

0 / 10000 · 笔记保存到账号。未提交的修改会在关闭、离开或刷新后丢失。

登录哪都通