
高等数学 / 系统课时
数据质量检查
数据质量检查
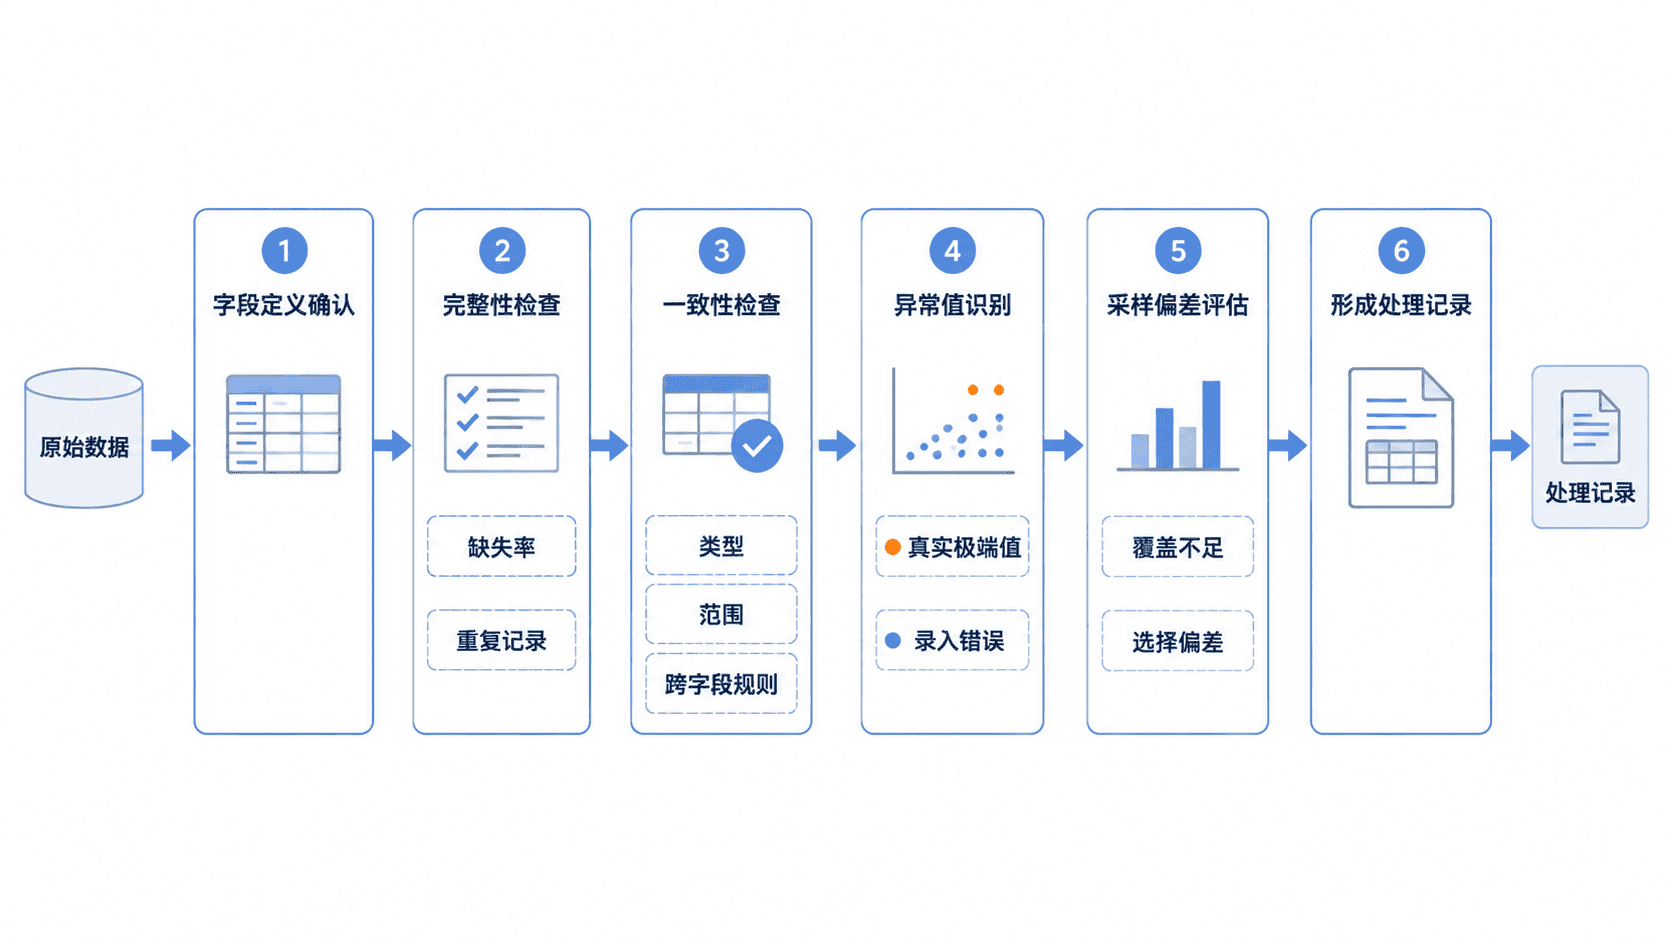
数据质量检查的目标不是“把数据洗干净”这么简单,而是确认数据能否支持后续统计结论。本课将用一套可复用的顺序检查完整性、一致性、异常值与采样偏差,并通过 Python 输出一份可核对的质量报告。
学习目标
- 能按完整性、一致性、异常值和采样偏差四个维度检查数据
- 能区分真实极端值、录入错误和缺失机制
- 能用 Python 生成基础数据质量报告并解释结果
先明确检查对象
数据质量检查应围绕“分析目标”展开。若目标是比较不同渠道的平均订单金额,关键字段至少包括订单金额、渠道、时间和样本来源;与目标无关的备注字段即使缺失,也未必影响分析。
检查前先确认三件事:一行代表什么观测单位、每个字段的业务含义是什么、哪些规则必须成立。只有先定义规则,后续发现的异常才有判断依据。
完整性与唯一性
完整性关注“该有的数据是否存在”。常见指标包括字段缺失率、主键空值、重复记录数量,以及时间序列是否出现断档。缺失率可写为:
缺失不一定可以直接删除。若缺失集中在某个地区、设备或时间段,删除后可能改变样本结构。重复记录也要先判断:完全重复通常是导入问题,而同一用户多次交易可能是正常业务行为。
一致性与业务规则
一致性检查分为字段内部和字段之间两类。字段内部规则包括数据类型、允许范围和分类取值,例如年龄不能为负数,渠道只能来自预定义集合。跨字段规则则用于验证逻辑关系,例如退款金额不应大于原订单金额,结束时间不应早于开始时间。
检查发现问题后,不要立即覆盖原值。更稳妥的做法是保留原始数据,新增清洗后的字段或异常标记,并记录处理规则。这样既能复现分析,也便于追查误判。
异常值与潜在偏差
异常值是“偏离大多数观测的值”,但不等于错误。箱线图规则常用四分位距 ,将低于 或高于 的观测标记为可疑值。标记之后仍需结合业务判断。
采样偏差关注数据是否代表目标总体。若调查只来自活跃用户、工作日白天或某一渠道,即使字段完全无缺失,也可能得到系统性偏差。应比较样本与总体在地区、时间、设备、客户类型等关键维度上的覆盖情况。
用 Python 生成质量报告
下面的示例构造一份小型订单数据,依次检查缺失值、重复记录、非法金额、时间逻辑和渠道分布。示例可直接运行,需要安装 pandas。
import pandas as pd

data = [
    {"order_id": "A001", "amount": 120.0, "channel": "APP", "start": "2026-08-01 09:00", "end": "2026-08-01 09:02"},
    {"order_id": "A002", "amount": None, "channel": "WEB", "start": "2026-08-01 10:00", "end": "2026-08-01 09:58"},
    {"order_id": "A003", "amount": -20.0, "channel": "APP", "start": "2026-08-01 11:00", "end": "2026-08-01 11:03"},
    {"order_id": "A003", "amount": -20.0, "channel": "APP", "start": "2026-08-01 11:00", "end": "2026-08-01 11:03"},
]

df = pd.DataFrame(data)
df["start"] = pd.to_datetime(df["start"])
df["end"] = pd.to_datetime(df["end"])

report = {
    "row_count": len(df),
    "missing_amount": int(df["amount"].isna().sum()),
    "duplicate_rows": int(df.duplicated().sum()),
    "invalid_amount": int((df["amount"] < 0).fillna(False).sum()),
    "invalid_time_order": int((df["end"] < df["start"]).sum()),
    "channel_counts": df["channel"].value_counts().to_dict(),
}

for key, value in report.items():
    print(f"{key}: {value}")
预期输出
row_count: 4
missing_amount: 1
duplicate_rows: 1
invalid_amount: 2
invalid_time_order: 1
channel_counts: {'APP': 3, 'WEB': 1}
invalid_amount 为 2,是因为重复记录中的负金额也被重复计数。这说明质量指标之间可能相互影响:应先识别重复,再决定后续统计是基于原始记录还是去重后的记录。
处理结果如何验收
完成修复后,应重新运行同一套规则,并比较处理前后的记录数、缺失率和异常数量。验收重点不是让所有指标归零,而是确保每项保留、修正或删除都有明确原因。
建议保留一张问题清单,至少记录字段、问题类型、发现数量、处理方式和影响范围。若异常无法确认,应标记为“待核实”,不要用均值填补等默认操作掩盖问题。