
高等数学 / 系统课时
概率密度函数
概率密度函数
概率密度函数用一条曲线描述连续随机变量在不同位置附近的集中程度。本课将区分“密度值”和“概率”,掌握密度函数的基本性质,并能通过曲线下面积计算随机变量落入指定区间的概率。
学习目标
- 理解概率密度不是单点概率
- 掌握概率密度函数的两个基本性质
- 会用积分表示并计算区间概率
为什么需要概率密度
连续随机变量可以在某个区间内取无限多个值,例如身高、等待时间和温度。对这类变量,单个精确取值通常没有可观察的概率质量,因此一般有:
这并不表示某个数值“不可能出现”,而是因为概率被分散在连续区间中。概率密度函数 描述的是随机变量在 附近的相对集中程度,真正的概率必须由一个区间对应的面积得到。
密度函数的基本性质
函数 能作为连续随机变量的概率密度函数,需要满足两个条件:
以及:
第一个条件保证密度不会为负,第二个条件表示整条曲线下的总面积为 1。需要注意,密度值本身可以大于 1,只要总面积仍然等于 1。例如分布集中在一个很窄的区间时,曲线可能较高,但区间宽度较小。
用面积计算区间概率
随机变量落入区间 的概率为:
这意味着横轴区间 与密度曲线围成的面积,就是所求概率。对于连续随机变量,端点是否包含不会改变结果,因此 、 和 相等。
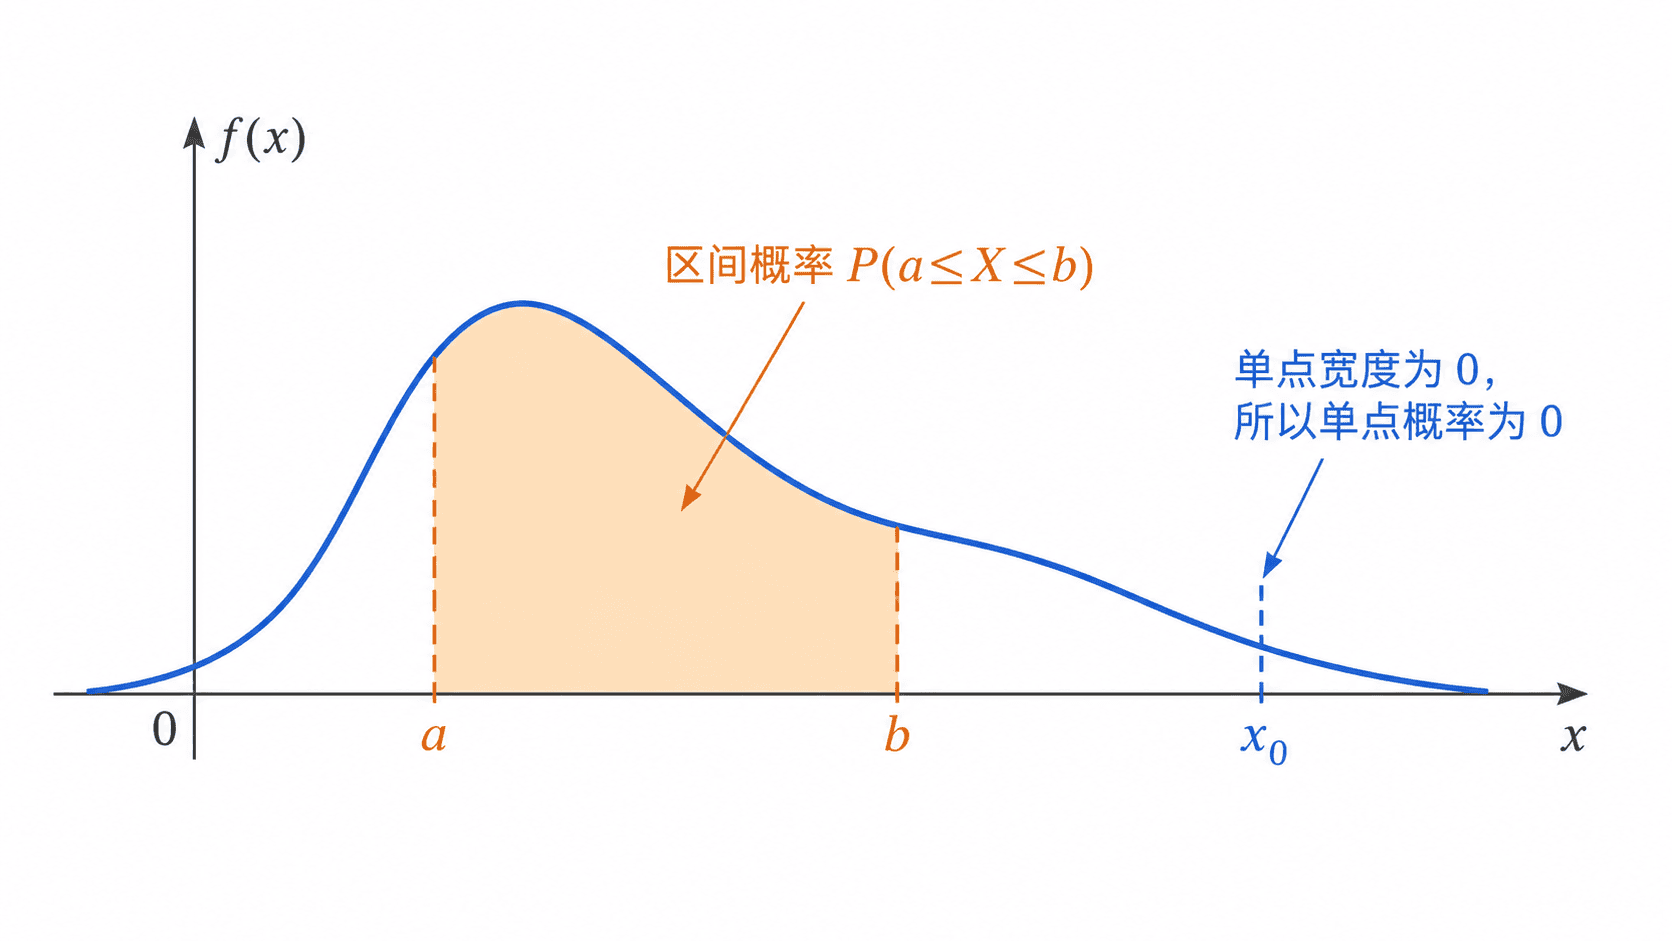
例如,若某随机变量在 上服从均匀分布,其密度为 。它落入 的概率等于矩形面积:
密度值、概率与分布函数
密度较高只表示随机变量在该位置附近更集中,不能直接把 当成 。比较两个区间的概率时,应比较对应面积,而不是只比较某一点的曲线高度。
累计分布函数记为 ,表示随机变量不超过 的概率:
因此,区间概率也可以写成 。密度函数关注局部集中程度,分布函数关注从左侧累计到当前位置的总概率。
按自己的节奏,确认真正理解。