高等数学 / 系统课时

最大似然估计

最大似然估计

最大似然估计把已经观察到的样本视为固定结果,寻找最能使这些结果出现的参数值。本课将从似然函数的含义出发,分别完成伯努利分布和指数分布的估计,并说明对数似然与边界检查为什么不可省略。

学习目标

  • 能把联合概率或联合密度改写为似然函数
  • 能通过求导或边界比较得到最大似然估计量
  • 能区分似然函数、概率函数与参数的后验概率

似然函数在问什么

设观测到独立同分布样本 x1,…,xnx_1,\ldots,x_n,其概率质量函数或密度函数为 f(x;θ)f(x;\theta)。把样本值固定、把参数 θ\theta 当作变量,得到似然函数

L(θ)=∏i=1nf(xi;θ)L(\theta)=\prod_{i=1}^{n}f(x_i;\theta)

最大似然估计就是在参数空间内寻找使 L(θ)L(\theta) 最大的值:

θ^MLE=arg max⁡θL(θ)\hat{\theta}_{MLE}=\operatorname*{arg\,max}_{\theta}L(\theta)

似然函数用于比较不同参数对同一组数据的解释能力,它不是“参数本身的概率分布”。没有引入先验分布时,也不能把似然值直接理解为参数取某个值的概率。
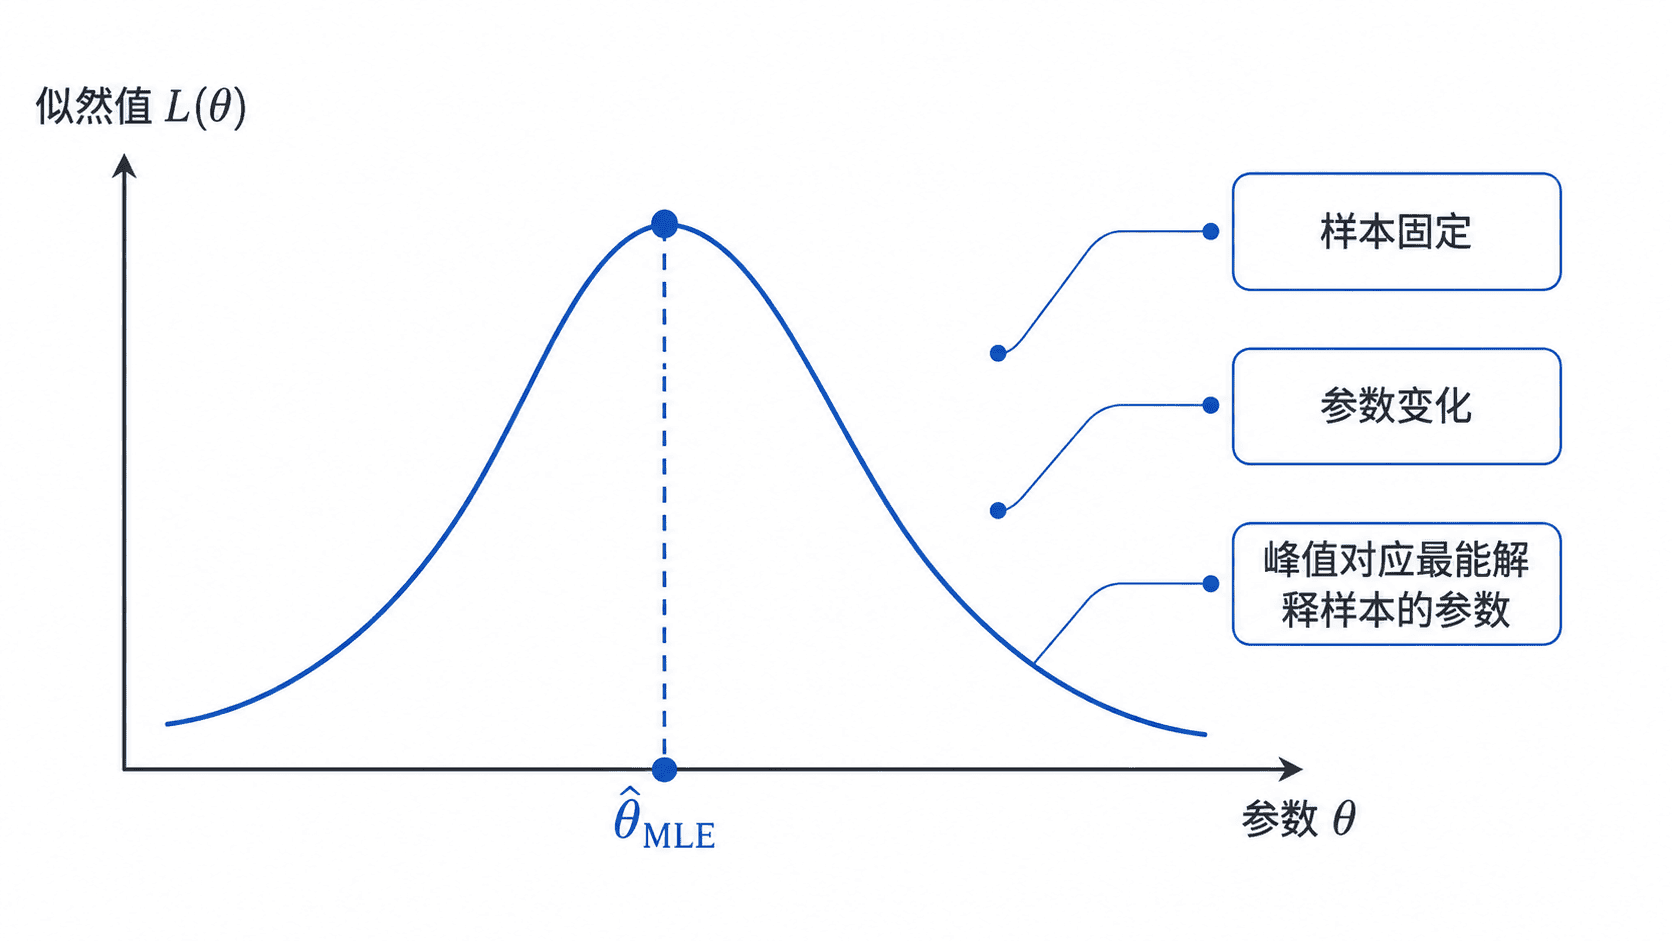
最大似然估计的峰值含义

离散模型:伯努利分布

设 Xi∼Bernoulli⁡(p)X_i\sim \operatorname{Bernoulli}(p),样本中共有 s=∑i=1nxis=\sum_{i=1}^{n}x_i 次成功。由于每个观测值只能为 00 或 11,似然函数为

L(p)=ps(1−p)n−s,0≤p≤1L(p)=p^s(1-p)^{n-s},\quad 0\le p\le 1

当 0<s<n0<s<n 时,取对数得到

ℓ(p)=sln⁡p+(n−s)ln⁡(1−p)\ell(p)=s\ln p+(n-s)\ln(1-p)

令导数为零:

ℓ′(p)=sp−n−s1−p=0\ell'(p)=\frac{s}{p}-\frac{n-s}{1-p}=0

解得

p^MLE=sn=xˉ\hat{p}_{MLE}=\frac{s}{n}=\bar{x}

若样本全为 00,最大值出现在边界 p=0p=0;若样本全为 11,最大值出现在边界 p=1p=1。这说明最大似然估计不能只会求驻点,还要检查参数空间边界。

连续模型与关键边界

若 Xi∼Exp⁡(λ)X_i\sim \operatorname{Exp}(\lambda),其密度为 f(x;λ)=λe−λxf(x;\lambda)=\lambda e^{-\lambda x},其中 x≥0x\ge 0、λ>0\lambda>0。似然函数为

L(λ)=λne−λ∑i=1nxiL(\lambda)=\lambda^n e^{-\lambda\sum_{i=1}^{n}x_i}

取对数后得到

ℓ(λ)=nln⁡λ−λ∑i=1nxi\ell(\lambda)=n\ln\lambda-\lambda\sum_{i=1}^{n}x_i

令一阶导数为零,可得

λ^MLE=n∑i=1nxi=1xˉ\hat{\lambda}_{MLE}=\frac{n}{\sum_{i=1}^{n}x_i}=\frac{1}{\bar{x}}

二阶导数为 −n/λ2<0-n/\lambda^2<0,因此该驻点确为极大值。实际计算通常优先最大化对数似然,因为乘积会变成求和,既便于求导,也能降低大量小概率相乘导致的数值下溢。

当分布的支持区间也依赖参数时,例如 U(0,θ)U(0,\theta),必须把样本必须落在区间内的条件写入似然函数。此时最大值常出现在边界,而不是一阶导数等于零的位置。

按自己的节奏,确认真正理解。

目录与阅读设置

阅读设置

17

记录一个想法

最大似然估计

0 / 10000 · 笔记保存到账号。未提交的修改会在关闭、离开或刷新后丢失。

登录哪都通