
高等数学 / 系统课时

矩与矩母函数

矩与矩母函数

均值和方差只能描述分布的部分特征。本课把它们统一到“矩”的框架中,并说明矩母函数如何用一个函数集中编码各阶原点矩,最终能从导数中读出均值、方差等信息。

学习目标

  • 区分原点矩与中心矩,并理解常见阶数的含义
  • 掌握矩母函数的定义及由导数求矩的方法
  • 能用伯努利分布验证均值和方差

从数字特征到矩

随机变量的均值、方差、偏度和峰度,本质上都来自不同阶数的幂次期望。把这些量统一写成“矩”,可以用同一套语言描述分布的位置、离散程度和形状。
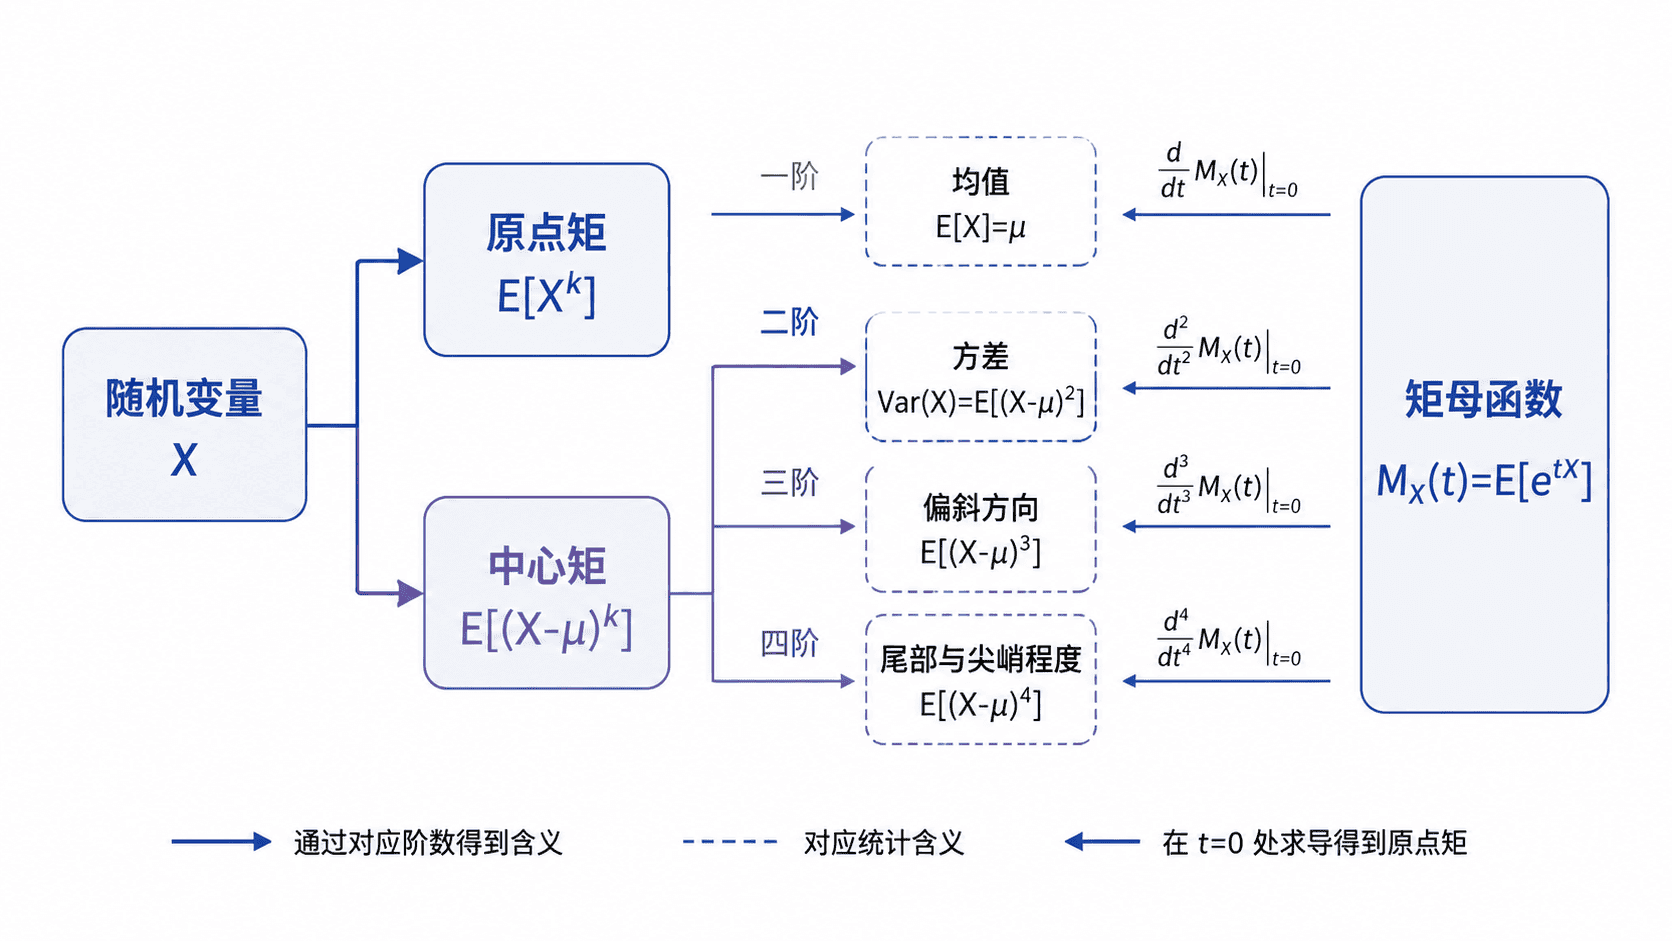
原点矩、中心矩与矩母函数的关系

原点矩与中心矩

随机变量 XX 的 kk 阶原点矩定义为:

αk=E[Xk]\alpha_k=E[X^k]

它直接对 XX 的幂取期望。一阶原点矩就是均值,即 α1=E[X]\alpha_1=E[X]。kk 阶中心矩则以均值为中心:

μk=E[(X−E[X])k]\mu_k=E[(X-E[X])^k]

一阶中心矩恒为 00,二阶中心矩就是方差。三阶中心矩反映分布向哪一侧拖尾,四阶中心矩可用于描述分布的尖峭和尾部特征。由于高阶矩带有量纲,实际比较偏度、峰度时通常还要做标准化。

矩母函数如何编码各阶矩

随机变量 XX 的矩母函数定义为:

MX(t)=E[etX]M_X(t)=E[e^{tX}]

前提是该期望在 t=0t=0 附近存在。把指数函数展开为幂级数,可以得到:

MX(t)=1+E[X]t+E[X2]2!t2+⋯M_X(t)=1+E[X]t+\frac{E[X^2]}{2!}t^2+\cdots

因此,在允许交换求导与期望的条件下,矩母函数在 00 点的第 kk 阶导数就是 kk 阶原点矩:

MX(k)(0)=E[Xk]M_X^{(k)}(0)=E[X^k]

这也是“矩母函数”名称的来源:它不是另一个独立数字特征,而是生成全部原点矩的工具。

主示例:伯努利分布

设 X∼Bernoulli⁡(p)X\sim\operatorname{Bernoulli}(p),即 P(X=1)=pP(X=1)=p,P(X=0)=1−pP(X=0)=1-p。矩母函数为:

MX(t)=E[etX]=(1−p)e0+pet=1−p+petM_X(t)=E[e^{tX}]=(1-p)e^0+pe^t=1-p+pe^t

对 tt 求导:

MX′(t)=pet,MX′′(t)=petM_X'(t)=pe^t,\qquad M_X''(t)=pe^t

代入 t=0t=0,得到:

E[X]=MX′(0)=p,E[X2]=MX′′(0)=pE[X]=M_X'(0)=p,\qquad E[X^2]=M_X''(0)=p

再利用 Var⁡(X)=E[X2]−E[X]2\operatorname{Var}(X)=E[X^2]-E[X]^2,可得:

Var⁡(X)=p−p2=p(1−p)\operatorname{Var}(X)=p-p^2=p(1-p)

这个例子说明:先由矩母函数取得原点矩,再组合出方差,是一种统一而直接的计算路径。

使用边界与易混淆点

原点矩围绕 00 计算,中心矩围绕均值计算,两者不要混用。方差是二阶中心矩,而不是二阶原点矩;只有当 E[X]=0E[X]=0 时,两者才相等。

矩母函数也不一定存在。例如某些重尾分布的 E[etX]E[e^{tX}] 在 t=0t=0 任一侧都会发散。只有当矩母函数在 00 的某个邻域内存在时,才可以安全使用“求导得到各阶矩”,并且此时矩母函数能够唯一确定分布。

按自己的节奏,确认真正理解。

目录与阅读设置

阅读设置

17

记录一个想法

矩与矩母函数

0 / 10000 · 笔记保存到账号。未提交的修改会在关闭、离开或刷新后丢失。

登录哪都通