
高等数学 / 系统课时
t分布
t分布
t 分布解决的是一个常见问题:总体标准差未知时,样本均值还能怎样完成标准化。它与标准正态分布形状相近,但尾部更厚;样本量越大,这种差异越小。
学习目标
- 理解 t 分布的构造条件与自由度
- 解释 t 分布为什么比标准正态分布尾部更厚
- 判断何时应使用 t 分布而不是标准正态分布
t 分布怎样产生
设 ,,并且 与 相互独立。定义
那么 服从自由度为 的 t 分布,记作 。分子是标准正态变量,分母则来自卡方变量的随机缩放,因此 t 变量可以看成“标准正态变量除以一个会波动的标准差估计”。
t 分布关于零对称,取值范围是整个实数轴。它的中心和标准正态分布相同,但由于分母本身具有随机性,出现较大正值或负值的概率会更高。
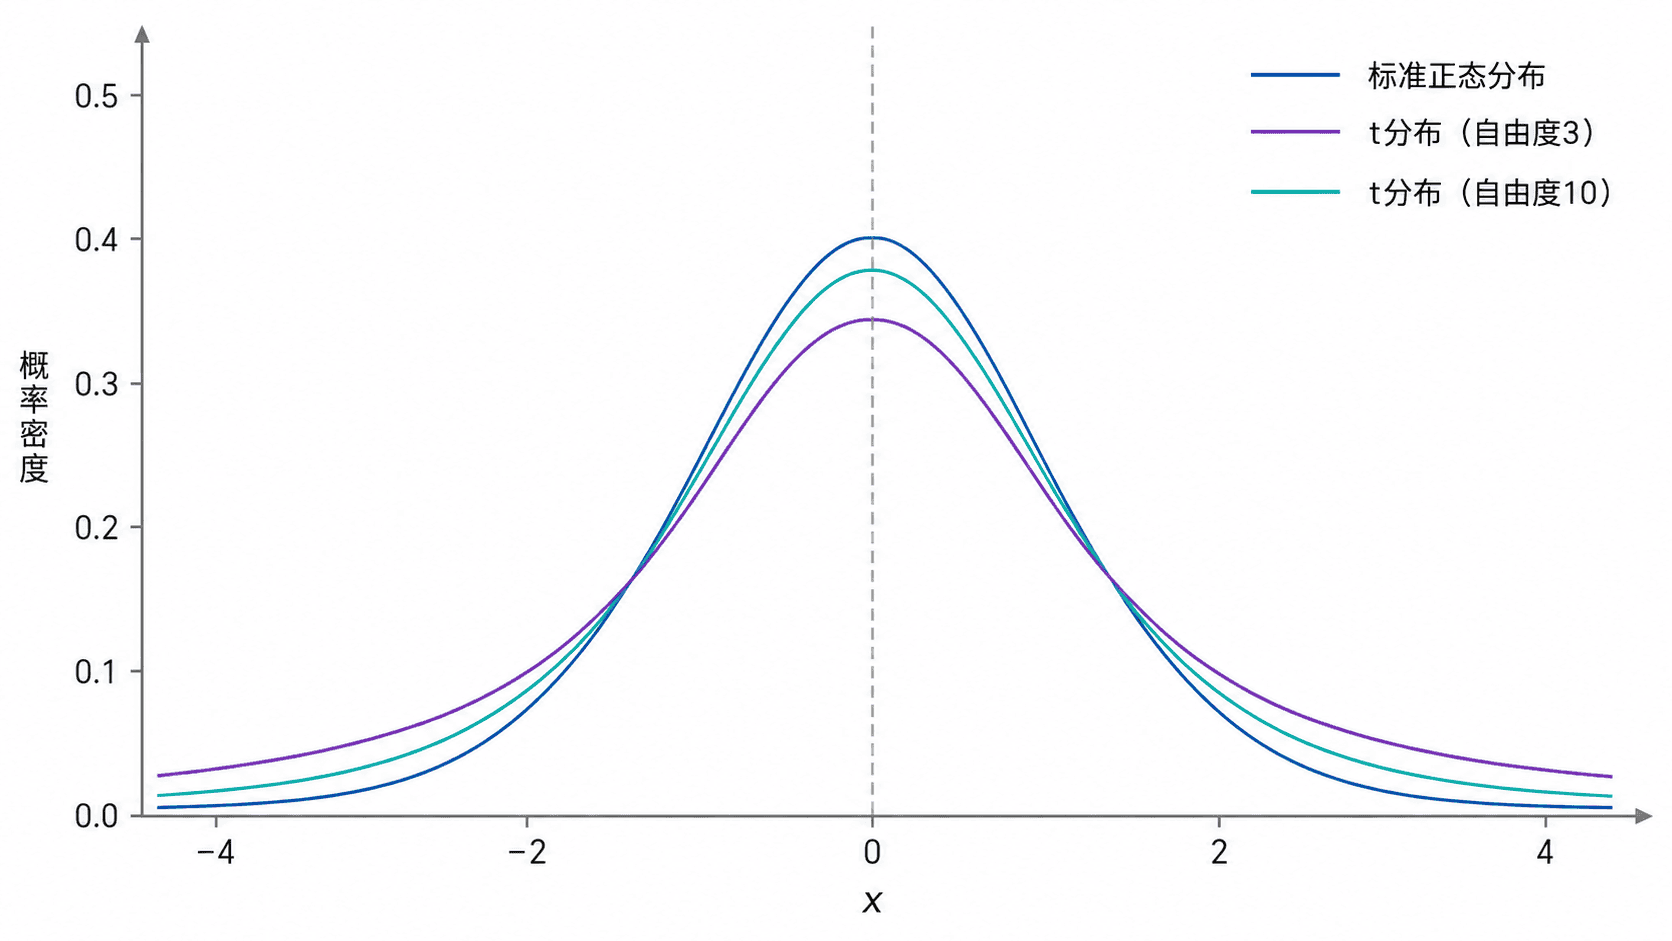
自由度决定尾部厚度
自由度较小时,分母中的方差估计不稳定,t 分布的尾部明显更厚。这意味着极端取值比标准正态分布更常见,因此在计算临界值时,t 分布通常会给出更宽的区间。
随着自由度增大,样本提供的信息越来越多,方差估计逐渐稳定,t 分布会趋近标准正态分布。实践中不能简单地说“样本量超过某个固定数值就必须改用正态分布”;直接使用对应自由度的 t 分布通常更稳妥,而在大样本下两者结果会自然接近。
它为什么出现在样本均值中
设总体服从正态分布 ,抽取容量为 的独立样本。当总体标准差 已知时,标准化后的样本均值服从标准正态分布:
但现实中 往往未知,只能用样本标准差 替代,于是统计量变为
自由度为 ,因为样本标准差的计算使用了样本均值,损失了一个独立约束。这个统计量是单样本均值置信区间和单样本 t 检验的基础。
与标准正态分布怎么区分
两者都关于零对称,也都呈钟形,但使用条件不同。总体标准差已知时,可以使用标准正态分布;总体标准差未知、总体近似正态且需要用样本标准差代替时,应使用 t 分布。
“总体方差未知”并不自动保证 t 方法适用。小样本下还应关注总体是否严重偏斜、是否存在明显异常值;这些情况会破坏基于正态总体的精确结论。样本较大时,均值的抽样分布通常更稳定,但仍应先检查数据质量。