
高等数学 / 系统课时
贝叶斯公式应用
贝叶斯公式应用
贝叶斯公式解决的是“看到新证据后,原来的判断应当怎样更新”。本课用检测、分类和质量控制三个场景,把先验概率、似然、证据概率和后验概率串成一套可重复使用的解题方法。
学习目标
- 能识别先验概率、条件概率和后验概率
- 能用贝叶斯公式完成概率更新
- 能检查结果是否符合基准率和业务常识
从先验到后验
设若干原因事件 构成一个完备事件组,观察到证据 后,原因 的后验概率为:
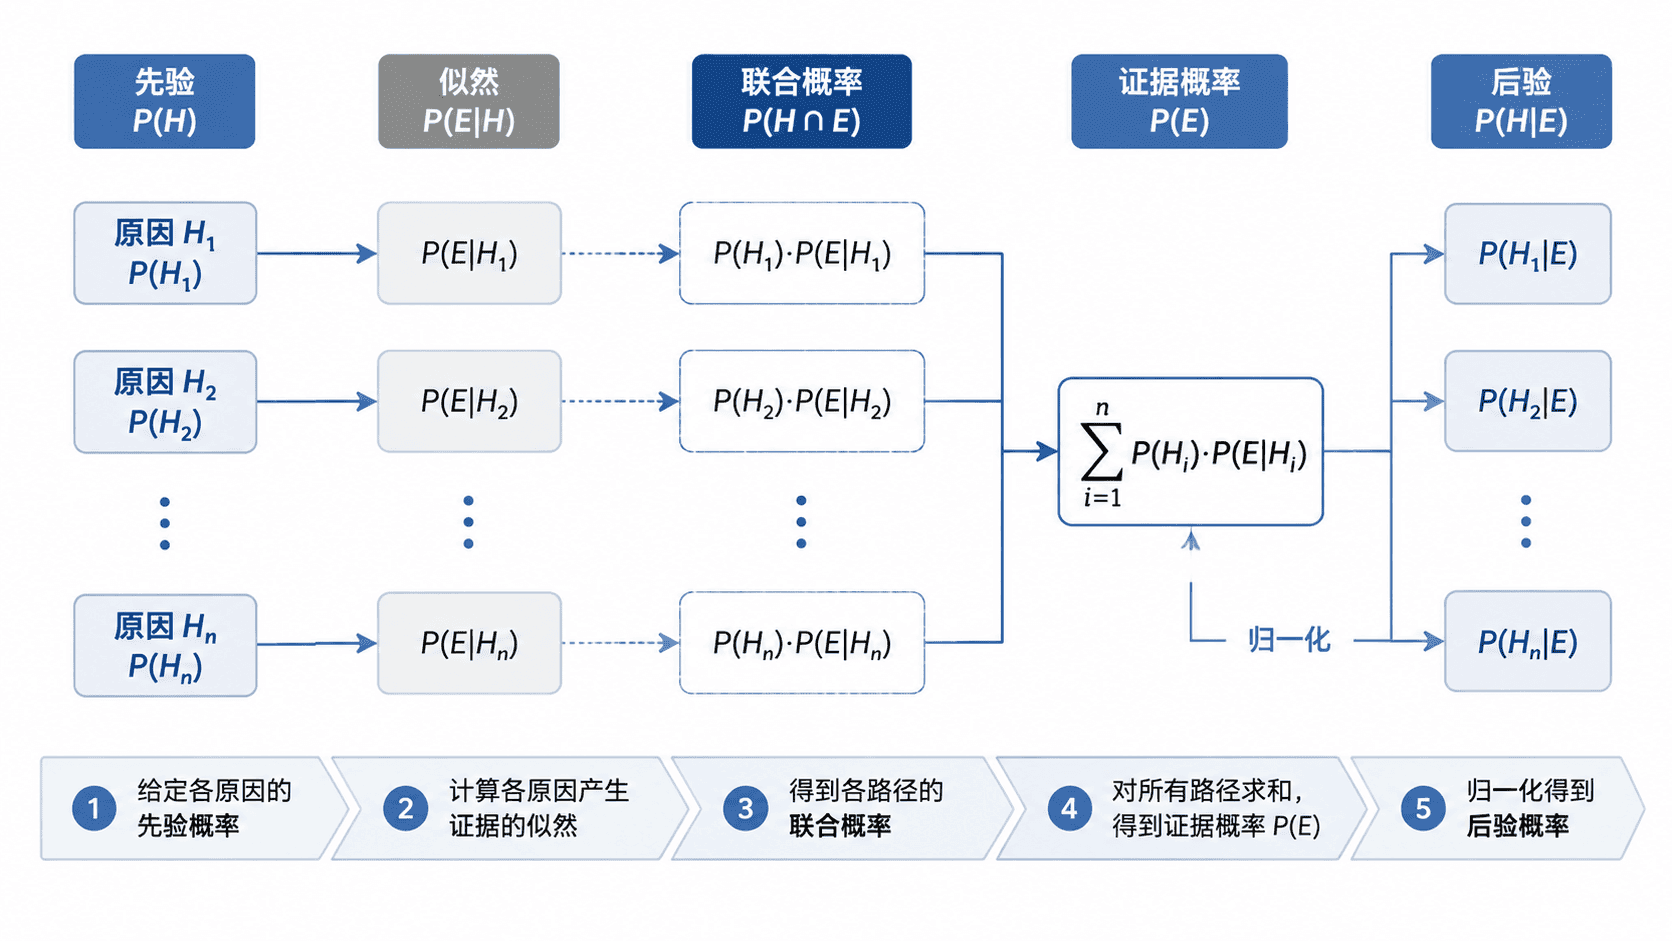
其中, 是观察证据前的先验概率, 是在原因 成立时看到证据 的可能性。分子是“原因与证据同时发生”的概率,分母是证据在所有可能原因下出现的总概率。
三类典型应用
检测:阳性不等于高概率
某疾病在人群中的患病率为 。检测灵敏度为 ,假阳性率为 。设 表示患病, 表示检测阳性,则:
阳性后的患病概率约为 ,并不是 。疾病本身很少见,大量未患病者中的少量假阳性会显著稀释结果。
分类:根据特征更新类别
某邮件系统中,垃圾邮件占 。垃圾邮件包含某关键词的概率为 ,正常邮件包含该词的概率为 。出现该关键词后,邮件是垃圾邮件的概率为:
后验概率约为 。关键词具有区分力,但正常邮件也可能包含它,因此分类器必须同时考虑特征似然和类别基准率。
质量控制:追溯缺陷来源
A 线生产总量的 ,次品率为 ;B 线生产总量的 ,次品率为 。随机抽到一个次品时,它来自 B 线的概率为:
虽然 B 线产量较少,但它贡献了约 的次品。质量追溯时应优先检查 B 线,但不能断言所有次品都来自 B 线。
通用解题与检查
- 明确“原因事件”和“已观察到的证据”,不要把二者写反。
- 写出每个原因的先验概率,以及该原因下证据出现的条件概率。
- 计算各条路径的联合概率 。
- 将所有联合概率相加得到证据概率,再用目标路径除以总证据概率。
- 检查后验概率是否位于 与 之间,并结合基准率判断是否合理。
原因只有两个时,分母通常写成“目标原因路径 + 另一个原因路径”;原因超过两个时,必须把所有互斥且完备的来源纳入分母。若遗漏一个来源,分母会偏小,后验概率也会被高估。
按自己的节奏,确认真正理解。