
高等数学 / 系统课时
样本均值的分布
样本均值的分布
本课回答一个核心问题:随机抽取一组样本后,样本均值会围绕总体均值怎样波动。你将掌握其期望、方差和标准误,并能判断何时可以使用正态分布进行概率近似。
学习目标
- 推导样本均值的期望与方差
- 理解标准误随样本量变化的规律
- 判断样本均值何时服从或近似服从正态分布
期望、方差与标准误
设 独立同分布,总体均值为 ,总体方差为 ,样本均值为
\bar{X}=\frac{1}{n}\sum_{i=1}^{n}X_i
$$。利用期望的线性性质可得。
E(\bar{X})=\mu $$
因此样本均值是总体均值的无偏估计量。独立条件下,各观测值方差可以相加,所以
样本均值抽样分布的标准差称为标准误:
样本量扩大 4 倍,标准误缩小为原来的一半。增加样本可以提高稳定性,但标准误按 下降,并不是按 下降。
分布形状与正态近似
当总体本身服从正态分布时,无论样本量大小,样本均值都精确服从正态分布:
当总体不是正态分布时,中心极限定理说明:在独立同分布且总体方差有限的条件下,样本量充分大时,标准化后的样本均值近似服从标准正态分布。
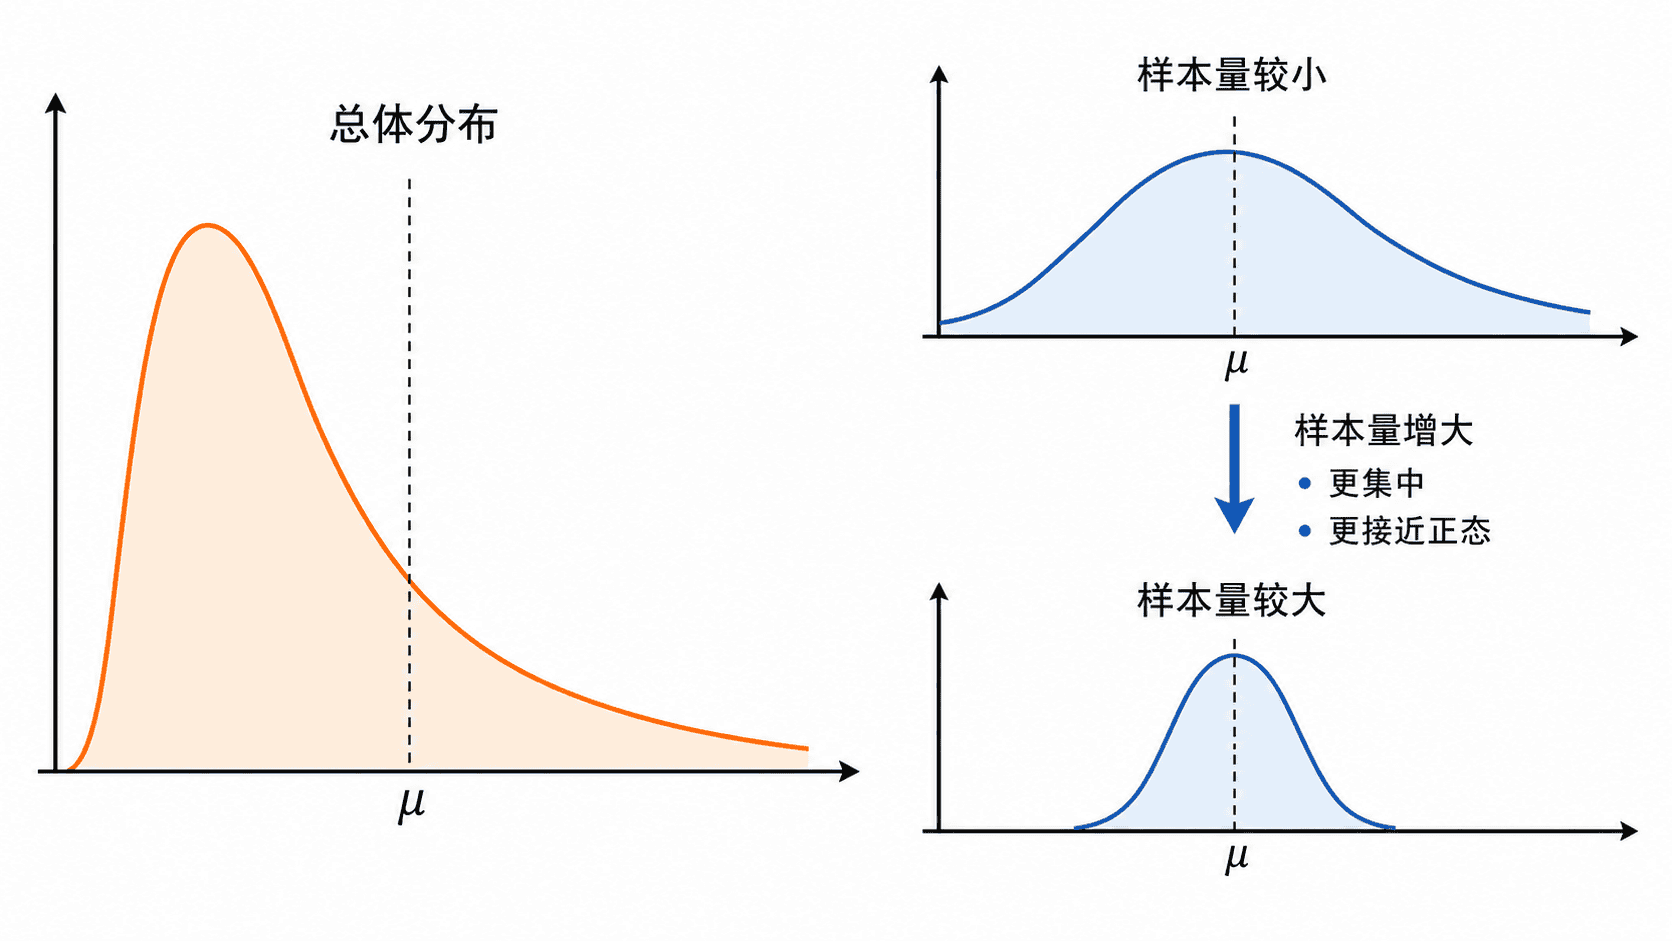
“充分大”没有对所有总体都适用的统一门槛。总体越偏斜、尾部越重或离群值越多,通常需要更大的样本量;若总体接近对称且无重尾,较小样本也可能得到良好近似。
概率计算示例
某总体均值为 ,标准差为 。随机抽取 个独立观测,则样本均值的期望为 ,标准误为
若总体正态,或样本量已足以支持正态近似,则
这表示重复抽取 36 个观测并计算均值时,约有 的样本均值会落在 到 之间。这里使用的是样本均值的标准误 ,不是单个观测值的标准差 。
适用条件与边界
上述方差公式依赖样本观测相互独立。若从有限总体中不放回抽样,而且抽样比例不可忽略,标准误应乘以有限总体修正系数:
其中 是总体容量。抽样比例很小时,修正系数接近 1,通常可以忽略;抽样比例较大时,不修正会高估样本均值的波动。
还要区分总体标准差 与样本标准差 。当 未知时,实际推断常用 估计标准误;小样本正态总体下进一步进行区间估计时,通常需要使用 分布,而不是直接套用标准正态分布。
按自己的节奏,确认真正理解。