
高等数学 / 系统课时
标准化与异常值识别
标准化与异常值识别
不同指标的单位和波动范围往往不同,原始数值不能直接比较。本课将计算标准分数,把观测值转换为“距离均值多少个标准差”,再结合分布形态选择合适的异常值识别规则。
学习目标
- 能计算并解释单个观测值的标准分数
- 能使用标准分数规则初步筛查异常观测
- 能在偏态分布中改用更稳健的四分位距规则
标准分数表示什么
对样本数据,观测值 的标准分数通常写为:
其中, 是样本均值, 是样本标准差。标准分数没有单位,因此身高、收入、考试成绩等不同量纲的指标可以在各自分布中比较相对位置。
表示观测值等于均值; 表示它比均值高 1.5 个标准差; 表示它比均值低 2 个标准差。标准化改变的是表示尺度,不会改变数据从小到大的顺序。
例如,一组成绩的均值为 70,标准差为 10。某位学生得分 90,则:
这表示该成绩比均值高 2 个标准差,而不是“高 2 分”或“排名前 2 名”。
用标准分数初步识别异常值
当数据近似对称且没有明显长尾时,可以把 作为需要关注的宽松筛查条件,把 作为更严格的异常信号。阈值越小,能发现更多可疑点,但误报也会增加。
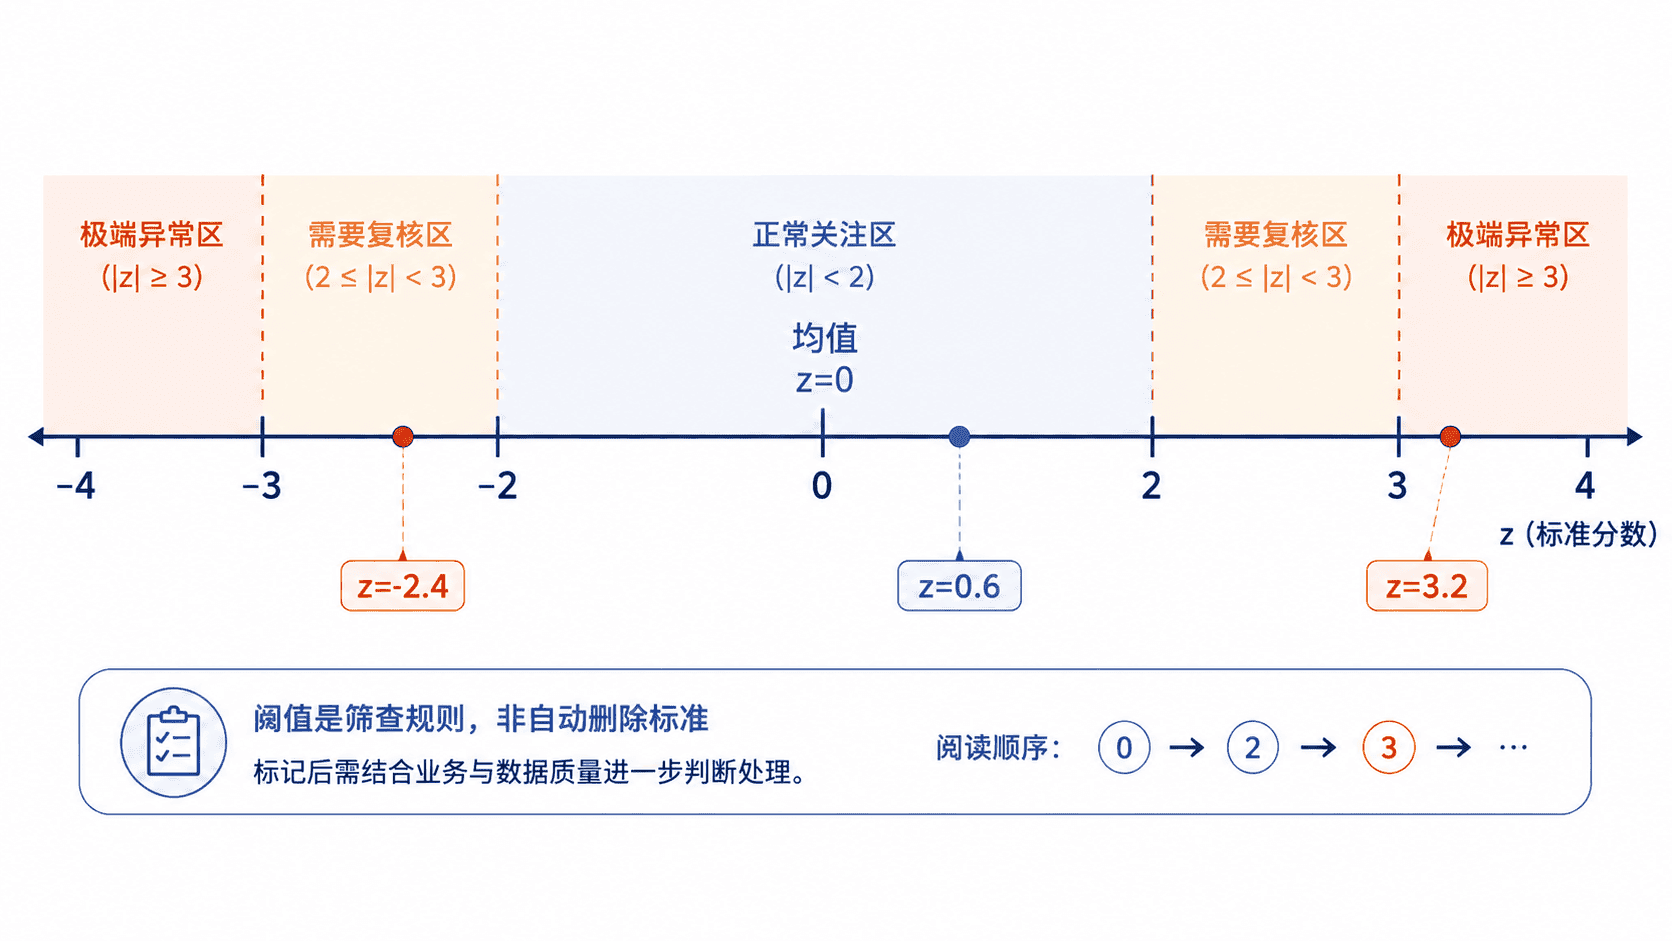
标准分数规则依赖均值和标准差,而极端值本身会拉动均值并放大标准差。因此,异常值可能把自己的 压低,尤其是在样本量较小时。它适合作为线索,不适合作为自动删除数据的唯一依据。
识别后应回到原始记录核查。优先检查单位、录入格式、传感器状态、重复记录和采集时间,再判断该观测是错误数据、罕见但真实的事件,还是代表一个不同群体。
偏态数据改用四分位距规则
收入、响应时间和订单金额常呈右偏分布。此时均值和标准差容易被长尾影响,标准分数不再稳健,可改用四分位距:
常见筛查边界为:
落在边界外的观测被标记为潜在异常值。该方法主要依赖数据中间 50% 的位置,对少量极端值不敏感,更适合偏态数据或尚未确认分布形态的初步分析。
一套可执行的判断顺序
先用直方图或箱线图观察分布形状,再选择规则。分布大致对称时,可用标准分数筛查;明显偏态或长尾时,优先使用四分位距规则。无论采用哪种方法,都要保留原始值、阈值和被标记原因,便于复核。
异常识别的最终结论必须结合业务语境。同一个 ,在稳定的生产尺寸中可能意味着质量故障,在金融收益或网络流量中却可能是正常的极端波动。统计规则负责缩小检查范围,不能替代领域判断。