
高等数学 / 系统课时
p值
p值
p 值把样本结果转化为一个可比较的尾部概率,用来衡量数据与原假设的相容程度。本课将从检验统计量出发,说明单侧与双侧 p 值的计算逻辑、决策规则以及最容易出现的解释错误。
学习目标
- 说明 p 值在原假设成立条件下表示什么
- 根据检验方向确定尾部区域,并使用 p 值完成决策
- 避免把 p 值误解为原假设为真的概率或效应大小
p值回答什么问题
p 值是在原假设 成立的前提下,观察到当前检验统计量或更极端结果的概率。这里包含两个关键条件:先假定 成立,再按照备择假设规定的方向判断“更极端”。
p 值越小,说明当前数据在 成立时越少见,因此反对 的证据越强。p 值较大只表示数据与 并不明显冲突,不能据此证明 正确。
从检验统计量到尾部概率
设观测到的检验统计量为 。右侧检验的 p 值是右尾概率:
左侧检验使用左尾概率;双侧检验则累计与观测结果同样或更加偏离原假设的两侧区域。对称分布下,双侧 p 值常写成较小单侧尾部概率的两倍,但不能对所有非对称统计量机械套用。
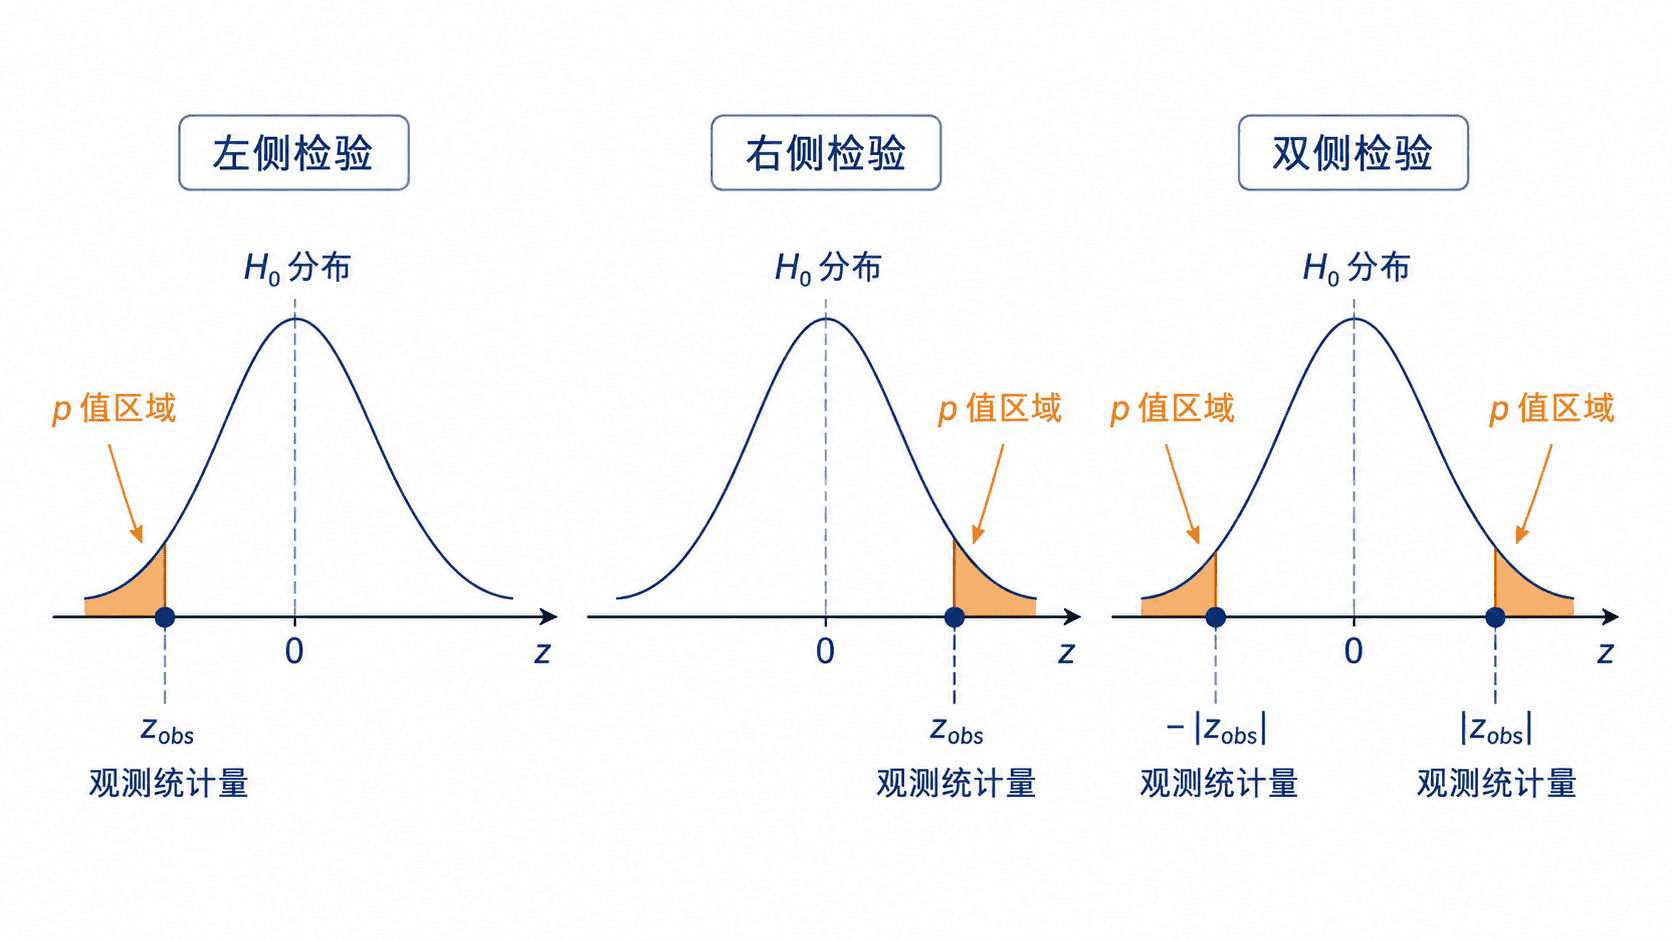
尾部方向由备择假设决定,而不是看到样本结果后再选择。先看数据再挑选更有利的单侧方向,会使实际第一类错误概率高于预设水平。
p值的决策规则
显著性水平 α 必须在查看结果前确定。得到 p 值后按同一规则决策:
- 当 时,拒绝
- 当 时,不拒绝
p 值本身提供证据强弱,α 提供决策阈值。因此,同一个 p 值在不同 α 下可能得到不同结论。例如 p=0.03 在 α=0.05 时显著,在 α=0.01 时不显著。
主示例:均值的右侧检验
某灌装设备过去的平均装量为 100 克。抽取 36 件产品,得到样本均值 102 克,已知总体标准差为 6 克。检验:
标准误为 ,因此检验统计量为:
在标准正态分布下,右尾概率约为:
若预先设定 α=0.05,则 ,拒绝 ,认为平均装量有增大的统计证据。若 α=0.01,则不拒绝 。结论改变的原因是决策标准不同,而不是 p 值发生变化。
正确解释与常见边界
p=0.0228 不表示“ 为真的概率是 2.28%”,也不表示重复实验有 97.72% 的概率得到相同结论。经典假设检验把 当作条件,并没有为假设本身直接赋予概率。
p 值也不衡量差异是否重要。样本量很大时,极小但缺乏实际意义的差异也可能得到很小的 p 值;样本量不足时,重要差异又可能不显著。报告结果时应同时给出效应大小、置信区间、样本量和预设 α。