
高等数学 / 系统课时
均匀分布
均匀分布
连续均匀分布适合描述某个有限区间内“各位置同等可能”的随机结果。本课将从参数和密度出发,推导分布函数与区间概率,并说明它适合哪些场景、又不适合哪些数据。
学习目标
- 理解连续均匀分布 的参数含义
- 掌握其密度函数、分布函数和区间概率公式
- 能判断一个实际问题是否适合使用均匀分布建模
定义与参数
若随机变量 在区间 内各处具有相同的概率密度,其中 ,则记作。
参数 和 分别表示可能取值的下界与上界。为了让密度曲线下的总面积等于 ,区间内的密度必须是常数 :
区间越宽,固定总概率需要铺得越分散,因此密度越低;区间越窄,密度越高。密度高度可以超过 ,只要整个区间下的面积仍等于 。
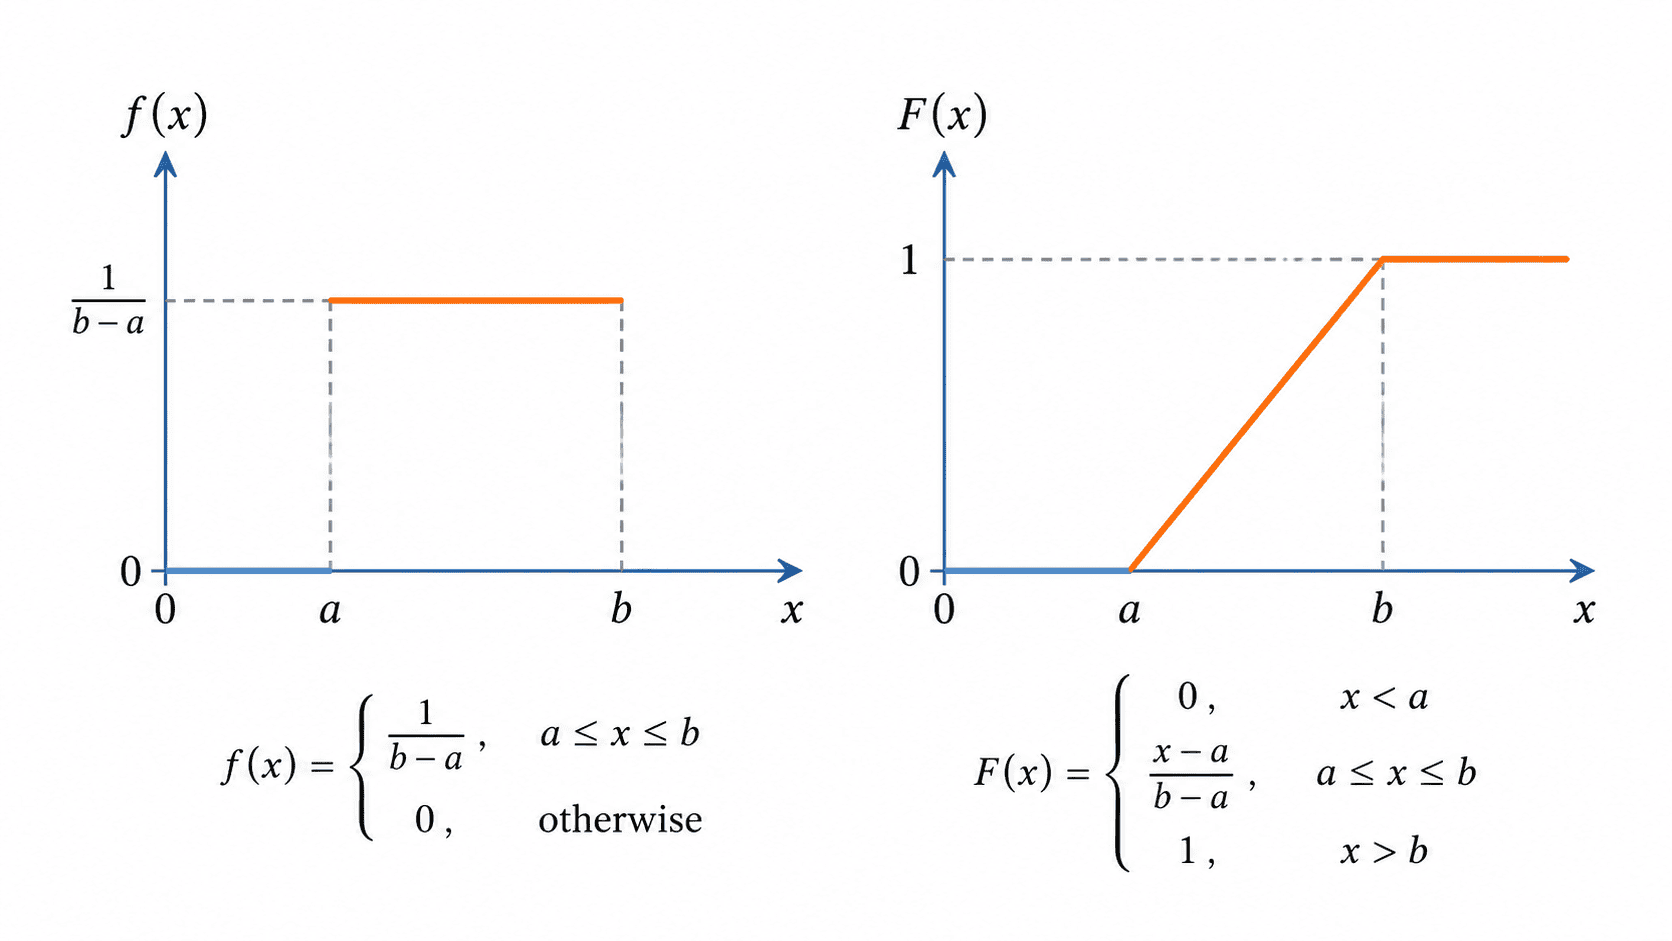
概率只由区间长度决定
对满足 的区间 ,概率为
分子是目标区间长度,分母是全部可能区间长度。因此,两个长度相同的子区间具有相同概率,而它们位于左侧、中间还是右侧并不重要。
连续型随机变量在端点上的概率为零,所以 、 与 的结果相同。实际计算时只需关注区间长度,不必纠结端点是否包含。
分布函数
根据 ,均匀分布的分布函数为
在 内,累计概率随着 线性增加。因为密度是常数,分布函数的斜率也保持不变;到达 后,全部概率已经累计完成,所以函数保持为 。均匀分布的数学期望和方差分别为
期望位于区间中点;方差只由区间宽度决定,区间整体平移不会改变离散程度。
主示例:随机等待时间
假设一班接驳车每隔 分钟到站,乘客到站时刻可近似看作在一个班次周期内均匀随机。令等待时间 。等待时间在 到 分钟之间的概率为
等待超过 分钟的概率为
平均等待时间为 分钟。这个模型成立的关键是假设乘客到站时刻与车辆班次没有系统性关联;如果大量乘客会查看实时到站信息,等待时间通常就不再均匀。
适用场景与边界
均匀分布常用于随机数生成、测量舍入误差、随机抽样位置,以及只知道上下界但没有理由偏向某一区域的初步模型。它的优势是参数少、概率计算直接,适合建立基准模型。
当数据明显集中在中心、靠近边界,或出现多个高峰时,不应仅因“取值落在一个区间内”就使用均匀分布。判断重点不是有没有上下界,而是区间内各处的密度是否可以合理视为相同。