
高等数学 / 系统课时
定义研究问题
定义研究问题
统计分析开始前,必须把“想了解什么”改写成可观测、可比较、可检验的问题。本课将建立一份最小研究定义,明确研究对象、目标变量、解释变量、分析单位和统计假设,避免拿到数据后才临时决定分析方向。
学习目标
- 能把宽泛业务诉求改写成明确的统计研究问题
- 能区分研究对象、目标变量、解释变量和控制变量
- 能写出与数据和分析方法对应的原假设与备择假设
从业务诉求到统计问题
“新引导页是否更好”不是完整研究问题,因为“更好”没有可测量定义。可以将其改写为:“在过去 90 天完成注册的新用户中,引导页 B 是否改变用户的 7 日留存率?”
这句话同时限定了研究总体、比较因素、目标结果和观察窗口。研究问题越具体,后续的数据提取、方法选择和结论边界越清晰。
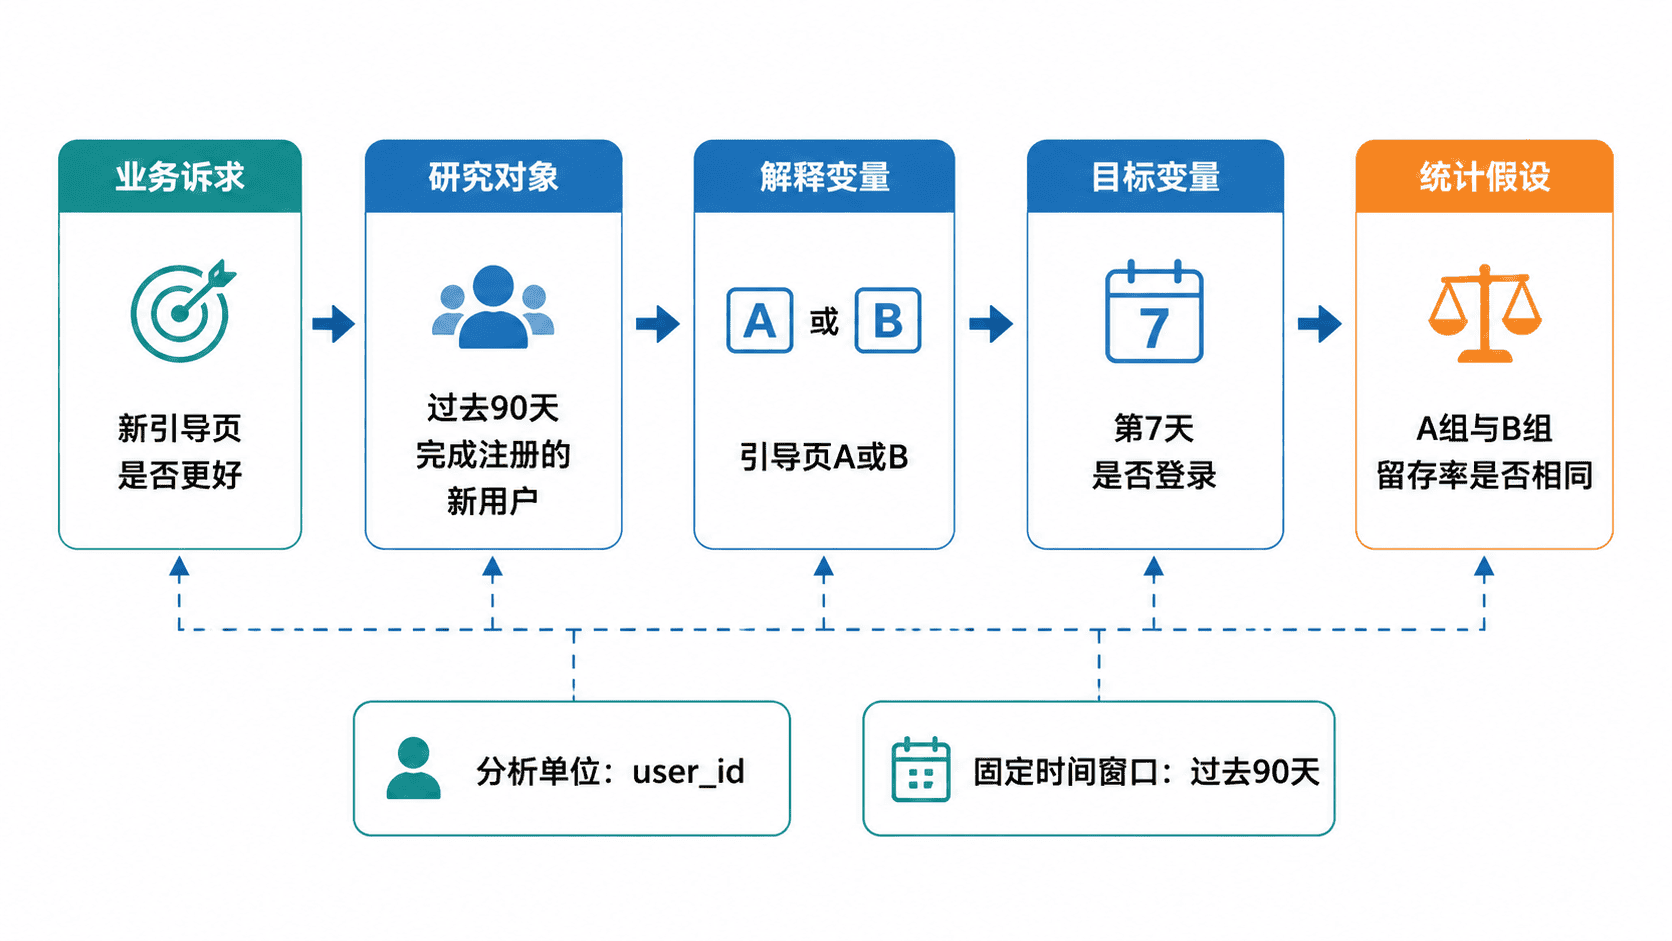
图中的顺序不能颠倒。先定义研究对象和分析单位,再定义变量与假设,能够防止同一用户被重复计数、时间范围随结果变化或目标指标在分析中途被替换。
五个必要组成部分
研究对象说明结论适用于谁,例如“过去 90 天完成注册的新用户”。分析单位说明一行数据代表什么,例如用户、订单或门店。两者不同会导致样本量和独立性判断完全不同。
目标变量是要解释或比较的结果,本例为“注册后第 7 天是否登录”。解释变量是被研究的主要因素,本例为引导页版本。控制变量用于处理可能同时影响解释变量与结果的其他因素,例如注册渠道和设备系统。
统计假设必须直接对应目标变量。双侧比较可以写为:原假设 是 A、B 两组 7 日留存率相同;备择假设 是两组留存率不同。只有在研究开始前已有明确方向性依据时,才考虑单侧假设。
建立可评审的研究定义
下面用标准 JSON 固化研究定义。它不是分析程序,而是一份供产品、数据和研究人员共同评审的数据契约;<START_DATE> 与 <END_DATE> 应替换为实际日期。
{
  "population": "过去90天完成注册的新用户",
  "analysisUnit": "user_id",
  "outcome": {
    "name": "day7_retained",
    "type": "binary",
    "definition": "注册后第7天是否登录"
  },
  "exposure": {
    "name": "onboarding_variant",
    "type": "categorical",
    "levels": ["A", "B"]
  },
  "covariates": ["signup_channel", "device_os"],
  "hypothesis": {
    "null": "A组与B组的7日留存率相同",
    "alternative": "A组与B组的7日留存率不同"
  },
  "timeWindow": {
    "start": "<START_DATE>",
    "end": "<END_DATE>"
  }
}
验证这份定义时,应逐项确认字段能映射到真实数据、每个用户只出现一次、留存口径没有歧义、版本分组发生在结果之前,并且时间窗口在查看结果前已经固定。任一项无法确认,都应先修正研究设计,而不是直接进入显著性检验。
选择可检验的表达
一个合格问题通常能回答四件事:研究谁、比较什么、观察什么结果、在哪个时间范围内。若还需要因果结论,还必须说明分组机制、混杂因素和干预发生时间;仅凭相关数据不能自动得到因果解释。
避免使用“有没有影响”“效果如何”这类没有指标和方向的表达,也不要同时塞入多个主要目标。主要目标应保持一个,其他指标可列为次要结果,并在分析前说明多重比较处理方式。
研究开始前的验收
在提取数据前,用一句话复述完整问题,并让非分析人员也能指出研究对象、解释变量和目标变量。随后检查假设能否被一个明确统计量检验,例如留存率差、均值差或相关系数。
最后确认结论边界。本例最多支持对指定时间窗口内新用户的 A、B 版本留存差异作判断,不能直接推广到老用户、其他页面版本或未来长期留存。