
数据结构与算法 / 系统课时
Kruskal 算法
Kruskal 算法
本课把最小生成树的安全边性质转化为可执行流程:先按权重排序全部边,再借助并查集判断候选边是否连接不同连通分量,最终得到一棵总权重最小且不含环的生成树。
学习目标
- 掌握 Kruskal 算法的排序、判环和合并流程。
- 使用并查集高效判断两个顶点是否已经连通。
- 编写可运行的 Java 程序,并验证结果、复杂度与异常边界。
算法流程与并查集
Kruskal 算法从空边集开始,将每个顶点视为一个独立连通分量。所有边按权重从小到大排列后依次检查:若边的两个端点属于不同分量,就选择这条边并合并分量;若已经属于同一分量,加入该边会形成环,因此跳过。
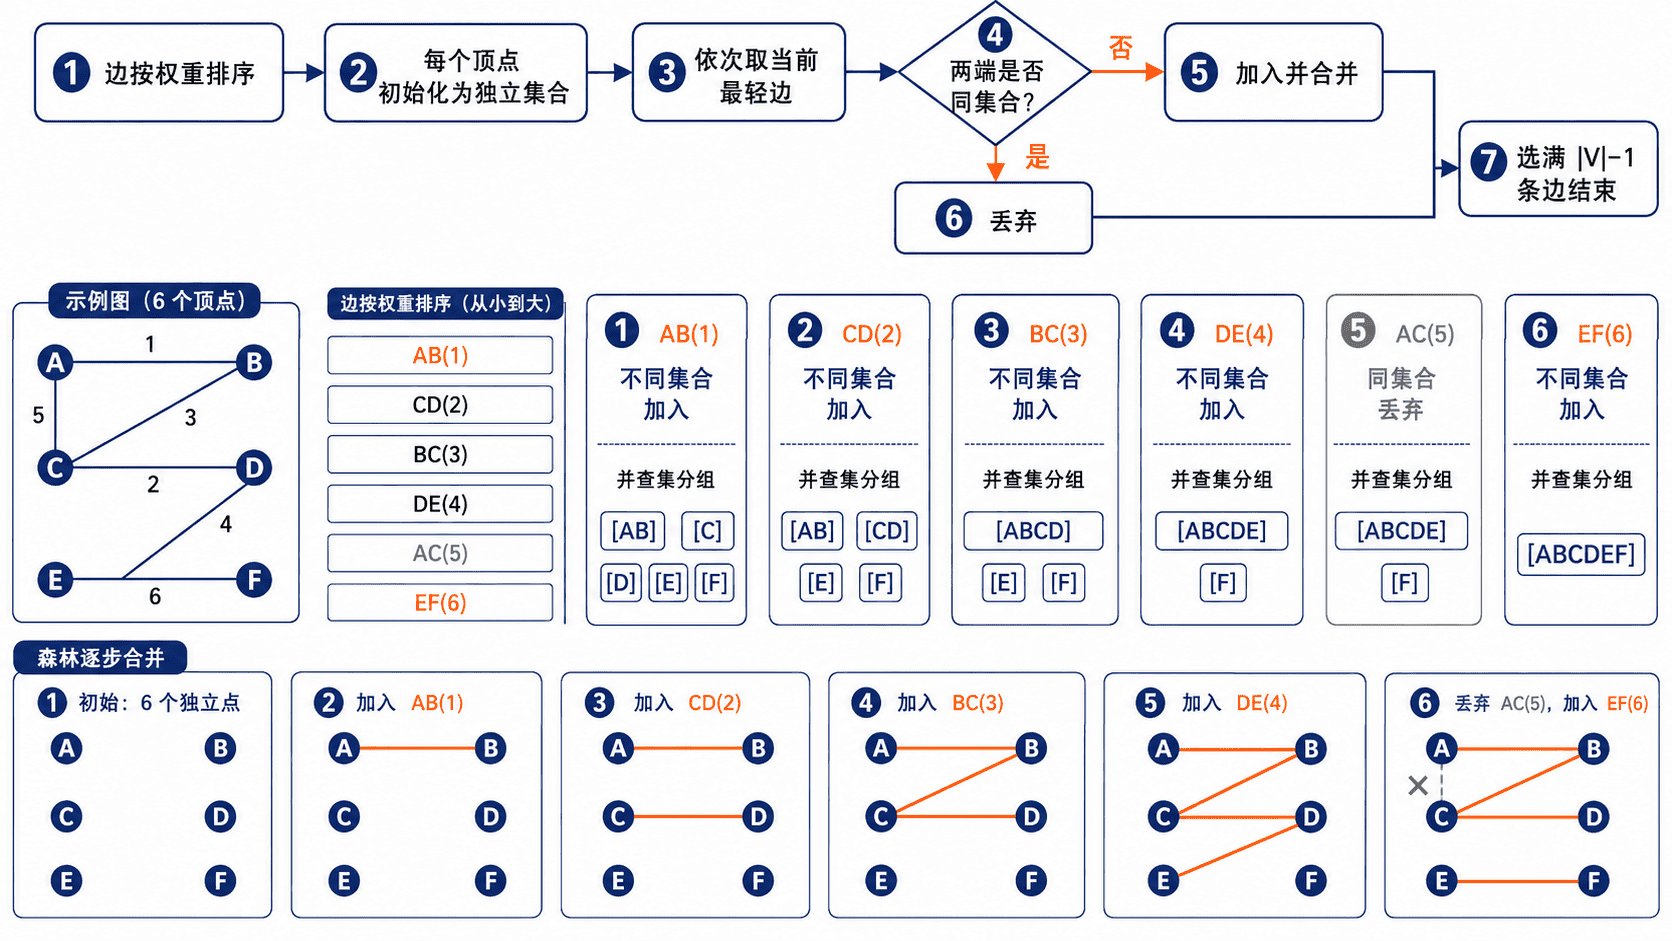
并查集提供两个关键操作:find(x) 返回顶点所在集合的代表元,union(a, b) 合并两个集合。路径压缩会在查找时缩短父链,按秩合并会把较浅的树挂到较深的树下。两种优化结合后,单次操作的均摊成本接近常数。
算法每次选择的边都是当前能够连接两个不同分量的最轻边。把任一分量看作割的一侧,这条边就是该割上的轻边,因此满足安全边性质。选中边数达到 vertexCount - 1 时,连通图的最小生成树已经完成。
完整可运行示例
下面的 Java 程序对 6 个顶点、9 条无向边执行 Kruskal 算法。并查集的 union 方法同时承担判环职责:返回 false 表示两个端点已经连通,当前边必须跳过。
import java.util.ArrayList;
import java.util.Comparator;
import java.util.List;

public class KruskalDemo {

    static class Edge {
        final int from;
        final int to;
        final int weight;

        Edge(int from, int to, int weight) {
            this.from = from;
            this.to = to;
            this.weight = weight;
        }
    }

    static class DisjointSet {
        private final int[] parent;
        private final int[] rank;

        DisjointSet(int size) {
            parent = new int[size];
            rank = new int[size];

            for (int i = 0; i < size; i++) {
                parent[i] = i;
            }
        }

        int find(int x) {
            if (parent[x] != x) {
                // 路径压缩:让访问过的节点直接连接到代表元。
                parent[x] = find(parent[x]);
            }
            return parent[x];
        }

        boolean union(int a, int b) {
            int rootA = find(a);
            int rootB = find(b);

            if (rootA == rootB) {
                return false;
            }

            // 按秩合并,避免集合树退化成过长链条。
            if (rank[rootA] < rank[rootB]) {
                parent[rootA] = rootB;
            } else if (rank[rootA] > rank[rootB]) {
                parent[rootB] = rootA;
            } else {
                parent[rootB] = rootA;
                rank[rootA]++;
            }
            return true;
        }
    }

    public static void main(String[] args) {
        int vertexCount = 6;
        List<Edge> edges = new ArrayList<>(List.of(
                new Edge(0, 1, 4),
                new Edge(0, 2, 4),
                new Edge(1, 2, 2),
                new Edge(1, 3, 5),
                new Edge(2, 3, 5),
                new Edge(2, 4, 11),
                new Edge(3, 4, 2),
                new Edge(3, 5, 1),
                new Edge(4, 5, 7)
        ));

        // 增加端点比较,使相同权重时的输出顺序保持确定。
        edges.sort(Comparator
                .comparingInt((Edge edge) -> edge.weight)
                .thenComparingInt(edge -> edge.from)
                .thenComparingInt(edge -> edge.to));

        DisjointSet disjointSet = new DisjointSet(vertexCount);
        List<Edge> minimumSpanningTree = new ArrayList<>();
        int totalWeight = 0;

        for (Edge edge : edges) {
            if (disjointSet.union(edge.from, edge.to)) {
                minimumSpanningTree.add(edge);
                totalWeight += edge.weight;

                if (minimumSpanningTree.size() == vertexCount - 1) {
                    break;
                }
            }
        }

        if (minimumSpanningTree.size() != vertexCount - 1) {
            System.out.println("图不连通,无法生成最小生成树。");
            return;
        }

        for (Edge edge : minimumSpanningTree) {
            System.out.printf(
                    "选择边 (%d, %d),权重 = %d%n",
                    edge.from,
                    edge.to,
                    edge.weight
            );
        }
        System.out.println("最小生成树总权重 = " + totalWeight);
    }
}
预期输出
选择边 (3, 5),权重 = 1
选择边 (1, 2),权重 = 2
选择边 (3, 4),权重 = 2
选择边 (0, 1),权重 = 4
选择边 (1, 3),权重 = 5
最小生成树总权重 = 14
相同权重的边可能有多种合法处理顺序,因此其他实现可能输出不同的边集合;只要结果含有 vertexCount - 1 条边、保持连通且总权重最小,就仍然正确。
结果、复杂度与边界
设顶点数为 、边数为 。边排序需要 时间,并查集处理全部边需要近似 时间,因此总时间复杂度由排序主导,为 。边数组、并查集和结果集合共同占用 空间。
实现时应重点检查三个边界。第一,图不连通时最终选中边数小于 V - 1,程序应明确报告失败或返回最小生成森林。第二,自环的两个端点相同,union 会返回 false,不会进入结果。第三,平行边可以同时参与排序,但最多只有满足当前割性质且不成环的边会被选择。
若边权总和可能超过 int 范围,应把 weight 与 totalWeight 改为 long。当输入规模很大时,避免先构造邻接矩阵;Kruskal 只需要边列表,邻接矩阵会额外消耗 空间。
常见错误与练习
常见错误
- 只按权重选边却不判环,会得到权重看似很小但不是树的子图。
- 选满
V - 1条边后仍继续扫描,不影响正确性,但会增加无效并查集操作。 - 未检查最终边数,可能把不连通图的最小生成森林误报为最小生成树。
- 把并查集用于有向图的最小生成树问题。标准最小生成树定义针对无向图,有向图需要其他模型与算法。
练习
- 在示例中加入边
(0, 5, 3),手工预测新最小生成树及总权重,再运行程序验证。验收条件是输出边数为 5,且不出现环。 - 将程序改造为从标准输入读取
V、E和每条边,使用long保存权重。验收条件是连通图输出总权重,不连通图输出明确提示,并正确忽略自环。
本课总结
- Kruskal 按边权递增扫描,并只选择连接不同连通分量的边。
- 并查集通过路径压缩和按秩合并高效完成判环与分量合并。
- 总复杂度为 ,实现必须额外检查不连通图、溢出和输入边界。
下一课预告
接下来可以继续学习另一类最小生成树构造方法,比较“按边扩张”和“按顶点扩张”的差异,并根据图的稀疏程度选择更合适的实现。