
数据结构与算法 / 系统课时
算法方案评审与优化
算法方案评审与优化
本课把“代码能够运行”提升为“方案能够被审查和决策”。你将建立统一评审框架,用正确性证据、复杂度、测试数据、替代方案和风险说明判断当前实现是否值得保留,以及下一步应该优化什么。
学习目标
- 用不变量、边界条件和测试结果说明算法为什么正确。
- 在同一约束下比较多个方案的时间、空间、可维护性与诊断能力。
- 把优化建议写成可验证的假设、改动和验收指标。
评审输入与证据链
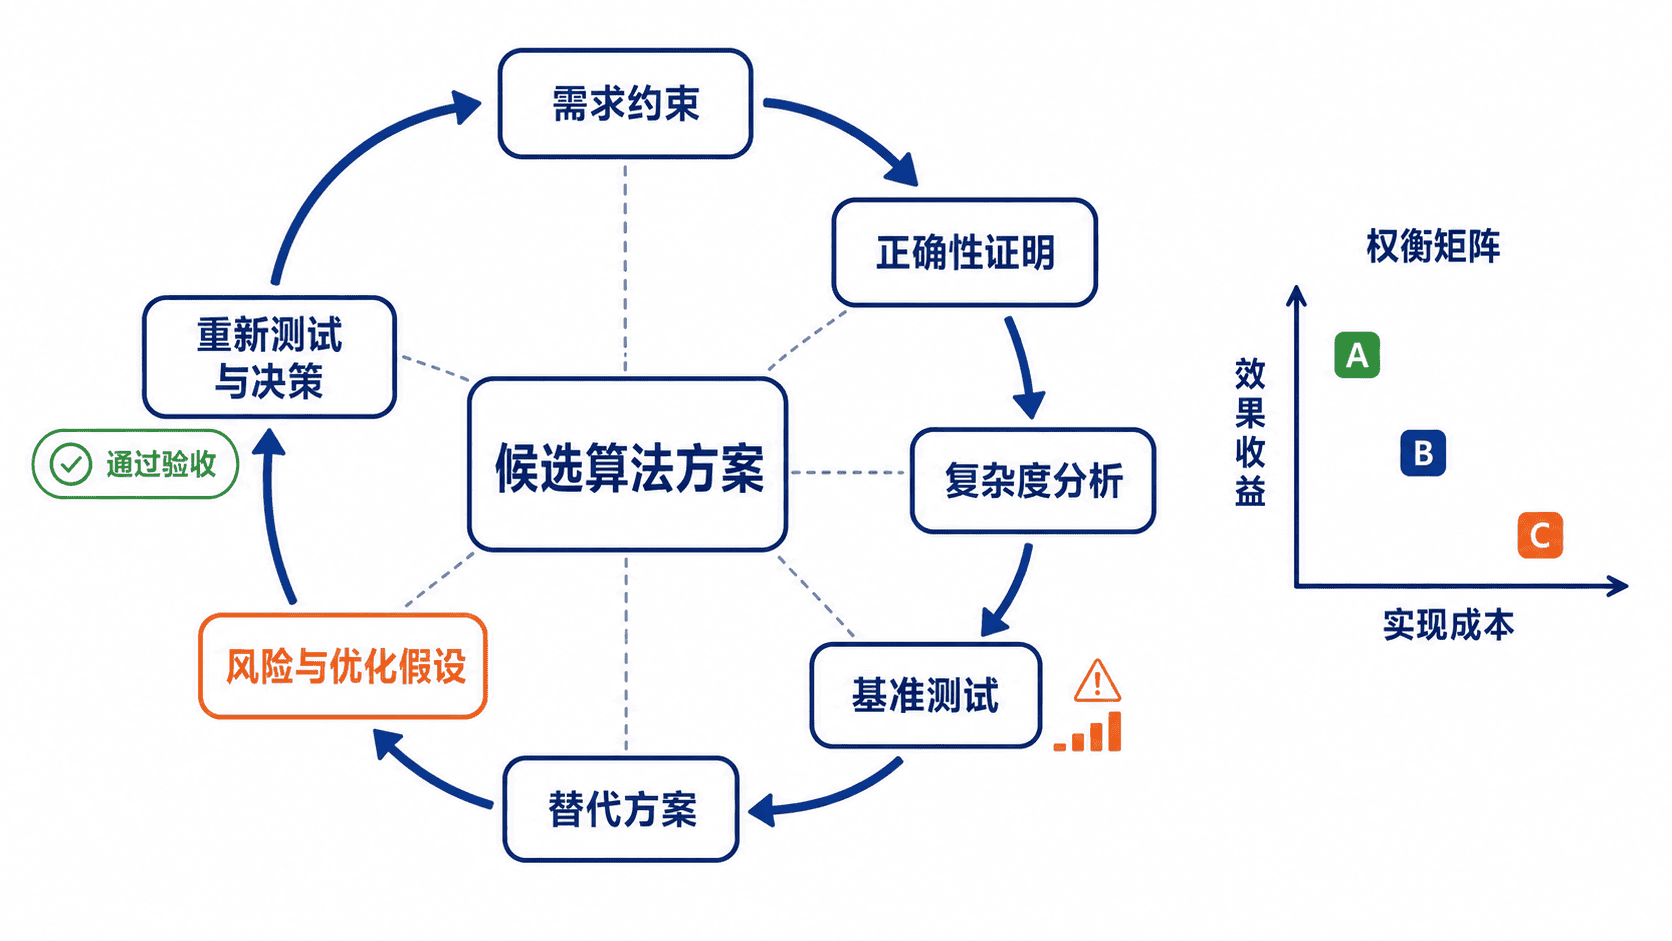
一次完整评审至少需要五类输入:需求约束、正确性依据、复杂度分析、可重复测试结果和替代方案。结论必须能够回溯到证据,不能只写“性能较好”或“代码更优雅”。
| 评审维度 | 必须回答的问题 | 可接受证据 |
|---|---|---|
| 正确性 | 对所有合法输入是否满足约束 | 不变量、证明、属性测试、反例测试 |
| 时间复杂度 | 数据规模增长时耗时如何变化 | 渐进分析、同环境基准数据 |
| 空间复杂度 | 峰值内存是否符合限制 | 数据结构规模、内存采样 |
| 可诊断性 | 失败时能否定位原因 | 错误类型、上下文、可重现用例 |
| 可维护性 | 修改规则是否容易引入错误 | 模块边界、测试覆盖、代码审查结果 |
正确性、复杂度与替代方案
正确性评审应先写前置条件,再写循环或递归过程保持的不变量,最后说明终止时为何得到目标结果。以任务调度器为例,关键不变量是:进入就绪队列的任务入度必为 0;每条依赖边只在前驱完成时处理一次;输出中的每个任务最多出现一次。
复杂度必须基于实际数据结构。邻接表加优先队列的调度器时间复杂度为 ,而每轮扫描全部未完成任务的实现最坏可达到 。替代方案不能只比较速度,还要说明环检测精度、稳定排序、实现复杂度和后续扩展成本。
可执行评审示例
下面的脚本读取三组固定基准结果,按项目权重计算综合分。样例数据用于演示评审方法,不代表任何机器的真实耗时;实际评审应在相同硬件、运行时版本、数据集和预热条件下重新采集。
from dataclasses import dataclass

@dataclass(frozen=True)
class Candidate:
    name: str
    correctness_passed: bool
    time_ms: int
    memory_mb: int
    diagnostics: int
    maintainability: int

def score(candidate: Candidate) -> int:
    if not candidate.correctness_passed:
        return 0

    # 评分权重服务于本项目目标:正确性优先,其次是性能和可诊断性。
    correctness = 40
    time_score = max(0, 25 - candidate.time_ms // 40)
    memory_score = max(0, 15 - candidate.memory_mb // 8)
    diagnostics_score = candidate.diagnostics * 2
    maintainability_score = candidate.maintainability * 2
    return correctness + time_score + memory_score + diagnostics_score + maintainability_score

def main() -> None:
    candidates = [
        Candidate("Kahn + PriorityQueue", True, 120, 32, 5, 4),
        Candidate("DFS + Postorder", True, 95, 28, 3, 3),
        Candidate("Repeated Scan", True, 640, 20, 4, 5),
    ]

    ranked = sorted(candidates, key=lambda item: (-score(item), item.name))
    print("评审排名:")
    for index, candidate in enumerate(ranked, start=1):
        print(f"{index}. {candidate.name}: {score(candidate)} 分")

    winner = ranked[0]
    print(f"推荐方案: {winner.name}")
    print("优化方向: 缓存入度与邻接表,避免重复扫描全部任务")

if __name__ == "__main__":
    main()
将代码保存为 review.py,使用 Python 3.10 或更高版本运行:
python3 review.py预期输出:
评审排名:
1. Kahn + PriorityQueue: 91 分
2. DFS + Postorder: 87 分
3. Repeated Scan: 80 分
推荐方案: Kahn + PriorityQueue
优化方向: 缓存入度与邻接表,避免重复扫描全部任务
从结论到优化计划
综合分只用于统一讨论口径,不能替代硬约束。正确性未通过的方案应直接淘汰;内存上限、实时截止时间或法规要求也应作为门槛,而不是与其他指标相互抵消。
优化建议应写成“现象、假设、改动、验证”四部分。例如:大图调度耗时主要来自重复扫描;假设缓存入度和邻接表可减少无效遍历;改动为一次建图并增量更新;验证指标是在同一数据集上将处理次数从二次量级降到接近 ,同时保持全部正确性测试通过。
评审验收清单
- 所有候选方案使用相同输入、环境、预热次数和统计方法。
- 每个复杂度结论都能对应到具体循环、递归或数据结构操作。
- 优化前后同时比较正确性、耗时、内存和诊断信息,避免局部指标变好却破坏整体质量。
- 最终结论明确写出推荐方案、拒绝理由、遗留风险和下一次复测条件。
本课总结
- 算法评审的核心是证据链:需求决定指标,指标连接测试,测试支撑结论。
- 正确性和硬约束是门槛,性能评分只能在通过门槛的方案之间比较。
- 有效优化必须提出可验证假设,并用同条件复测证明收益没有以其他质量属性为代价。
下一课预告
下一阶段将把评审结论转化为迭代计划,继续练习性能基准、回归测试、工程化监控与真实数据规模下的算法选择。