
数据结构与算法 / 系统课时
桶排序
桶排序
桶排序先把数据映射到多个范围较小的桶中,再分别排序并按桶顺序合并。本课以区间 [0, 1) 内的浮点数为例,完整实现分桶、桶内排序和结果合并,并解释为什么数据分布会直接影响性能。
学习目标
- 理解桶排序的分桶、桶内排序和合并过程。
- 能够为已知取值范围设计正确的桶索引公式。
- 能够分析均匀分布假设成立与失效时的复杂度差异。
核心原理与执行流程
桶排序利用数据取值范围已知的条件,将整个值域划分为若干按数值递增排列的区间。算法先把每个元素放入对应桶,再独立排序每个桶,最后按桶编号从小到大拼接。由于前一个桶中的所有值都不大于后一个桶中的值,合并时不需要再次进行跨桶比较。
对长度为 、取值位于 [0, 1) 的数组,可以创建 个桶,并使用 index = int(value * n) 计算桶编号。在数学上,桶编号范围为 0 到 n - 1,第 i 个桶对应区间 [i/n, (i+1)/n)。浮点运算可能改变极接近分界线的归桶结果。示例先验证原值,再把桶号限制在合法范围。映射对合法输入保持非递减,因此只要各桶内部排序,拼接仍然有序。
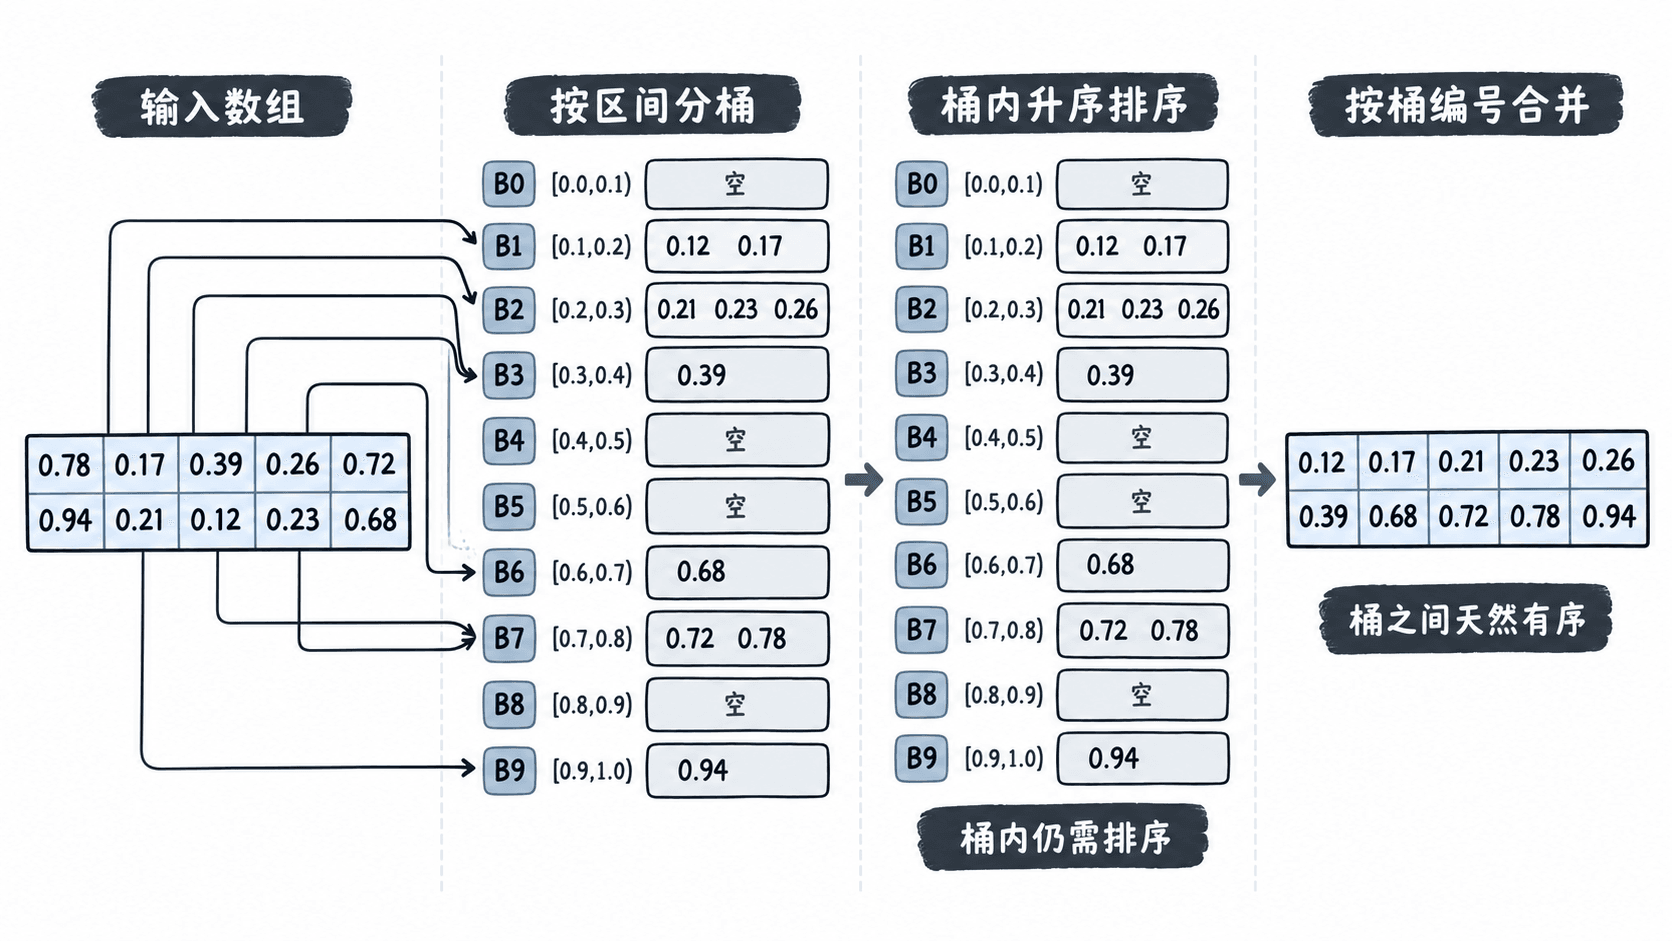
例如数组长度为 10 时,0.12 和 0.17 都进入编号为 1 的桶,0.21、0.23 和 0.26 进入编号为 2 的桶。先将各桶内部排好序,再依次读取桶 0 到桶 9,就能得到完整的升序序列。空桶直接跳过,不影响排序结果。
桶数量不是越多越好。桶太少会让单个桶承担大量排序工作;桶太多则增加容器创建和遍历开销。桶内可以使用插入排序、归并排序或语言内置排序,选择取决于桶大小、性能和稳定性要求。本课使用 Python 的 list.sort(),它具有稳定排序特性。
复杂度与分布假设
设元素数量为 ,桶数量为 。分配元素需要 时间,创建和遍历桶需要 时间,因此不考虑桶内排序时,分桶与合并的总成本为 。真正的运行时间还取决于各桶内部的元素数量和所采用的排序算法。
设 是桶 i 的元素数。 等于 n 加上落入同一桶的不同元素有序对数。若 n 个元素独立且每个等概率落入 k 个桶,每对同桶的概率是 ,所以 。当 k 与 n 同阶时,即使桶内排序以平方时间作上界,总期望时间也为线性。若所有元素都复制自同一次均匀抽样,单个元素仍均匀,但它们始终同桶,独立假设失效。
最坏情况下,所有元素可能进入同一个桶,整体性能就由桶内排序决定。例如使用本课的 list.sort(),最坏时间复杂度为 ;如果使用普通插入排序,则可能退化为 。额外空间主要用于桶及其存放的元素,通常为 ,当 时为 。
正确性还依赖取值范围。本课的分桶公式仅适用于 [0, 1),其中 1.0 不属于合法输入,不能直接计算桶编号。对于一般闭区间 [minimum, maximum],可使用 min(k - 1, int((value - minimum) / (maximum - minimum) * k)) 计算桶编号;上下界相等时单独处理,浮点端点相差极大时还要防止减法溢出为无穷,必要时先用可验证的缩放方式归一化。即使公式正确,数据明显偏斜时也可能产生较大的桶。
完整可运行示例
将下面代码保存为 bucket_sort_demo.py。示例使用与数组长度相同的桶数量,调用 Python 的 list.sort() 完成桶内排序,并将结果写回原数组。函数接收可变列表。排序前验证元素是内置 int 或 float 且位于 [0, 1),范围判断也排除 NaN 和无穷大。
def bucket_sort(values):
    if not isinstance(values, list):
        raise TypeError("values must be a list")
    if not values:
        return values

    # 修改原数组之前先验证范围,拒绝 NaN、无穷大和 1.0。
    if any(type(value) not in (int, float) or not 0.0 <= value < 1.0
           for value in values):
        raise ValueError("all values must be finite numbers in [0, 1)")

    bucket_count = len(values)
    buckets = [[] for _ in range(bucket_count)]

    # 对浮点乘法的舍入误差做上界保护,避免索引越界。
    for value in values:
        index = min(int(value * bucket_count), bucket_count - 1)
        buckets[index].append(value)

    # 各桶内部排序后,按桶编号依次写回原数组。
    write_index = 0
    for bucket in buckets:
        bucket.sort()
        for value in bucket:
            values[write_index] = value
            write_index += 1

    return values


def main():
    numbers = [0.78, 0.17, 0.39, 0.26, 0.72, 0.94, 0.21, 0.12, 0.23, 0.68]
    print("排序前:", numbers)
    bucket_sort(numbers)
    print("排序后:", numbers)


if __name__ == "__main__":
    main()
在保存文件的目录中运行以下命令,使用 Python 3 执行程序。
python bucket_sort_demo.py预期输出
排序前: [0.78, 0.17, 0.39, 0.26, 0.72, 0.94, 0.21, 0.12, 0.23, 0.68]
排序后: [0.12, 0.17, 0.21, 0.23, 0.26, 0.39, 0.68, 0.72, 0.78, 0.94]
核对该样例时,除了检查非递减顺序,还可与 sorted 的结果逐项对照,确认未丢失或重复元素。函数会直接修改传入的列表,同时返回同一个列表;对于空列表则原样返回。将输入元素改为 1.0 或 float('nan') 时,程序会抛出 ValueError,而不是继续执行无效的分桶操作。
如果实际数据大量集中在少数几个桶中,应先检查桶索引公式是否覆盖完整取值范围,再观察各桶的元素数量。对于明显偏斜的数据,可以调整桶边界、采用非等宽桶,或者直接使用 list.sort() 等通用比较排序。桶排序适合取值范围明确、数据分布可预估的场景;当分布未知且难以控制时,不应仅凭平均线性复杂度就认定它一定更快。