
数据结构与算法 / 系统课时
邻接表
邻接表
邻接表为每个顶点维护一组实际相连的顶点,只为真实存在的边分配存储空间。它能高效枚举局部邻居,是稀疏图和图遍历算法中最常见的表示方式。本课将实现无向图邻接表,并与邻接矩阵比较查询、遍历和空间成本。
学习目标
- 理解邻接表中顶点数组与邻接集合的组织方式。
- 能实现添加边、删除边、查边和枚举邻接点操作。
- 能根据顶点数、边数和访问模式选择邻接表或邻接矩阵。
结构与工作方式
邻接表通常由一个长度为 的外层容器组成,第 u 个位置保存从顶点 u 出发的所有邻接点。无向边 (u, v) 需要同时把 v 加入 u 的集合,并把 u 加入 v 的集合;有向边只需要记录在起点一侧。
外层容器可以使用数组或 List,内层可使用动态数组、链表或集合。动态数组顺序遍历快,但删除指定邻接点可能需要移动元素;哈希集合能减少重复边并提供平均 的查找与删除,但会增加额外内存。实现应根据操作需求选择内层结构。
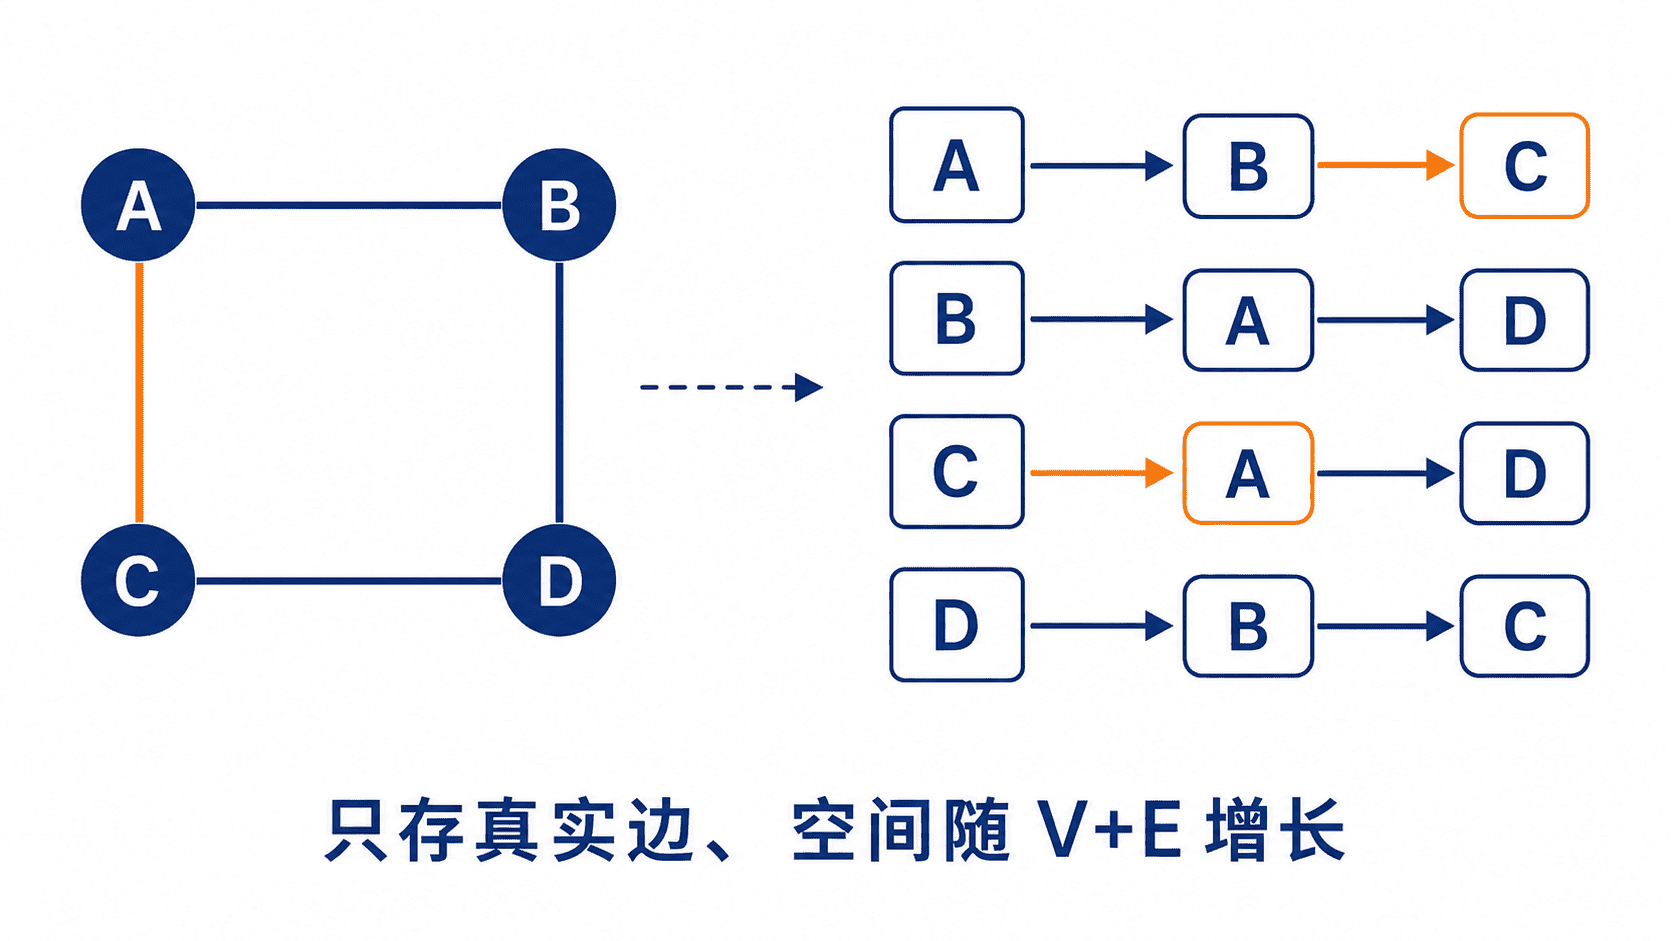
图中每条无向边出现两次,因此无向图所有邻接集合中的元素总数是 ;有向图中每条边只出现一次,总数是 。这也是邻接表空间复杂度写作 的原因。
操作成本与矩阵对比
设顶点 u 的度为 deg(u)。枚举 u 的邻接点只访问真实边,时间复杂度是 。是否能快速查边取决于内层结构:链表或动态数组通常为 ,哈希集合平均为 。
| 维度 | 邻接表 | 邻接矩阵 |
|---|---|---|
| 空间 | ||
枚举 u 的邻接点 |
||
判断 (u, v) 是否存在 |
取决于内层结构 | |
| 适合的图 | 稀疏图、遍历密集 | 稠密图、查边密集 |
邻接表并非在所有操作上都更快。若算法反复判断大量任意顶点对是否相邻,矩阵的直接下标访问更稳定;若算法主要从一个顶点扩展到它的邻居,例如深度优先搜索和广度优先搜索,邻接表通常更自然。
完整可运行示例
下面使用 LinkedHashSet 保存每个顶点的邻接集合。它既能避免重复边,又能保持插入顺序,使示例输出稳定。neighbors 返回不可修改的副本,避免调用者绕过图的接口直接破坏内部数据。
import java.util.ArrayList;
import java.util.Collections;
import java.util.LinkedHashSet;
import java.util.List;
import java.util.Set;

public class AdjacencyListDemo {

    private final String[] vertices;
    private final List<Set<Integer>> adjacencyList;

    public AdjacencyListDemo(String[] vertices) {
        this.vertices = vertices.clone();
        this.adjacencyList = new ArrayList<>();

        for (int i = 0; i < vertices.length; i++) {
            adjacencyList.add(new LinkedHashSet<>());
        }
    }

    public void addUndirectedEdge(int from, int to) {
        validateVertex(from);
        validateVertex(to);
        adjacencyList.get(from).add(to);
        adjacencyList.get(to).add(from);
    }

    public void removeUndirectedEdge(int from, int to) {
        validateVertex(from);
        validateVertex(to);
        adjacencyList.get(from).remove(to);
        adjacencyList.get(to).remove(from);
    }

    public boolean hasEdge(int from, int to) {
        validateVertex(from);
        validateVertex(to);
        return adjacencyList.get(from).contains(to);
    }

    public List<String> neighbors(int vertex) {
        validateVertex(vertex);
        List<String> result = new ArrayList<>();

        for (int neighbor : adjacencyList.get(vertex)) {
            result.add(vertices[neighbor]);
        }
        return Collections.unmodifiableList(result);
    }

    public void printGraph() {
        for (int i = 0; i < vertices.length; i++) {
            System.out.println(vertices[i] + " -> " + neighbors(i));
        }
    }

    private void validateVertex(int vertex) {
        if (vertex < 0 || vertex >= vertices.length) {
            throw new IllegalArgumentException("顶点下标越界: " + vertex);
        }
    }

    public static void main(String[] args) {
        String[] vertices = {"A", "B", "C", "D"};
        AdjacencyListDemo graph = new AdjacencyListDemo(vertices);

        graph.addUndirectedEdge(0, 1);
        graph.addUndirectedEdge(0, 2);
        graph.addUndirectedEdge(1, 3);
        graph.addUndirectedEdge(2, 3);

        System.out.println("初始邻接表:");
        graph.printGraph();
        System.out.println("B 与 C 相邻: " + graph.hasEdge(1, 2));
        System.out.println("D 的邻接点: " + graph.neighbors(3));

        graph.removeUndirectedEdge(1, 3);
        System.out.println("删除 B-D 后:");
        graph.printGraph();
    }
}
预期输出
初始邻接表:
A -> [B, C]
B -> [A, D]
C -> [A, D]
D -> [B, C]
B 与 C 相邻: false
D 的邻接点: [B, C]
删除 B-D 后:
A -> [B, C]
B -> [A]
C -> [A, D]
D -> [C]
边界与实现选择
无向图添加和删除边时必须更新两端,否则会产生单向残留。使用允许重复元素的 List 时,还要决定是否允许平行边;若不允许,应在插入前检查或改用 Set。自环 (u, u) 在无向图中也需要明确计数规则,因为它对顶点度的贡献通常按 2 计算。
带权图可以把邻接点编号替换为包含 to 与 weight 的边对象。有向图还可同时维护出边表和入边表,以便分别高效计算出度、入度及反向遍历。若顶点会动态增加,外层使用可扩容的 List 比固定二维矩阵更灵活。
本课练习
- 增加
degree(int vertex),返回无向图顶点的度,并验证删除B-D后顶点B的度从2变为1。 - 将内层结构替换为
ArrayList<Integer>,处理重复边,并比较hasEdge与删除操作的复杂度变化。 - 扩展为带权有向图,定义边对象保存终点和权值,要求支持添加
A -> C、查询其权值并打印所有出边。
本课总结
- 邻接表只保存真实存在的边,空间复杂度为 ,适合稀疏图。
- 枚举邻接点只需访问当前顶点的邻接集合,成本是 。
- 内层容器决定查边、去重、删除和遍历顺序,选择时应结合算法的主要操作。
下一课预告
接下来可以在邻接表上实现广度优先搜索和深度优先搜索,进一步观察不同图表示如何影响遍历过程、复杂度和访问顺序。