
数据结构与算法 / 系统课时
朴素字符串匹配
朴素字符串匹配
朴素字符串匹配不预处理模式串,而是把模式依次对齐到文本的每个候选位置,再从左到右逐字符比较。它实现直接、结果可靠,也是理解 KMP 等优化算法为何能够减少重复比较的最佳起点。
学习目标
- 能独立实现返回全部匹配位置的朴素匹配算法。
- 能追踪每次对齐中的字符比较与失配位置。
- 能分析算法的最好、最坏时间复杂度及边界条件。
核心思路
文本长度为 n,模式长度为 m。当 m <= n 时,模式共有 n - m + 1 个候选起始位置。算法按下标 0 到 n - m 依次尝试:
- 将模式首字符与当前起始位置对齐。
- 从左到右比较对应字符。
- 遇到失配立即停止本轮比较,并把模式右移一位。
- 若连续比较完
m个字符仍未失配,则记录当前起始下标。 - 继续右移一位,以保留重叠匹配。
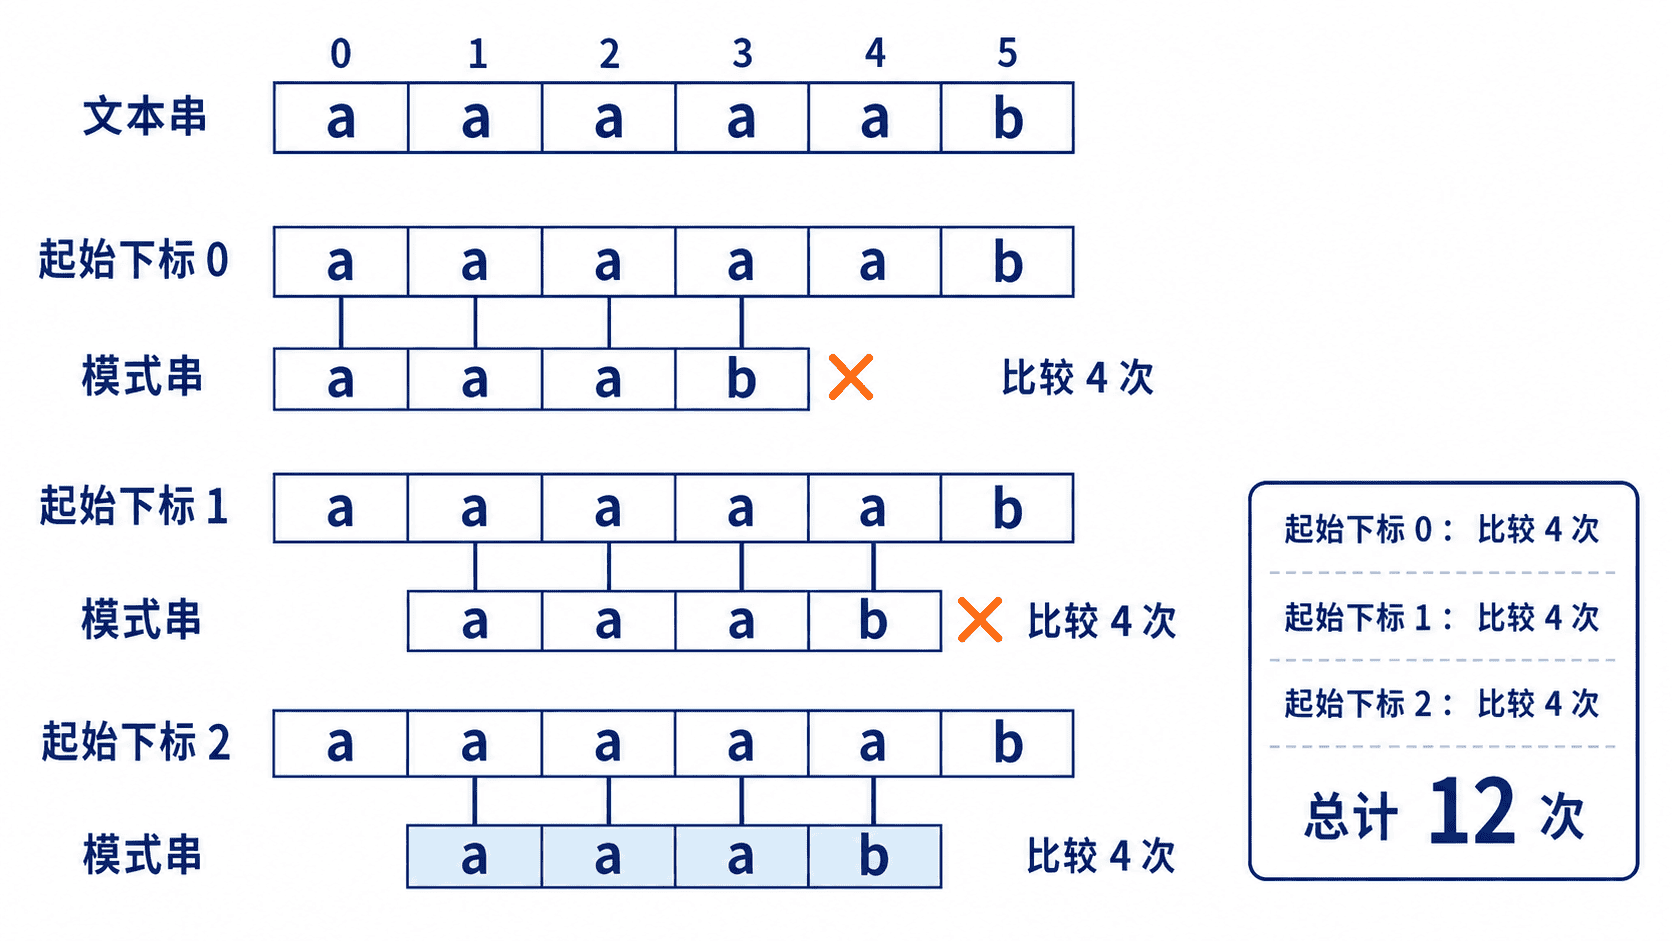
执行过程与重复比较
以文本 aaaaab、模式 aaab 为例,前三个字符在多个候选位置上反复比较。模式在下标 0 和 1 处都比较到最后一个字符才失配,在下标 2 处才完整匹配。
| 起始下标 | 比较过程 | 本轮比较次数 | 结果 |
|---|---|---|---|
0 |
a=a、a=a、a=a、a!=b |
4 | 失配 |
1 |
a=a、a=a、a=a、a!=b |
4 | 失配 |
2 |
a=a、a=a、a=a、b=b |
4 | 匹配 |
朴素算法没有记住前两轮已经确认过的重复结构,因此总共执行了 12 次字符比较。这正是后续字符串算法试图削减的成本。
完整可运行示例
下面的 Python 实现返回全部匹配位置,并统计实际字符比较次数。空模式串被视为非法输入;模式比文本长时直接返回空结果。
python
def naive_search(text: str, pattern: str) -> tuple[list[int], int]:
    if pattern == "":
        raise ValueError("pattern must not be empty")

    n = len(text)
    m = len(pattern)
    if m > n:
        return [], 0

    positions = []
    comparisons = 0

    for start in range(n - m + 1):
        matched = True

        # 每轮从模式首字符开始,失配后立即停止。
        for offset in range(m):
            comparisons += 1
            if text[start + offset] != pattern[offset]:
                matched = False
                break

        if matched:
            positions.append(start)

    return positions, comparisons

def main() -> None:
    text = "aaaaab"
    pattern = "aaab"
    positions, comparisons = naive_search(text, pattern)

    print("文本:", text)
    print("模式:", pattern)
    print("匹配位置:", positions)
    print("字符比较次数:", comparisons)

if __name__ == "__main__":
    main()
将代码保存为 naive_string_match.py,再运行:
bash
python naive_string_match.py预期输出
text
文本: aaaaab
模式: aaab
匹配位置: [2]
字符比较次数: 12
复杂度与边界
最坏情况下,每个候选位置都要比较 m 个字符,因此时间复杂度为 ,通常写作 。例如文本和模式都由大量相同字符组成,且只在末尾失配时,会接近最坏情况。
若每轮都在第一个字符失配,总比较次数与候选位置数量同阶,最好时间复杂度为 。除返回结果所需的空间外,算法只使用常数个变量,额外空间复杂度为 。
Tips 与常见错误
保留重叠匹配时,每轮成功后仍只右移一位。若按模式长度跳转,aaaa 中的 aa 将漏掉下标 1 和 2 的匹配。
循环上界必须包含最后一个候选位置,正确范围是 0 到 n - m。写成 range(n - m) 会漏检末尾对齐。比较计数应在每次实际字符比较前增加,不能按候选位置直接估算。
本课练习
- 修改示例,使其在文本
abababa中查找aba,验收条件是返回[0, 2, 4],并输出实际比较次数。 - 为
naive_search编写至少四组测试,覆盖模式比文本长、完全匹配、完全失配和重叠匹配。 - 构造一组长度分别为
n和m的输入,使算法尽量接近最坏情况,并解释每轮为何要比较到模式末尾。
本课总结
- 朴素匹配会检查全部
n - m + 1个候选位置,并在每轮失配后右移一位。 - 最坏时间复杂度为 ,性能瓶颈来自重复比较已经出现过的字符结构。
- 正确实现必须处理末尾候选位置、重叠匹配、空模式和模式过长等边界。
下一课预告
下一阶段将学习如何利用模式串自身的重复结构减少回退与重复比较,为理解 KMP 等高效字符串匹配方法建立基础。
按自己的节奏,确认真正理解。