
数据结构与算法 / 系统课时
快速选择算法
快速选择算法
快速选择只处理可能包含目标元素的一侧分区,因此无需像快速排序那样整理全部数据。本课将从第 k 小元素的定义出发,实现支持重复元素的随机化快速选择程序,并说明它为什么具有线性期望时间。
学习目标
- 理解分区结果与第
k小元素之间的关系。 - 能够实现并运行随机化快速选择算法。
- 能够判断期望复杂度、最坏复杂度和边界条件。
问题定义与核心思路
给定长度为 n 的无序序列和从 1 开始计数的 k,目标是返回排序后位于第 k 个位置的元素。完整排序能够解决问题,但会执行许多与目标位置无关的工作。
快速选择先选枢轴。原图用单一枢轴位置说明“只沿目标所在侧继续”。下方代码把同值元素一次划成中间区间,用三个区间处理重复键。
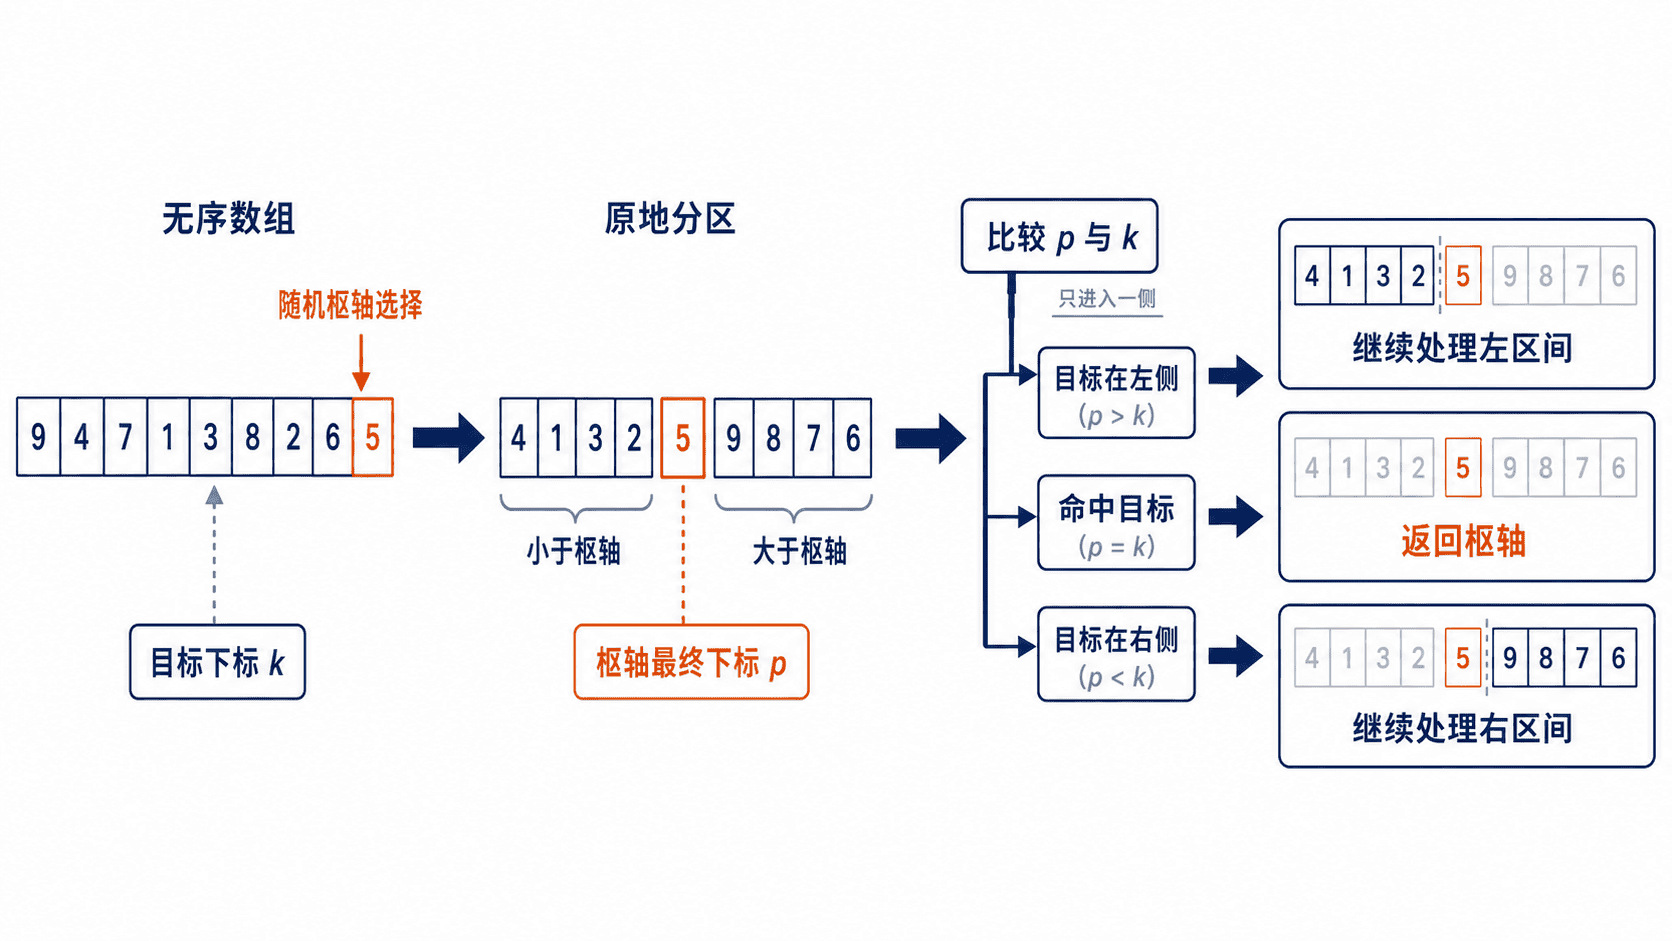
当前区间为 [lo, hi)。分区后 [lo, lt) 小于枢轴,[lt, gt) 等于枢轴,[gt, hi) 大于枢轴。目标下标小于 lt 时只保留左侧,大于等于 gt 时只保留右侧,落在中间立即返回枢轴。全相等输入只需一次分区。
执行过程与复杂度
一次分区会线性扫描当前区间,成本为 ,其中 m 是当前区间长度。每次均匀抽当前区间的一个下标。按秩看,去掉两端各约四分之一后,至少一半的枢轴能将下一段长度降到原来的至多四分之三,等值合并不会扩大该段。每一阶段期望只需常数次扫描,阶段规模按几何级数递减,故总期望为 O(n)。互异输入若反复选极端枢轴,最坏仍可达 Θ(n²)。期望针对随机选择,固定演示种子只用于复现。
本课实现会复制输入序列,额外占用 空间,以避免修改调用方数据。若允许原地修改数组,循环版本的额外空间可以降到 。
需要特别检查以下边界:
k必须满足1 <= k <= n。- 空序列不存在合法的第
k小元素。 - 重复值允许存在;“第
k小”按排序后的位置计算,而不是按不同值的排名计算。
完整可运行示例
将下面代码保存为 quickselect_demo.py。函数接收可比较的整数序列,不修改原输入。演示传入固定种子,默认可不指定种子。
from random import Random

def partition3(values, lo, hi, pivot):
    lt, index, gt = lo, lo, hi
    while index < gt:
        if values[index] < pivot:
            values[lt], values[index] = values[index], values[lt]
            lt += 1
            index += 1
        elif values[index] > pivot:
            gt -= 1
            values[index], values[gt] = values[gt], values[index]
        else:
            index += 1
    return lt, gt

def quickselect(values, k, seed=None):
    if type(k) is not int or not 1 <= k <= len(values):
        raise ValueError("k 必须是 1 到序列长度之间的整数")
    data = list(values)
    target = k - 1
    lo, hi = 0, len(data)
    rng = Random(seed)
    while lo < hi:
        pivot = data[rng.randrange(lo, hi)]
        lt, gt = partition3(data, lo, hi, pivot)
        if target < lt:
            hi = lt
        elif target >= gt:
            lo = gt
        else:
            return pivot
    raise AssertionError("目标下标始终应该在有效区间")

if __name__ == "__main__":
    numbers = [9, 1, 8, 2, 7, 3, 6, 4, 5]
    for k in (1, 4, 9):
        print(f"第 {k} 小元素: {quickselect(numbers, k, seed=42)}")
    print(f"原数组: {numbers}")
运行命令如下:
python quickselect_demo.py预期输出
第 1 小元素: 1
第 4 小元素: 4
第 9 小元素: 9
原数组: [9, 1, 8, 2, 7, 3, 6, 4, 5]
常见错误与练习
常见错误是把 k 直接当作数组下标。题目中的第 k 小通常从 1 开始计数,而 Python 下标从 0 开始,因此必须转换为 target = k - 1。另一个错误是分区后继续处理两侧,这会把快速选择重新变成接近快速排序的工作量。
练习一:修改程序,使它返回第 k 大元素。输入仍使用从 1 开始的 k,并用包含重复值的数组验证结果。
练习二:统计每次查询执行的元素比较次数,分别测试随机数组、升序数组和降序数组。验收条件是程序能够输出答案与比较次数,固定每组的种子集合、目标秩和分布,分别看分区次数与实际扫描量。升降序本身不会使均匀随机枢轴偏向极端。
本课总结
- 三路快速选择利用等值区间立即返回或排除一整侧数据。
- 随机枢轴带来 的期望时间,但最坏情况仍为 。
- 正确实现必须处理
k的计数方式、重复值和输入保护。
下一课预告
下一课将学习“确定性线性选择”,通过五元素分组和中位数的中位数保证枢轴的质量,把最坏时间复杂度也保证为线性。