
数据结构与算法 / 系统课时
随机化算法
随机化算法
随机化算法把随机选择纳入计算过程,用来打破固定输入结构、降低对抗性数据的影响,或用可控错误概率换取速度。本课将区分两类随机化模型,并通过随机快速排序理解“结果始终正确、运行时间具有随机性”的分析方式。
学习目标
- 区分拉斯维加斯算法与蒙特卡洛算法的保证。
- 解释随机快速排序的最坏时间与期望时间。
- 使用固定随机种子复现实验,并识别安全随机场景。
为什么引入随机性
确定性算法对同一输入总是走相同路径。如果输入刚好触发坏情况,或者数据由对手刻意构造,性能可能持续恶化。随机化通过打乱选择,使输入结构难以稳定控制算法行为。
随机性不会自动消除最坏情况。它改变的是坏情况出现的概率或期望成本,因此分析时必须说明随机变量来自哪里、期望对哪些随机选择取平均,以及算法是否允许错误答案。
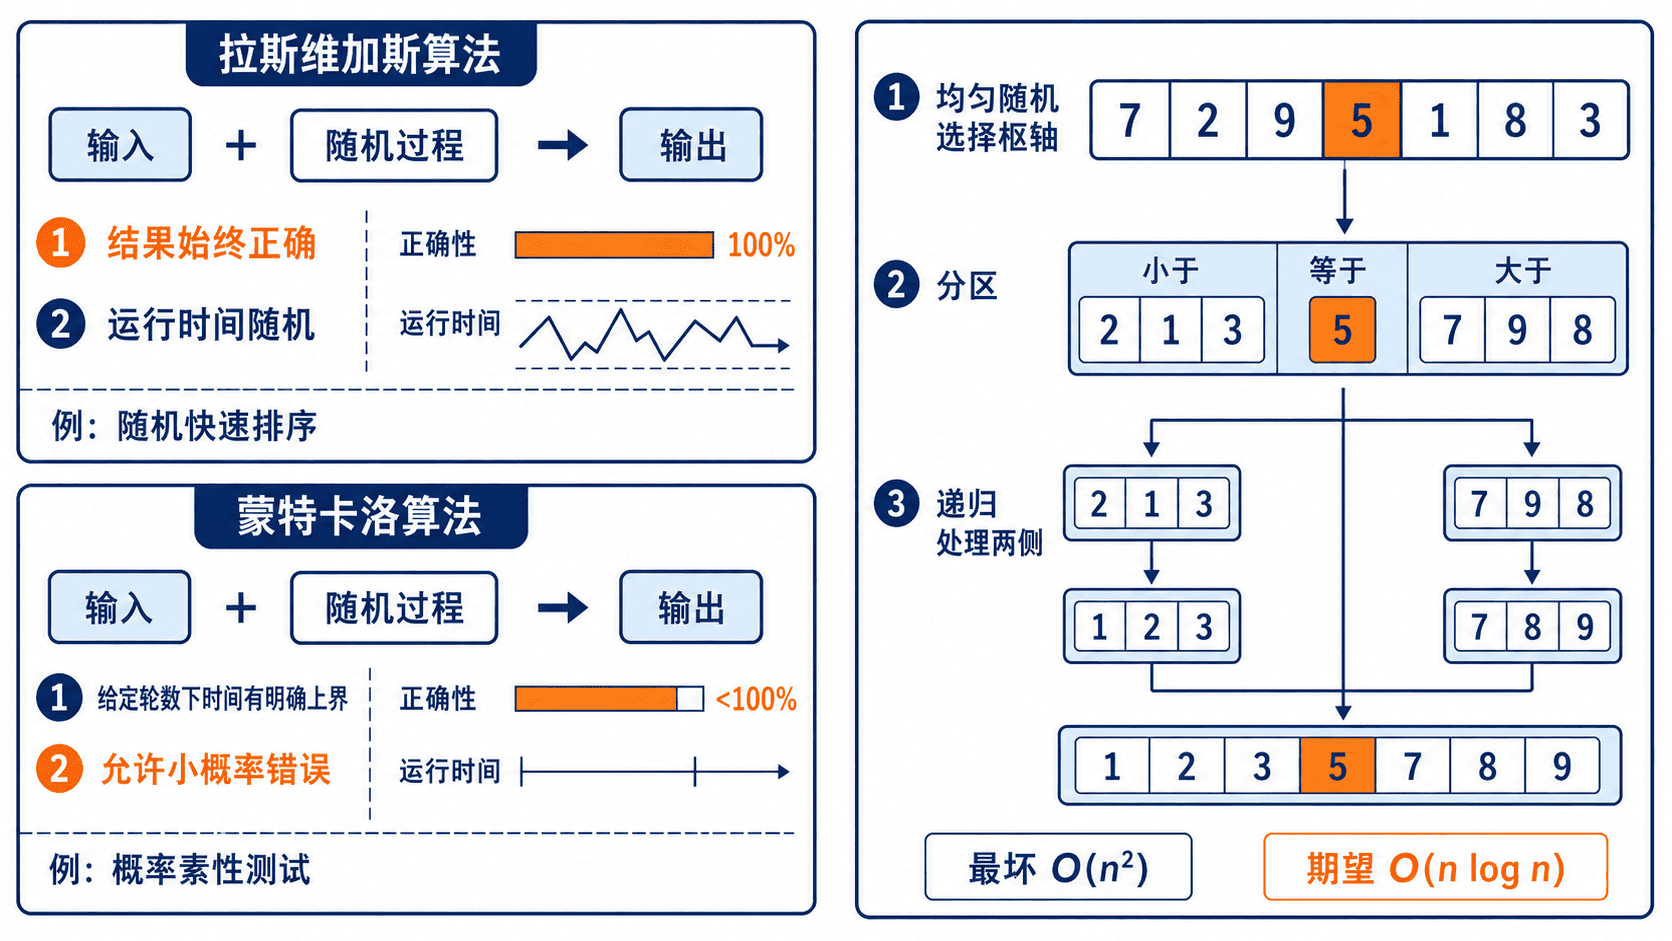
两类随机化算法
| 类型 | 正确性保证 | 时间特征 | 典型例子 |
|---|---|---|---|
| 拉斯维加斯算法 | 只要终止,输出一定正确 | 运行时间受随机选择影响,通常分析期望时间 | 随机快速排序、随机选择算法 |
| 蒙特卡洛算法 | 允许可量化的小概率错误 | 给定迭代轮数后,运行时间通常有明确上界 | Miller-Rabin 概率素性测试、随机指纹算法 |
拉斯维加斯算法可以多花时间,但不能返回错误结果。蒙特卡洛算法则在规定计算预算内给出答案,代价是存在错误概率。独立重复通常可以降低错误概率,但降低幅度必须根据具体算法证明。
随机快速排序的分析
快速排序的分区工作与普通版本相同,区别在于每次从当前子数组中均匀随机选择枢轴。无论枢轴如何选择,只要分区和递归实现正确,最终排序结果都正确,因此它属于拉斯维加斯算法。
若每次都选到极端元素,递归规模会变成 与 ,最坏时间仍是 。但随机枢轴使持续极端分割的概率很低,对内部随机选择取期望后,比较次数为 。
期望复杂度不是“多数输入上的复杂度”,而是固定输入后,对算法内部随机选择求平均。即使输入已经升序排列,只要枢轴均匀随机选择,期望时间仍保持 。
可运行示例
下面的 Python 示例使用独立的 random.Random 实例选择枢轴。固定种子只用于让实验可复现,排序正确性不依赖某个特定种子。
import random

def randomized_quicksort(values, rng):
    if len(values) <= 1:
        return values.copy()

    # 枢轴在当前子数组中均匀随机选择,避免固定位置造成输入偏置。
    pivot = values[rng.randrange(len(values))]
    less = [value for value in values if value < pivot]
    equal = [value for value in values if value == pivot]
    greater = [value for value in values if value > pivot]

    return (
        randomized_quicksort(less, rng)
        + equal
        + randomized_quicksort(greater, rng)
    )

def main():
    numbers = [9, 1, 5, 3, 9, 2, 8]
    rng = random.Random(7)

    print("原数组:", numbers)
    print("排序后:", randomized_quicksort(numbers, rng))

if __name__ == "__main__":
    main()
保存为 randomized_quicksort_demo.py 后运行:
python randomized_quicksort_demo.py预期输出
原数组: [9, 1, 5, 3, 9, 2, 8]
排序后: [1, 2, 3, 5, 8, 9, 9]
该实现为了突出随机枢轴与三路分区,使用额外列表,并不是原地快速排序。无论随机选择顺序如何,输出都保持升序;变化的是递归形状和实际比较成本。
Tips 与常见错误
- 单元测试中可以固定种子以复现失败路径,但性能评估应使用多个种子并报告平均值或分布。
- Python 的
random适合模拟与一般算法实验,不适合生成密码、令牌或密钥;安全随机值应使用secrets。 - 不要把期望 写成最坏 。随机快速排序仍存在最坏 路径。
- 蒙特卡洛算法必须给出错误类型和概率上界,不能只说“结果大概率正确”。
本课练习
- 修改示例,统计每次分区处理的元素数量,并使用 20 个不同种子运行同一数组。验收条件是输出每次统计值、计算平均值,并保证每次排序结果正确。
- 设计一个重复执行的蒙特卡洛判定流程。已知单次错误概率不超过 且各轮独立。验收条件是写出执行 轮后的错误概率上界,并说明如何根据目标错误率选择 。
本课总结
- 拉斯维加斯算法保证结果正确,随机性影响运行时间;蒙特卡洛算法允许可控错误概率。
- 随机快速排序的最坏时间仍为 ,期望时间为 。
- 固定种子适合复现实验,不应被误当作安全随机机制或完整性能结论。
下一课预告
下一阶段将继续学习在精确求解代价过高时,如何用近似算法给出可证明的质量保证,并在运行时间与解的精度之间建立可解释的权衡。