
数据结构与算法 / 系统课时
可判定问题与计算模型
可判定问题与计算模型
复杂性分析不仅要比较程序快慢,还要先确认问题能否由明确的计算过程解决。本课从判定问题入手,把输入、计算步骤和接受或拒绝结果统一到抽象计算模型中,为后续讨论可计算性与复杂度类别建立共同语言。
学习目标
- 区分判定问题、函数问题与优化问题。
- 理解计算模型为何要抽象机器细节并保留基本计算能力。
- 能用输入规模和计算步骤描述一个算法的时间复杂度。
判定问题
判定问题要求对每个合法输入回答“是”或“否”。例如:给定无向图和两个顶点,二者是否连通;给定整数 ,它是否为素数;给定字符串,它是否属于某个语言。
一个判定问题可以看成输入集合上的布尔函数。把所有答案为“是”的输入收集起来,就得到一个语言 。算法接受输入 时,若 属于 ,输出接受;否则输出拒绝。使用语言描述后,不同领域的问题可以放进统一框架分析。
函数问题要求计算具体值,例如求最短路径长度;优化问题要求在多个可行解中寻找最好结果。它们常能转化为判定问题,例如把“最短路径是否不超过 ”作为判定版本,但转化后需要保留输入参数和答案之间的关系。
| 问题类型 | 典型输出 | 示例 |
|---|---|---|
| 判定问题 | 是或否 | 图中是否存在长度不超过 的路径 |
| 函数问题 | 一个确定值 | 两点之间的最短路径长度 |
| 优化问题 | 最优可行解 | 找到总权重最小的路径 |
抽象计算模型
真实计算机有不同指令集、字长和存储层次。如果复杂性结论依赖某一款处理器,就难以比较算法。因此理论分析使用抽象计算模型,只规定基本状态、可执行操作和一步计算的含义。
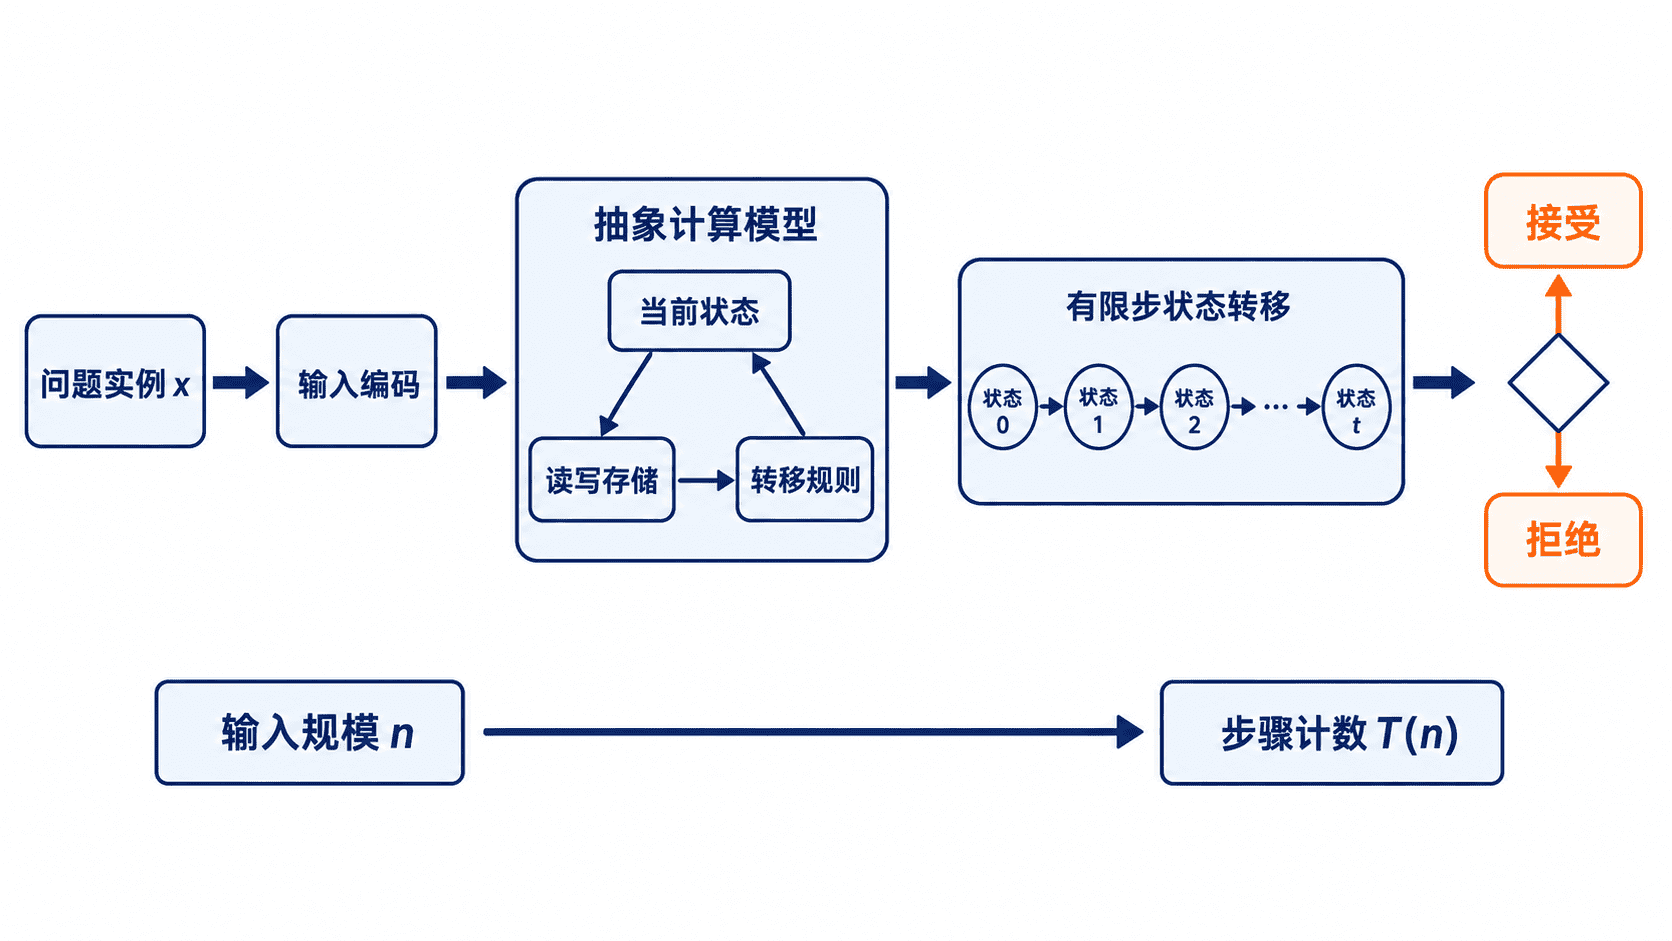
常见模型包括图灵机、随机存取机和电路模型。它们的操作方式不同,但在合理条件下通常能够相互模拟。复杂性理论关注的不是某条机器指令耗时多少纳秒,而是输入规模增长时,所需步骤数量如何增长。
计算模型必须同时明确三件事:输入如何编码、哪些操作算一步、程序在何种状态下停止。若编码方式允许把大量信息压进一个“常数大小”的符号,或把复杂运算视为一步,就会扭曲复杂度结论。
计算步骤与复杂性
设输入长度为 ,算法在最坏情况下执行的基本步骤数为 。渐近分析忽略固定机器造成的常数差异,关注 增长时的主导项。例如 通常记为 。
“可判定”比“高效可判定”要求更弱。只要存在一个对所有合法输入都能在有限步骤内停止并给出正确答案的算法,问题就是可判定的;即使算法需要极长时间,它仍然可判定。若某个过程可能在部分输入上永不停止,它不能作为该问题的判定算法。
分析一个判定过程时,可以按以下顺序检查:
- 输入集合和编码是否明确。
- 每一步允许执行的操作是否明确。
- 对所有合法输入是否保证停止。
- 停止时是否总能给出正确的接受或拒绝结果。
- 步骤数量与输入规模之间是什么关系。
易混淆点
“尚未找到算法”不等于“不可判定”。证明不可判定需要严格论证不存在任何满足条件的算法,而不是指出现有实现很慢。类似地,指数时间算法虽然通常不实用,但仍可能是完全有效的判定算法。
“程序在测试数据上结束”也不等于“对所有输入保证结束”。复杂性与可判定性讨论的是完整输入集合。遗漏极端输入、非法编码或循环状态,会使经验观察无法替代理论保证。
另一个混淆是把硬件并行度直接当作复杂度下降。更多处理器可能减少实际运行时间,但若分析模型改变,就必须同时说明处理器数量、通信成本和并行步骤,否则不能与原来的单机步骤数直接比较。
本课总结
- 判定问题把答案统一为接受或拒绝,并可等价表示为语言成员关系。
- 抽象计算模型通过统一输入编码、基本操作和停止条件,使不同算法的复杂度可以比较。
- 可判定要求所有合法输入都在有限步骤内得到正确答案,高效性则进一步研究步骤数随输入规模的增长速度。
下一课预告
下一阶段将继续讨论可计算性与复杂性边界,并逐步引入用于比较问题难度、随机化效果和近似质量的分析方法。