
数据结构与算法 / 系统课时
算法学习路线
算法学习路线
学习算法时,最容易遇到的问题不是某个知识点太难,而是不知道先学什么、后学什么。本课将复杂度、数据结构、设计范式和经典问题串成一条依赖清晰的路线,帮助你建立可执行的学习顺序,并理解每个阶段应达到的能力标准。
学习目标
- 说明复杂度、数据结构、设计范式和经典问题之间的依赖关系。
- 按照从分析到实现、从基础到综合的顺序规划学习路径。
- 为每个阶段选择合适的练习方式和验收标准。
学习路线总览
算法学习不是按名词清单逐项记忆,而是沿着“分析工具 → 数据组织 → 解题方法 → 综合应用”的路径逐步积累。复杂度负责判断方案是否可行,数据结构决定信息如何存放与访问,设计范式提供组织解法的通用思路,经典问题则用于综合验证这些能力。
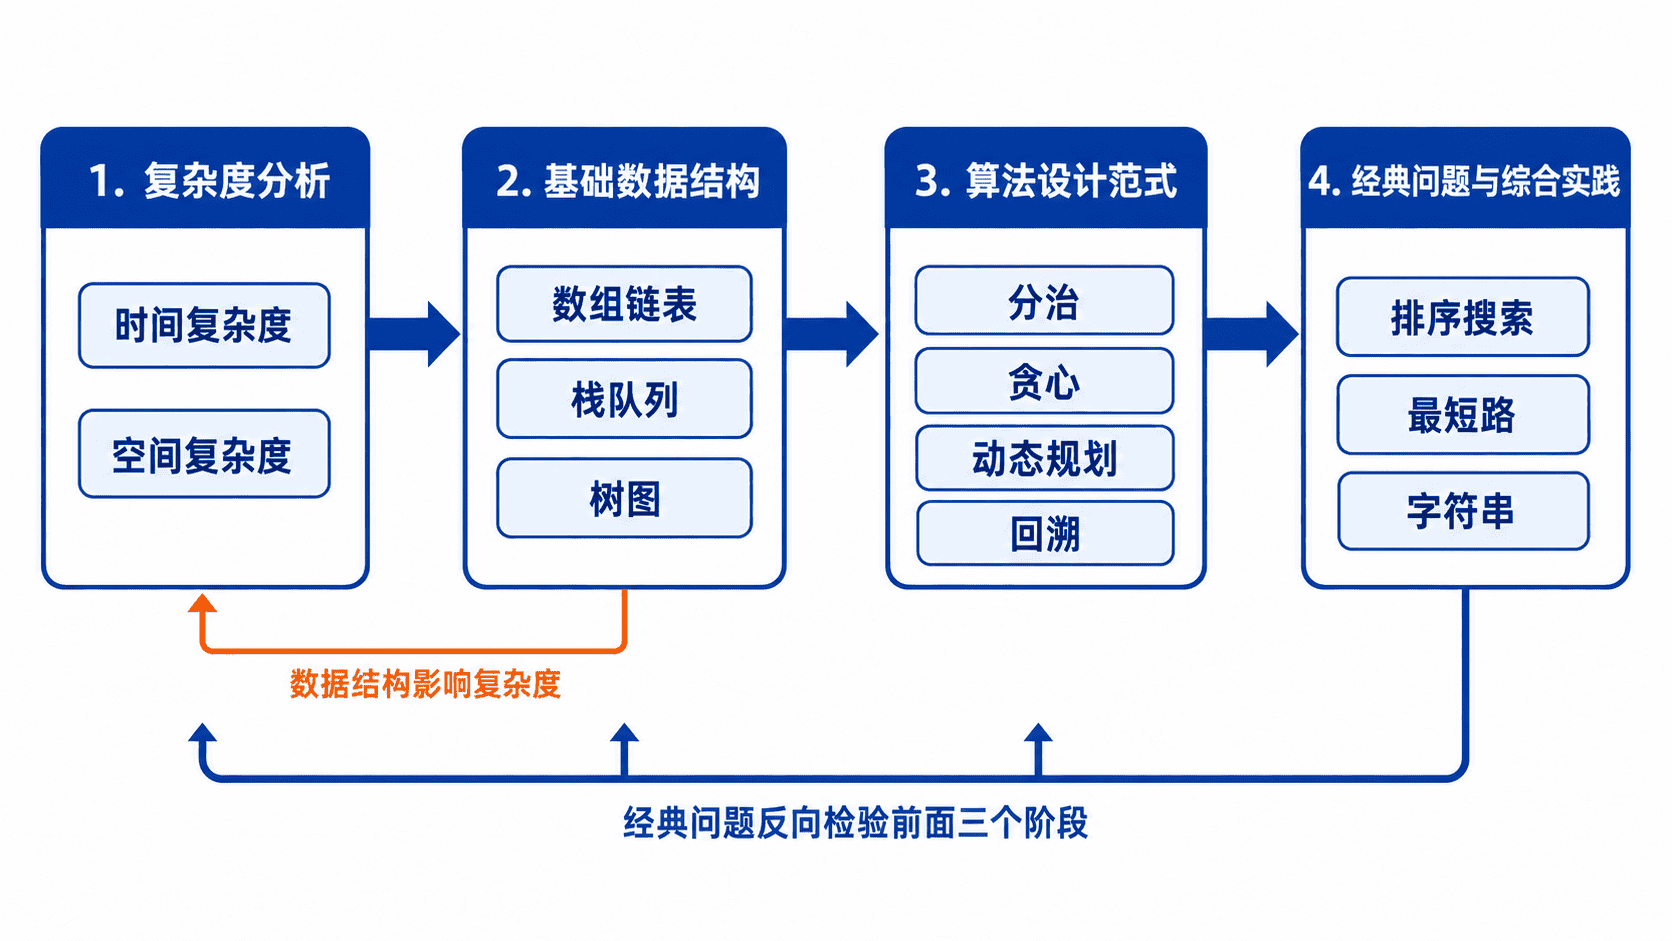
这条路线并不是完全单向的。学习数据结构时会不断使用复杂度分析;接触经典问题后,也会发现自己需要回头补强某种结构或范式。正确做法是按主线前进,同时通过练习形成小范围循环,而不是等所有理论都学完再开始做题。
四个核心模块
| 模块 | 核心问题 | 典型内容 | 阶段验收 |
|---|---|---|---|
| 复杂度分析 | 方案随输入规模增长得有多快 | 渐近记号、最好与最坏情况、时间与空间权衡 | 能解释一个实现的主要耗时来源 |
| 数据结构 | 数据如何组织才能高效访问和修改 | 数组、链表、栈、队列、哈希表、树、图 | 能根据操作需求选择结构 |
| 设计范式 | 如何把问题拆成可复用的解题步骤 | 分治、贪心、动态规划、回溯 | 能识别状态、选择和子问题 |
| 经典问题 | 如何综合运用分析、结构和范式 | 排序、搜索、最短路、字符串匹配 | 能独立完成建模、实现和验证 |
可以先学少量循环计数,再与数据结构练习交替推进。复杂度提供比较不同规模的语言,实际时限还取决于常数、输入分布、运行环境和预处理开销。例如在同一成本模型下,线性与平方级增长在大输入上差别明显。规模较小时先测量目标场景再判断。随后学习数据结构,才能理解同一操作为何在不同结构上具有不同成本。
设计范式不应被当成固定模板背诵。分治强调拆分和合并,贪心强调当前选择的可证明正确性,动态规划强调重叠子问题与状态转移,回溯强调系统枚举与剪枝。经典问题的价值,是让你判断何时使用这些方法,而不是记住某一道题的答案。
推荐学习顺序
- 先掌握渐近复杂度、循环计数和递归规模分析,能够估算常见代码的时间与空间成本。
- 再学习数组、链表、栈、队列、哈希表、树和图,重点比较查询、插入、删除与遍历的代价。
- 在结构基础上学习分治、贪心、动态规划和回溯,每种范式都完成“识别特征、写出状态、证明正确、分析复杂度”四步。
- 最后通过排序、二分查找、图搜索、最短路和字符串问题进行综合训练,并记录错误原因。
每个阶段都应采用“理解一个概念、手工推演一个例子、实现一个程序、分析一次复杂度”的闭环。只看讲解会形成熟悉感,但无法暴露边界条件、状态定义和实现细节中的问题。
做一次可复算的查找对比
用 64 个有序偶数练习。分别找第一个元素与一个不存在的元素,计数只记录访问了几个位置。二分的前提是输入升序且能按下标高效读取。这里用左闭右开区间,每轮排除当前位置和不可能的一侧。
def linear_contains(values, target):
    for inspected, value in enumerate(values, 1):
        if value == target:
            return True, inspected
    return False, len(values)

def binary_contains(values, target):
    lo, hi = 0, len(values)
    inspected = 0
    while lo < hi:
        mid = (lo + hi) // 2
        inspected += 1
        if values[mid] == target:
            return True, inspected
        if values[mid] < target:
            lo = mid + 1
        else:
            hi = mid
    return False, inspected

ordered = list(range(0, 128, 2))
for target in (0, 127):
    print(target, linear_contains(ordered, target), binary_contains(ordered, target))
查找 0 时,顺序检查 1 个位置,二分检查 7 个。查找 127 时,顺序检查 64 个,二分检查 6 个。若原数据无序,先排序的成本也要计入。单次查询、多次查询和数据经常更新是三个不同场景。练习时分别列出输入前提、应返回的结果、检查次数与预处理成本。
本课总结
- 算法学习的主线是复杂度分析、数据结构、设计范式和经典问题,四者前后依赖又相互反馈。
- 每个阶段都应同时完成概念理解、手工推演、代码实现和复杂度分析。
- 学习路线的目标不是覆盖更多名词,而是建立从问题建模到验证结果的完整过程。
下一课预告
下一课将学习“伪代码阅读规范”,统一赋值、循环、条件、函数调用和数组下标等表达方式,为后续阅读算法描述与手工推演执行过程做好准备。