
数据结构与算法 / 系统课时
多模式匹配思路
多模式匹配思路
单模式匹配一次只寻找一个关键词;当关键词数量增多时,逐个扫描文本会反复读取相同字符。本课通过 Trie 树与失败转移,建立一次扫描即可同时匹配多个模式串的基本方法,并用可运行程序验证匹配结果。
学习目标
- 理解普通 Trie 在失配时为何会重复回退。
- 掌握失败指针、输出集合与文本扫描的协作方式。
- 能分析多模式匹配的构建、查询复杂度和边界条件。
问题与核心思路
设模式集合为 he、she、his、hers,文本为 ushers。若分别使用单模式算法,需要对文本重复扫描;Trie 虽能共享公共前缀,但一旦当前边不存在,仍不知道应该跳到哪个可继续匹配的前缀状态。
解决办法是在 Trie 的每个节点上增加 fail 指针。它指向“当前字符串的最长真后缀,同时也是某个模式前缀”对应的节点。失配时沿失败指针转移,不必把文本指针退回。节点还保存 output 集合,用于记录到达该状态时已经匹配完成的模式串。
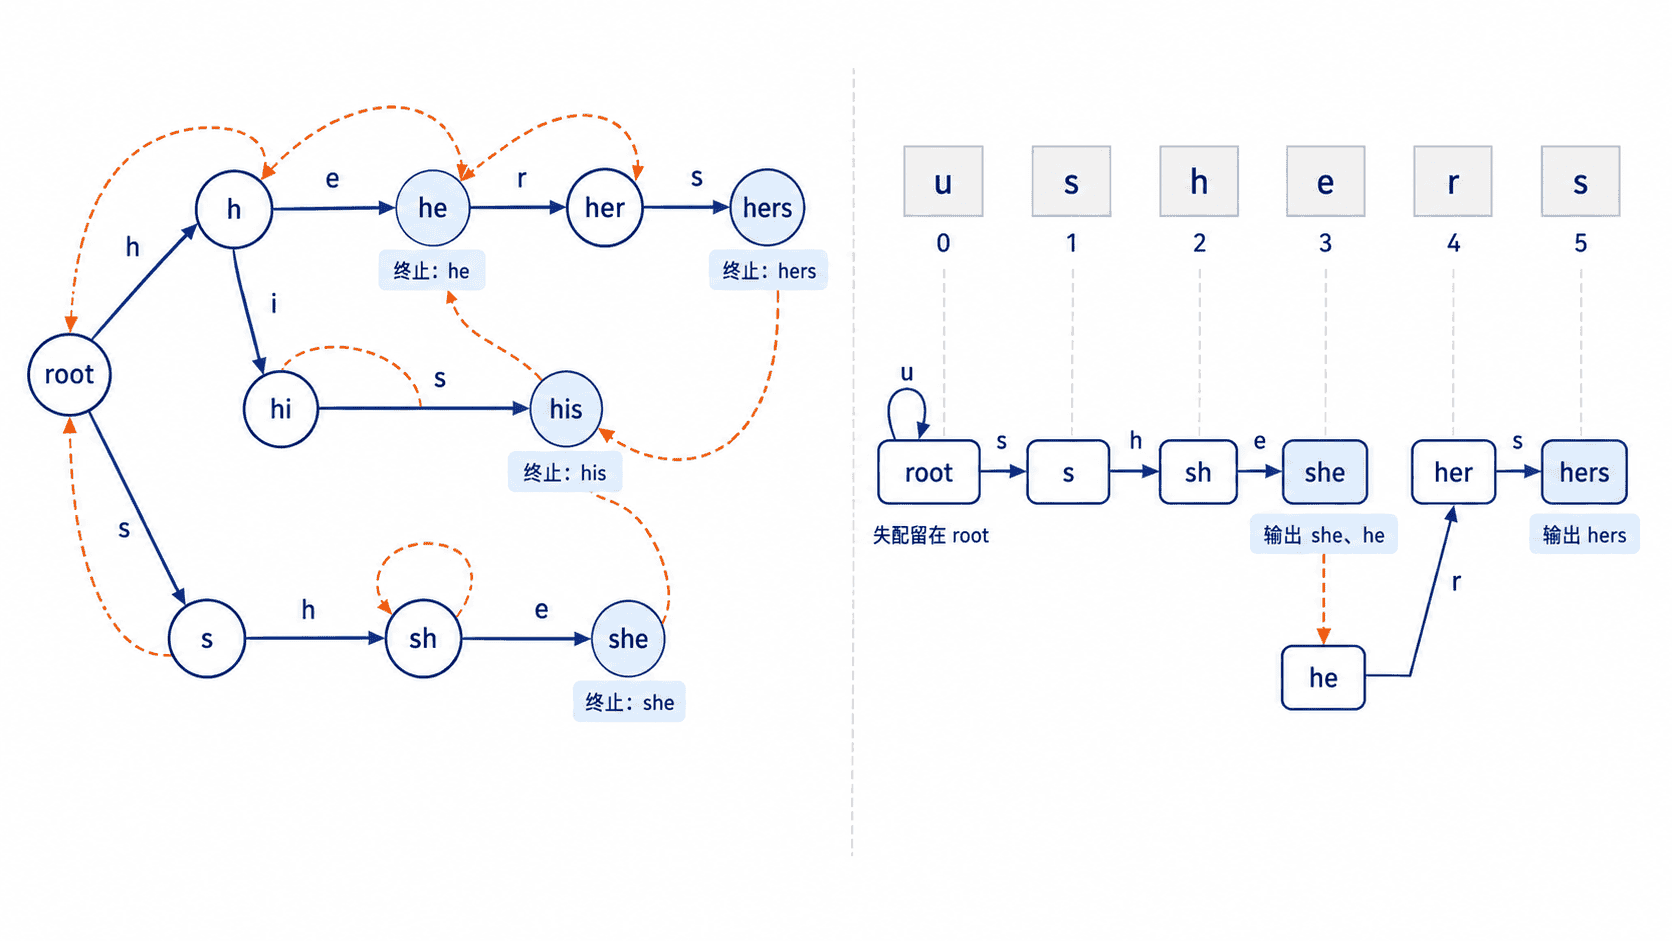
执行过程
- 将全部模式串插入 Trie,并在终止节点记录模式编号。
- 使用广度优先搜索构建失败指针。根节点的直接孩子失败指针指向根。
- 对节点
u和字符c,若存在子节点v,则令v.fail指向u.fail沿c转移后的节点。 - 将失败节点的
output合并到当前节点,使后缀模式也能被报告。 - 扫描文本时,每读入一个字符就转移一次状态,并输出当前节点记录的全部模式。
根节点需要对每个字符提供可用转移。实现时可以把缺失边补为根或失败状态的对应边,这样查询阶段只做数组访问,不再显式循环回退。
完整可运行示例
以下 Java 17 程序构建自动机并扫描文本。字符集限定为小写英文字母,模式串和文本均需满足这一条件。
import java.util.ArrayDeque;
import java.util.ArrayList;
import java.util.Arrays;
import java.util.List;
import java.util.Queue;

public class ACMatcherDemo {

    private static final int ALPHABET_SIZE = 26;

    private static class Node {
        int[] next = new int[ALPHABET_SIZE];
        int fail;
        List<Integer> output = new ArrayList<>();

        Node() {
            Arrays.fill(next, -1);
        }
    }

    private static class Match {
        final String pattern;
        final int start;
        final int end;

        Match(String pattern, int start, int end) {
            this.pattern = pattern;
            this.start = start;
            this.end = end;
        }
    }

    private final List<Node> nodes = new ArrayList<>();
    private final List<String> patterns;

    public ACMatcherDemo(List<String> patterns) {
        this.patterns = patterns;
        nodes.add(new Node());
        buildTrie();
        buildFailureLinks();
    }

    private void buildTrie() {
        for (int patternIndex = 0; patternIndex < patterns.size(); patternIndex++) {
            int state = 0;
            String pattern = patterns.get(patternIndex);

            for (char ch : pattern.toCharArray()) {
                int index = toIndex(ch);
                if (nodes.get(state).next[index] == -1) {
                    nodes.get(state).next[index] = nodes.size();
                    nodes.add(new Node());
                }
                state = nodes.get(state).next[index];
            }

            nodes.get(state).output.add(patternIndex);
        }
    }

    private void buildFailureLinks() {
        Queue<Integer> queue = new ArrayDeque<>();

        for (int c = 0; c < ALPHABET_SIZE; c++) {
            int child = nodes.get(0).next[c];
            if (child == -1) {
                nodes.get(0).next[c] = 0;
            } else {
                nodes.get(child).fail = 0;
                queue.offer(child);
            }
        }

        while (!queue.isEmpty()) {
            int state = queue.poll();

            for (int c = 0; c < ALPHABET_SIZE; c++) {
                int child = nodes.get(state).next[c];
                if (child == -1) {
                    nodes.get(state).next[c] = nodes.get(nodes.get(state).fail).next[c];
                    continue;
                }

                int failureState = nodes.get(nodes.get(state).fail).next[c];
                nodes.get(child).fail = failureState;
                nodes.get(child).output.addAll(nodes.get(failureState).output);
                queue.offer(child);
            }
        }
    }

    public List<Match> search(String text) {
        List<Match> matches = new ArrayList<>();
        int state = 0;

        for (int i = 0; i < text.length(); i++) {
            state = nodes.get(state).next[toIndex(text.charAt(i))];

            for (int patternIndex : nodes.get(state).output) {
                String pattern = patterns.get(patternIndex);
                int start = i - pattern.length() + 1;
                matches.add(new Match(pattern, start, i));
            }
        }

        return matches;
    }

    private static int toIndex(char ch) {
        if (ch < 'a' || ch > 'z') {
            throw new IllegalArgumentException("只支持小写英文字母: " + ch);
        }
        return ch - 'a';
    }

    public static void main(String[] args) {
        List<String> patterns = List.of("he", "she", "his", "hers");
        String text = "ushers";

        ACMatcherDemo matcher = new ACMatcherDemo(patterns);
        List<Match> matches = matcher.search(text);

        System.out.println("文本: " + text);
        for (Match match : matches) {
            System.out.printf(
                    "匹配 %s,区间 [%d, %d]%n",
                    match.pattern,
                    match.start,
                    match.end
            );
        }
    }
}
将代码保存为 ACMatcherDemo.java,然后执行:
javac ACMatcherDemo.java
java ACMatcherDemo
预期输出
文本: ushers
匹配 she,区间 [1, 3]
匹配 he,区间 [2, 3]
匹配 hers,区间 [2, 5]
复杂度与边界
设全部模式串总长度为 ,文本长度为 ,实际匹配次数为 。当前实现为每个节点保存 26 个转移,因此构建时间约为 ,扫描时间为 ,空间为 。若字符集很大,可改用映射保存稀疏边,以降低空间占用。
空模式串通常应在输入阶段拒绝,否则根节点会成为终止状态并在每个位置产生匹配。重复模式串可以保留多个编号,也可以先去重;两种策略的输出语义不同,必须在接口设计时明确。若文本包含大写字母、数字或 Unicode 字符,应调整字符映射,不能继续使用固定的 ch - 'a'。
常见错误是只设置失败指针,却没有合并失败节点的 output。这样扫描到 she 时只能报告 she,会漏掉其后缀模式 he。另一个错误是在构建失败指针前开始查询,此时缺失边没有完整转移规则,结果会错误或触发非法下标。
本课总结
- Trie 负责共享模式前缀,失败指针负责在失配后跳到仍可能成功的最长后缀状态。
- 输出集合必须继承失败状态的匹配结果,才能报告后缀模式和重叠匹配。
- 自动机构建完成后,文本只需从左到右扫描一次,查询复杂度为 。
下一课预告
下一课将学习“可判定问题与计算模型”,从具体算法转向更抽象的计算边界,理解什么问题能够由有限步骤给出确定答案。