
数据结构与算法 / 系统课时
开放寻址法
开放寻址法
开放寻址法不使用额外链表,而是在桶数组内按探测序列寻找可用位置。本课将比较线性探测、二次探测和双重哈希,实现支持墓碑删除的哈希表,并观察不同策略在相同冲突数据下形成的数组布局。
学习目标
- 理解开放寻址的插入、查找与删除终止条件。
- 掌握三种常见探测序列的计算方式。
- 能够分析装载因子、聚集现象与性能之间的关系。
探测过程与删除语义
设初始下标为 ,第 次探测的位置取决于策略。插入会沿序列查重,遇到从未使用的桶或遍历完规定的探测次数后,才可决定是否插入;查找会沿相同序列前进,遇到目标键则成功,遇到从未使用过的空桶则失败。
删除不能直接把桶恢复为空。若直接清空,后续查找可能过早停止,找不到探测链后方的键。常见做法是写入墓碑标记:查找遇到墓碑继续探测,插入可以记录第一个墓碑并在确认不存在重复键后复用它。
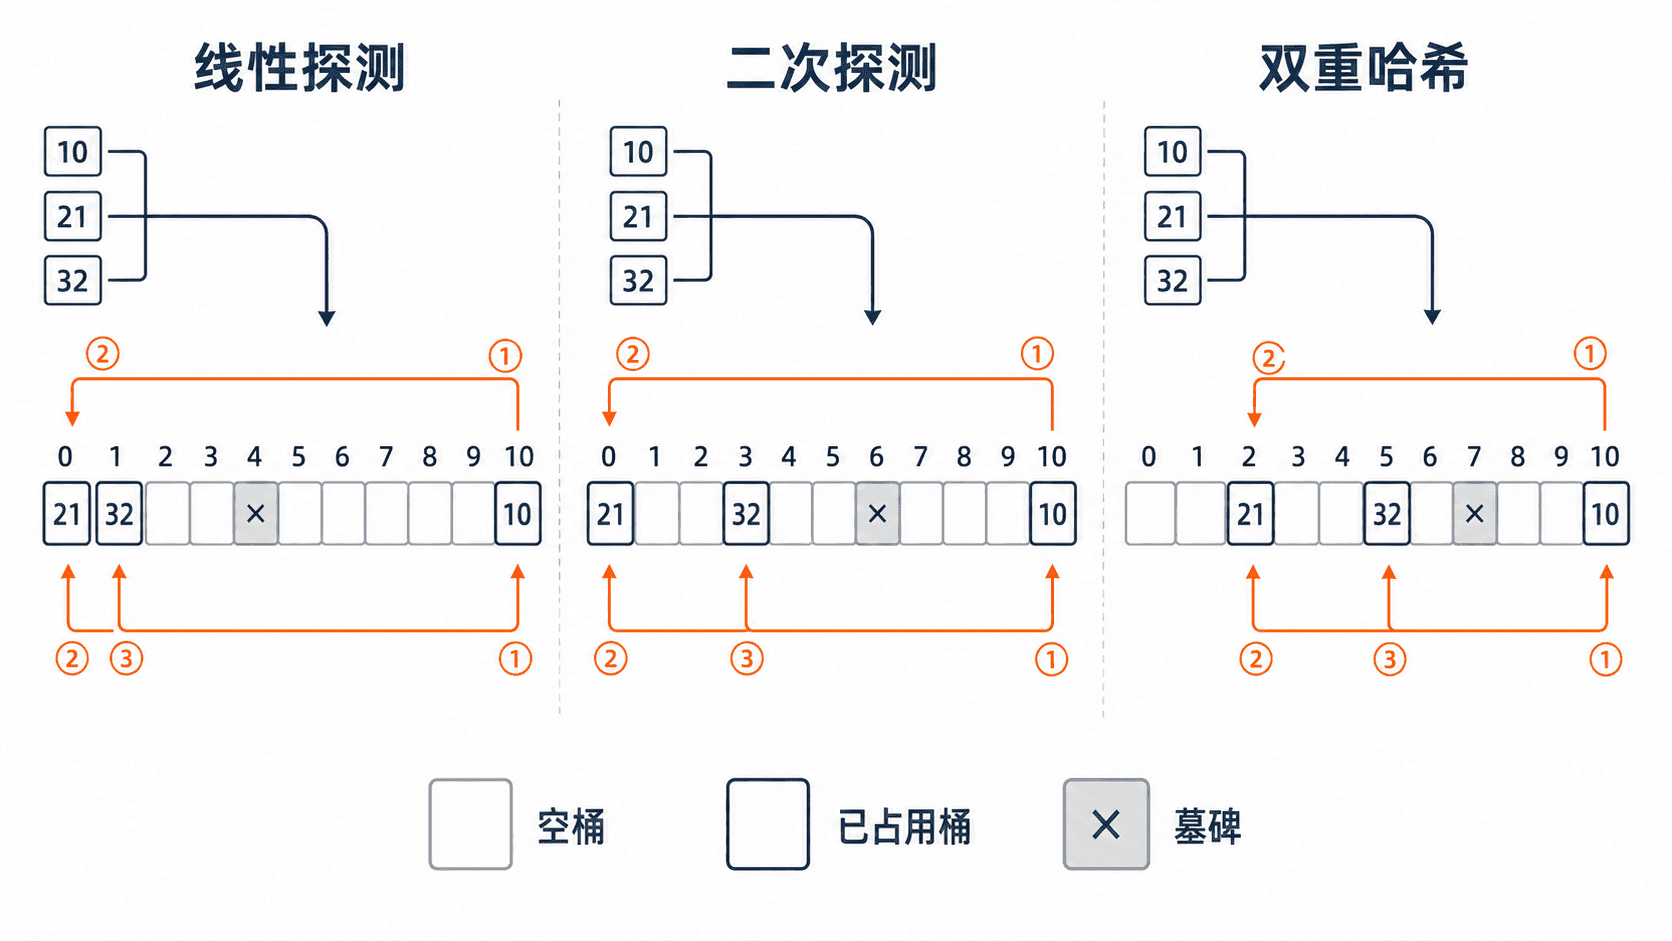
三种探测策略
容量记为 ,初始哈希为 。
| 策略 | 第 次探测位置 | 主要特点 |
|---|---|---|
| 线性探测 | 实现简单,但容易形成连续聚集 | |
| 二次探测 | 减轻主聚集,但参数与容量选择会影响覆盖范围 | |
| 双重哈希 | 探测路径更分散,第二步长必须与容量互质 |
开放寻址最多保存 m 个有效键。为了保持短探测,工程中通常提前扩容。有效负载是 n/m,查找还受墓碑影响,可以另外跟踪 (n+墓碑数)/m。阈值要结合具体探测序列,墓碑多时即使有效负载低也可重建同容量表。
完整实现与验证
下面的 Java 17 示例使用容量为 11 的数组,并让三种策略处理同一组键。null 表示从未使用的空桶,独立的 DELETED 对象表示墓碑。
import java.util.Arrays;

public class OpenAddressingHashTableDemo {

    private enum Strategy {
        LINEAR,
        QUADRATIC,
        DOUBLE_HASHING
    }

    private static final class OpenAddressingHashTable {
        private static final Object DELETED = new Object();

        private final Object[] table;
        private final Strategy strategy;
        private int size;

        private OpenAddressingHashTable(int capacity, Strategy strategy) {
            if (capacity < 3) {
                throw new IllegalArgumentException("capacity must be at least 3");
            }
            if (strategy == null) {
                throw new IllegalArgumentException("strategy is required");
            }
            if (strategy != Strategy.LINEAR && !isPrime(capacity)) {
                throw new IllegalArgumentException("this strategy requires a prime capacity");
            }
            this.table = new Object[capacity];
            this.strategy = strategy;
        }

        public boolean put(int key) {
            int firstDeleted = -1;

            for (int i = 0; i < table.length; i++) {
                int index = probeIndex(key, i);
                Object slot = table[index];

                if (slot == null) {
                    int target = firstDeleted >= 0 ? firstDeleted : index;
                    table[target] = key;
                    size++;
                    return true;
                }

                if (slot == DELETED) {
                    if (firstDeleted < 0) {
                        firstDeleted = index;
                    }
                } else if ((Integer) slot == key) {
                    return false;
                }
            }

            if (firstDeleted >= 0) {
                table[firstDeleted] = key;
                size++;
                return true;
            }
            throw new IllegalStateException("no available slot in probe sequence");
        }

        public boolean contains(int key) {
            for (int i = 0; i < table.length; i++) {
                int index = probeIndex(key, i);
                Object slot = table[index];

                if (slot == null) {
                    return false;
                }
                if (slot != DELETED && (Integer) slot == key) {
                    return true;
                }
            }
            return false;
        }

        public boolean remove(int key) {
            for (int i = 0; i < table.length; i++) {
                int index = probeIndex(key, i);
                Object slot = table[index];

                if (slot == null) {
                    return false;
                }
                if (slot != DELETED && (Integer) slot == key) {
                    table[index] = DELETED;
                    size--;
                    return true;
                }
            }
            return false;
        }

        public String snapshot() {
            String[] result = new String[table.length];
            for (int i = 0; i < table.length; i++) {
                if (table[i] == null) {
                    result[i] = "_";
                } else if (table[i] == DELETED) {
                    result[i] = "X";
                } else {
                    result[i] = table[i].toString();
                }
            }
            return Arrays.toString(result);
        }

        private static boolean isPrime(int value) {
            for (int divisor = 2; divisor <= value / divisor; divisor++) {
                if (value % divisor == 0) {
                    return false;
                }
            }
            return value >= 2;
        }

        private int probeIndex(int key, int attempt) {
            int capacity = table.length;
            int firstHash = Math.floorMod(key, capacity);

            return switch (strategy) {
                case LINEAR -> Math.floorMod((long) firstHash + attempt, capacity);
                case QUADRATIC -> Math.floorMod(firstHash + (long) attempt * attempt, capacity);
                case DOUBLE_HASHING -> {
                    int step = 1 + Math.floorMod(key, capacity - 1);
                    yield Math.floorMod(firstHash + (long) attempt * step, capacity);
                }
            };
        }
    }

    public static void main(String[] args) {
        for (Strategy strategy : Strategy.values()) {
            OpenAddressingHashTable table =
                    new OpenAddressingHashTable(11, strategy);

            for (int key : new int[]{10, 21, 32, 43}) {
                table.put(key);
            }

            table.remove(21);
            table.put(54);

            System.out.println(strategy + " = " + table.snapshot());
            System.out.println("contains(32) = " + table.contains(32));
        }
    }
}
将代码保存为 OpenAddressingHashTableDemo.java,然后编译并运行:
javac -encoding UTF-8 OpenAddressingHashTableDemo.java
java OpenAddressingHashTableDemo
预期输出
LINEAR = [54, 32, 43, _, _, _, _, _, _, _, 10]
contains(32) = true
QUADRATIC = [54, _, _, 32, _, _, _, _, 43, _, 10]
contains(32) = true
DOUBLE_HASHING = [_, X, 32, 43, 54, _, _, _, _, _, 10]
contains(32) = true
输出中的 _ 表示从未使用的空桶,X 表示墓碑。双重哈希插入 54 时没有经过下标 1,因此该策略保留了删除 21 后的墓碑。
常见错误与实践建议
插入时发现墓碑后不能立即写入并结束,因为探测链后方可能已经存在相同键。正确做法是记录第一个墓碑,继续探测到空桶或重复键,再决定是否复用墓碑。
对奇素数 m,i² 模 m 在 i=0 到 (m−1)/2 时互不相同。若两个平方同余,则 m 整除 (i−j)(i+j),而这段不同下标的差与和都不能被 m 整除。这个序列有 (m+1)/2 个不同位置,仍可能在全表未满时耗尽。m=11、初始下标为 0 时只能到达 0、1、4、9、5、3。若这六处都被占用,第七个同起点键会被拒绝。
双重哈希的步长不能为 0,并且应与容量互质,否则探测序列可能只循环访问部分桶。本例对双重哈希约束素数容量,使 1 到 m−1 的步长都与 m 互质,探测可走遍全部桶。探测偏移先用 long 运算,再对容量取模。
本课练习
- 为示例增加
loadFactor()和自动扩容机制,要求扩容后重新插入所有有效键,墓碑不应被复制到新表。 - 统计相同键流下的成功、失败及查找探测次数,分别记录有效键和墓碑占比。二次探测在高负载可能无法达到设定目标,不应只统计成功插入的样本。
本课总结
- 开放寻址让所有键都存放在桶数组中,查找必须复现插入时的探测序列。
- 墓碑能够保持探测链连续,但过多墓碑会增加探测成本,需要通过重散列清理。
- 线性探测、二次探测和双重哈希的差异主要体现在探测路径、聚集程度和容量约束。
下一课预告
完成两种冲突处理方法后,下一阶段可以继续学习哈希集合、扩容重散列以及在真实数据分布下评估哈希函数质量。