
数据结构与算法 / 系统课时
从递归程序建立递推式
从递归程序建立递推式
递归代码只展示“函数再次调用自己”,却不会直接告诉我们总耗时。本课将把递归程序拆成子问题数量、子问题规模和当前层额外工作三部分,并据此写出可分析的时间复杂度递推式。
学习目标
- 从递归代码中识别子问题数量与子问题规模。
- 正确估算递归调用之外的合并成本。
- 为常见递归程序写出带边界条件的递推式。
从代码到数学模型
建立递推式时,不要逐行累加所有语句,而要先观察一次函数调用做了什么。一个规模为 的调用通常包含三类成本:若干个更小规模的递归调用、当前层完成拆分或合并的工作、到达最小规模后的常数成本。
常见形式是:
其中, 表示每次产生的子问题数量, 表示每个子问题的规模, 表示当前层除递归调用外的工作量。终止条件取决于程序。若归并排序在空表和单元素时立即返回,可写 。若单独统计比较,两项基值为 0。
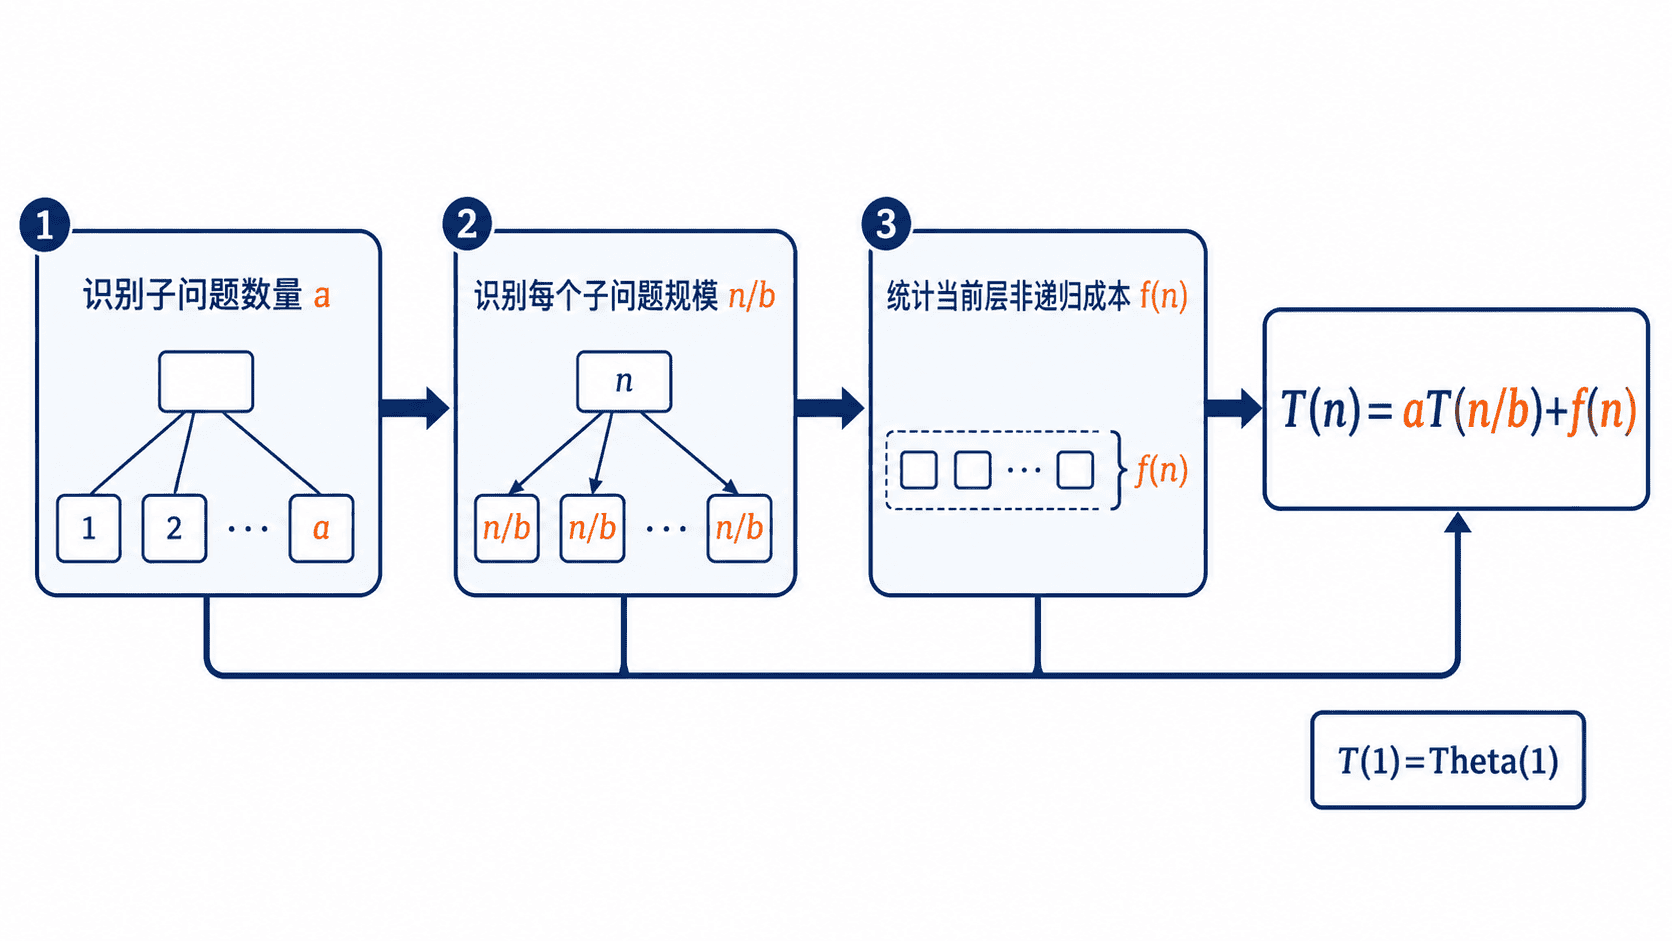
建模步骤
先确定输入规模如何定义。数组问题通常用元素个数 ,树问题可用节点数。数值递归可以先写成参数数值 n 的递推,若讨论编码长度,则要换成 n 的位数并计入算术成本。规模定义不清,后续递推式就没有统一含义。
接着统计一次调用中出现了多少个递归分支,并记录每个分支接收的规模。两个 solve(n / 2) 对应两个规模约为 的子问题,因此递归项是 ;一个 solve(n - 1) 对应 。
最后只统计本次调用自身的工作。递归项按实际控制流计算,若程序只执行两个分支之一,就不能把两个分支的递归成本相加。循环遍历 个元素通常贡献 ,固定次数的比较和赋值贡献 。递归调用本身已经由 表示,不能再次计入 。
完整可运行示例
下面的 Python 程序模拟归并排序的调用结构,并统计比较次数。归并排序每次把数组分成两个近似等大的子数组,递归处理后再线性合并,在 n 为 2 的幂时,运行时间可写为 。切片和合并都计入本次调用。代码输出的精确比较数只统计键值的比较次数,合并剩余元素时虽不比较键值,仍花费写入时间。
def merge_sort(values):
    if len(values) <= 1:
        return values, 0

    middle = len(values) // 2
    left, left_comparisons = merge_sort(values[:middle])
    right, right_comparisons = merge_sort(values[middle:])

    merged = []
    i = 0
    j = 0
    merge_comparisons = 0

    # 当前层的主要成本来自线性合并。
    while i < len(left) and j < len(right):
        merge_comparisons += 1
        if left[i] <= right[j]:
            merged.append(left[i])
            i += 1
        else:
            merged.append(right[j])
            j += 1

    merged.extend(left[i:])
    merged.extend(right[j:])
    total = left_comparisons + right_comparisons + merge_comparisons
    return merged, total

data = [8, 3, 6, 2, 7, 1, 5, 4]
sorted_data, comparisons = merge_sort(data)

print("排序结果:", sorted_data)
print("比较次数:", comparisons)
print("递推式: T(n) = 2T(n/2) + Theta(n)")
运行命令:
python recursion_recurrence.py预期输出
排序结果: [1, 2, 3, 4, 5, 6, 7, 8]
比较次数: 17
递推式: T(n) = 2T(n/2) + Theta(n)
同一规模的比较次数可因排列而异。原输入的 8 个键比较 17 次。用已经升序的 1 到 8 运行同样代码只比较 12 次,两个输入都有线性的顶层拆分与写入工作。
边界与易错点
当 不能被均匀分割时,可写成 。在渐进分析中,为突出主要结构,常把它简化为 ,但必须知道这是数量级层面的简化。
常见错误是把两个递归调用写成 ,遗漏了子问题数量;或者把合并循环误写成 。另一个错误是把切片、复制等语言运行时成本忽略掉。分析具体实现时,应确认这些操作是否会额外遍历数据。
本课练习
- 分析一个递归二分查找程序,写出输入规模、递归项、当前层成本和边界条件,并给出完整递推式。
- 对一个每次递归调用三个规模为 子问题、当前层执行 次基本操作的算法建立递推式,并说明每一项来自哪段工作。
本课总结
- 递推式由子问题数量、子问题规模、当前层成本和边界条件共同组成。
- 递归调用成本用 表示,当前层非递归工作用 表示。
- 建模前必须先统一输入规模,并检查语言特性是否引入隐藏成本。
下一课预告
下一课将学习“代入法求解递推式”,通过猜测解的数量级并使用数学归纳法验证上界或下界。