
数据结构与算法 / 系统课时
字符串匹配问题
字符串匹配问题
字符串匹配研究的是:给定文本串与模式串,判断模式是否出现、出现在哪里,以及相关前缀和后缀如何描述。掌握这些术语后,后续学习朴素匹配、KMP、Rabin-Karp 等算法时,才能准确理解算法输入、输出与优化目标。
学习目标
- 能用文本串、模式串和匹配位置形式化描述字符串匹配问题。
- 能区分全串匹配、首次出现与全部匹配位置。
- 能识别前缀、后缀、真前缀、真后缀与边界串。
问题定义与基本术语
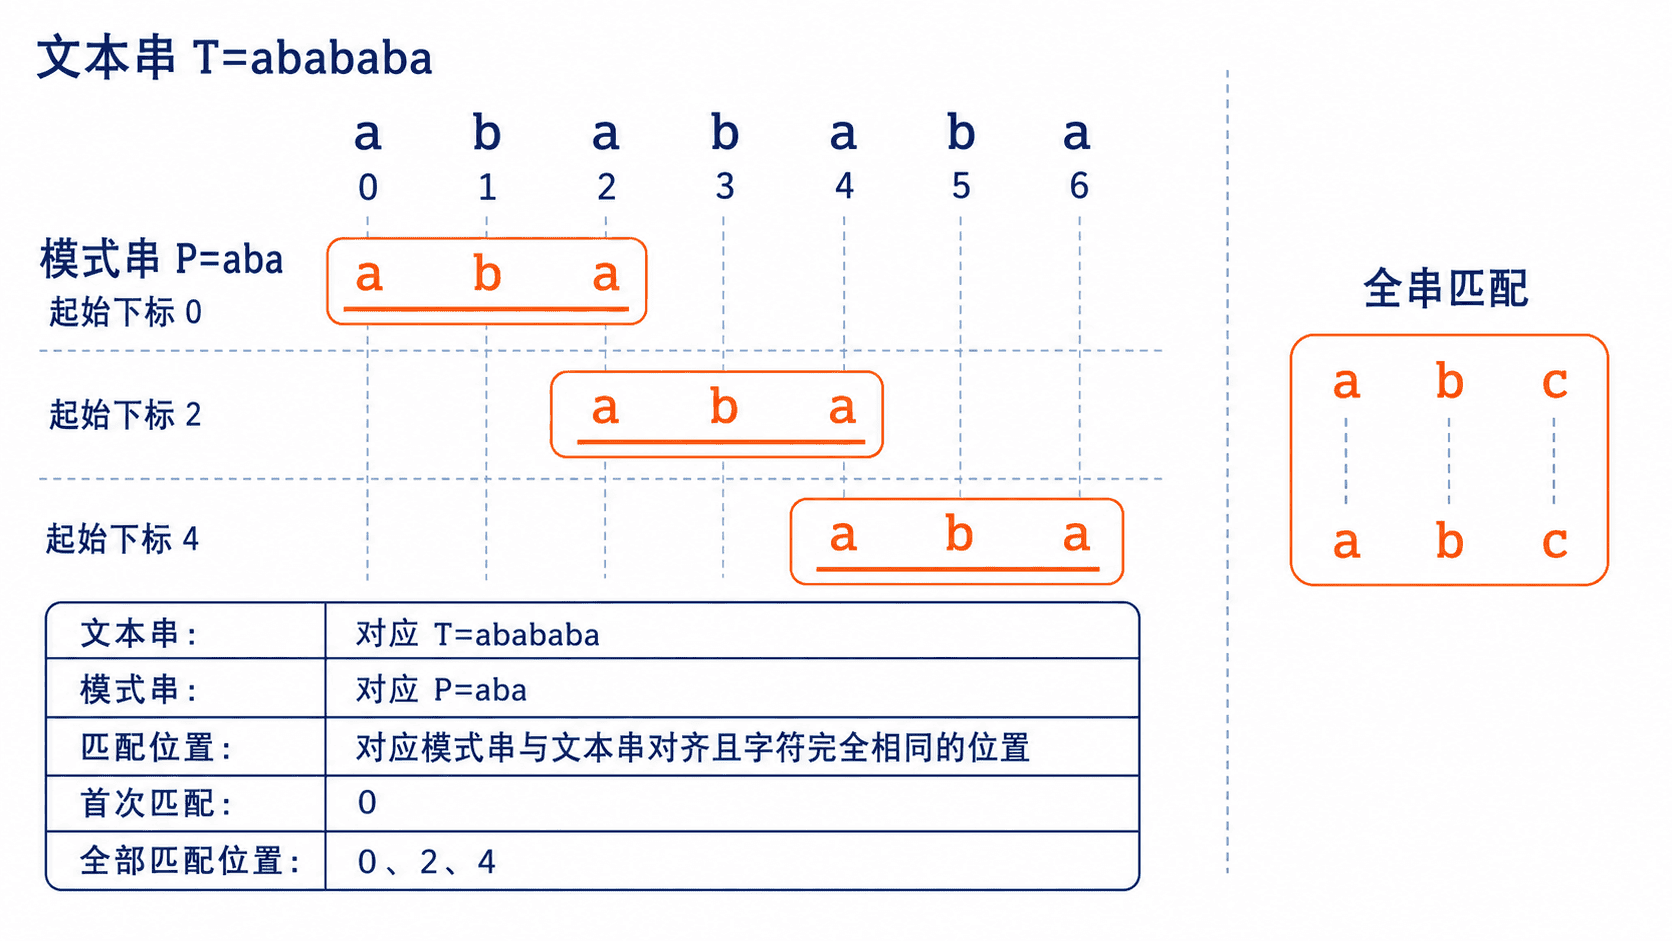
设文本串为 T,长度为 n;模式串为 P,长度为 m。当某个起始下标 s 满足 T[s:s+m] == P 时,就称模式串在文本串的下标 s 处发生一次匹配。
| 术语 | 含义 | 示例 |
|---|---|---|
| 单模式匹配 | 在一个文本串中查找一个固定模式串 | 在 abababa 中查找 aba |
| 首次匹配 | 只返回最靠左的一个匹配位置 | 返回下标 0 |
| 全部匹配位置 | 返回模式串出现的所有起始下标 | 返回下标 0、2、4 |
| 全串匹配 | 模式串与整个文本串长度相同且内容相等 | abc 与 abc |
| 未匹配 | 不存在满足条件的起始下标 | 在 abc 中查找 bd |
为避免术语混淆,本课把“全匹配”理解为模式覆盖整个文本;若要表达查找所有出现位置,则使用“全部匹配位置”。
前缀、后缀与边界串
字符串 S 的前缀是从开头截取的连续片段,后缀是到结尾结束的连续片段。若片段不等于 S 本身,则称为真前缀或真后缀。
以 ababa 为例:
- 真前缀为
a、ab、aba、abab。 - 真后缀为
a、ba、aba、baba。 - 同时是真前缀和真后缀的字符串称为边界串,因此
a和aba都是ababa的边界串。
边界串描述了模式内部的重复结构。后续算法会利用这些重复信息,在失配后跳过已经确定不可能成功的位置。
最小可运行示例
下面的 Python 程序同时演示全部匹配位置、全串匹配、真前缀和真后缀。程序把空模式串视为非法输入,避免不同系统对空串语义的差异。
python
def find_all(text: str, pattern: str) -> list[int]:
    if pattern == "":
        raise ValueError("pattern must not be empty")

    positions = []
    limit = len(text) - len(pattern) + 1
    for start in range(max(0, limit)):
        if text[start:start + len(pattern)] == pattern:
            positions.append(start)
    return positions

def is_full_match(text: str, pattern: str) -> bool:
    return text == pattern

def proper_prefixes(value: str) -> list[str]:
    return [value[:end] for end in range(1, len(value))]

def proper_suffixes(value: str) -> list[str]:
    return [value[start:] for start in range(1, len(value))]

def main() -> None:
    text = "abababa"
    pattern = "aba"
    sample = "ababa"

    print("全部匹配位置:", find_all(text, pattern))
    print("是否全串匹配:", is_full_match(pattern, "aba"))
    print("真前缀:", proper_prefixes(sample))
    print("真后缀:", proper_suffixes(sample))

if __name__ == "__main__":
    main()
将代码保存为 string_matching_terms.py,再运行:
bash
python string_matching_terms.py预期输出
text
全部匹配位置: [0, 2, 4]
是否全串匹配: True
真前缀: ['a', 'ab', 'aba', 'abab']
真后缀: ['a', 'ba', 'aba', 'baba']
边界条件与易混淆点
当 m > n 时,模式串不可能在文本串中出现;当 m == n 时,最多只有下标 0 一个候选位置。重叠匹配不能被遗漏,例如 aba 在 abababa 中的三个匹配区间彼此重叠。
字符串下标通常从 0 开始,但题目也可能要求从 1 开始输出。实现前应确认下标约定,并明确是否允许空模式串。不同库对空模式串的处理并不完全一致。
本课练习
- 给定文本串
aaaa和模式串aa,写出全部匹配位置,并说明为什么不能在找到第一个匹配后直接跳过两个字符。 - 列出字符串
abcab的全部真前缀、真后缀和边界串。 - 设计三个测试用例,分别覆盖模式比文本长、模式与文本完全相同、模式完全不存在三种情况,并写出预期结果。
本课总结
- 字符串匹配的核心输出是满足
T[s:s+m] == P的起始下标s。 - 全串匹配、首次匹配和全部匹配位置表达的是不同需求。
- 前缀、后缀与边界串揭示模式内部的重复结构,是后续高效算法的重要基础。
下一课预告
下一课将学习“朴素字符串匹配”,通过逐个对齐模式串实现查找,并分析重复比较为什么会带来较高的时间成本。
按自己的节奏,确认真正理解。