
数据结构与算法 / 系统课时
比较排序下界
比较排序下界
归并排序与快速排序的执行过程不同,但都可通过比较取得排序信息。本课用决策树解释为什么比较模型中的算法最坏至少要进行 次比较。
学习目标
- 理解比较决策树的节点、分支与输出映射。
- 从互异元素的 个次序推导最坏比较次数。
- 区分信息论下界、实际比较次数和利用键值结构的排序。
一条路径只能决定一种位置次序
固定输入长度 ,考虑互异键。算法只允许通过比较了解键的次序,因此一次有效比较只有“小于”和“大于”两种结果。一个确定性算法可展开成决策树:内部节点选择要比较的两个记录,边表示结果,叶子确定原始位置的输出排列。不同的相对次序要求不同的输出位置排列。若同一叶子包含两种不同次序,就至少有一种不能得到正确输出。 MIT 比较排序下界课程资料
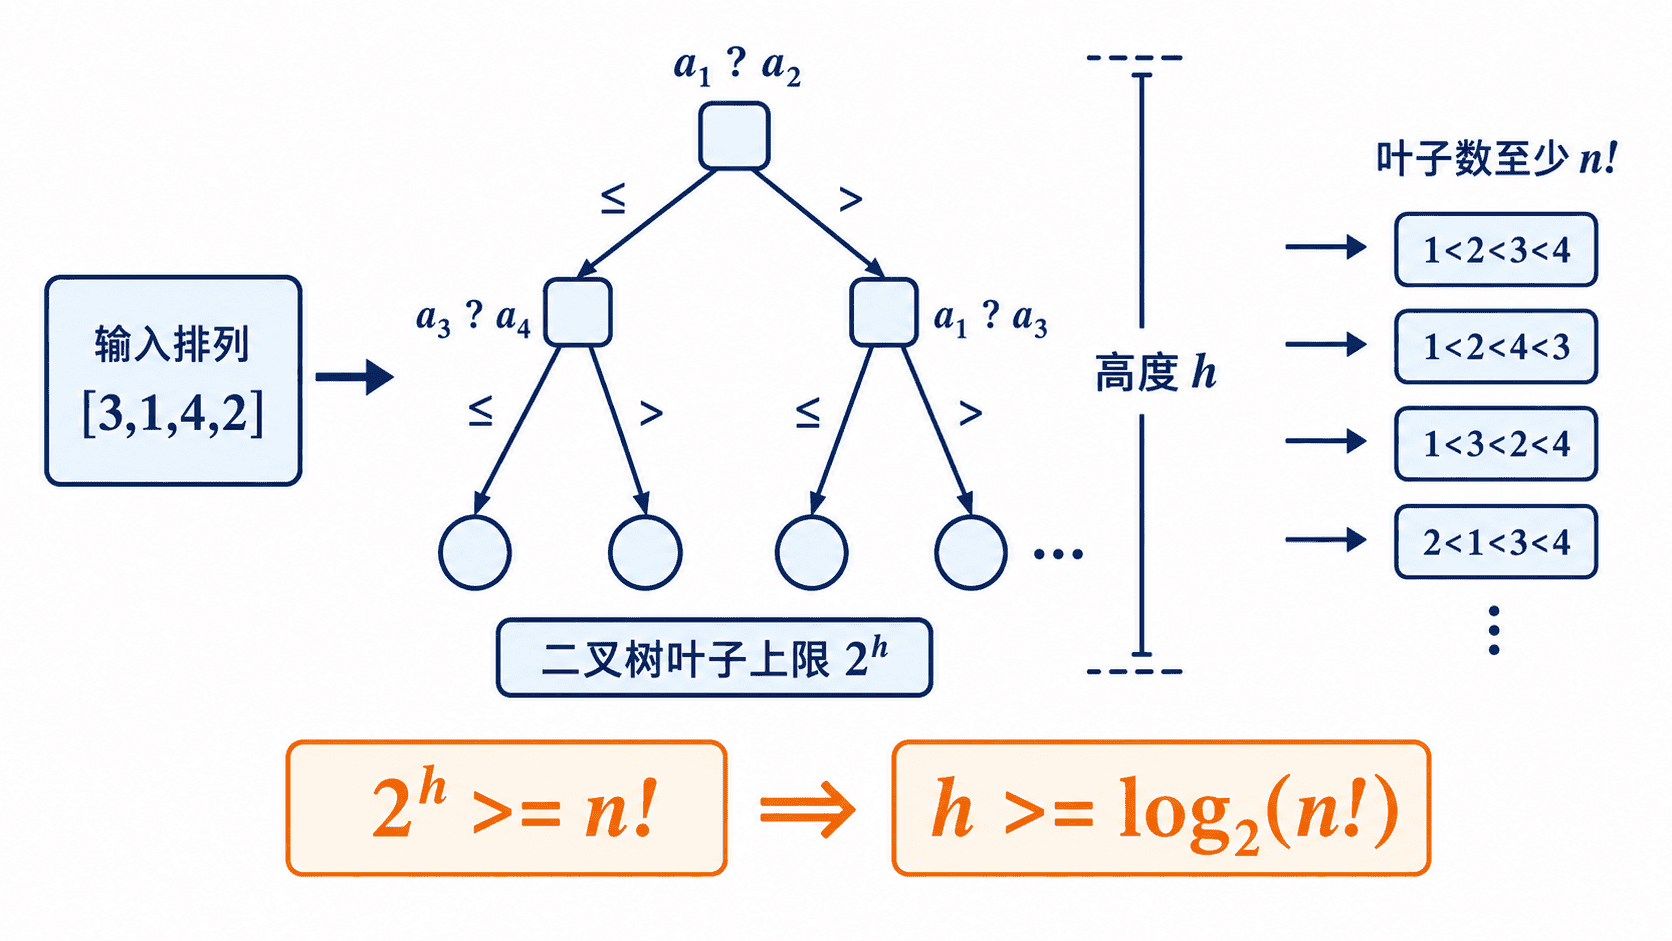
互异键共有 种相对次序,所以树至少要有 个可达叶子。最大深度为 的二叉树最多有 个叶子,因此 。这给出最坏比较次数的必要下界。上界可用 ,下界可用阶乘中至少 个因子都不小于 。取对数得 。归并排序等算法达到相同量级的最坏比较上界,因此渐进阶紧确。 MIT 比较排序与决策树
用整数位长计算精确下界
对正整数 ,能容纳至少 个叶子的最小高度是 。用 (M-1).bit_length() 可精确计算,避免浮点对数恰好靠近整数时的舍入。空序列或单元素只有一种位置次序,下界为 0。下面是小规模数值示例,并不搜索可实现的最优比较树。 Python int.bit_length
from math import factorial


def comparison_lower_bound(n: int) -> int:
    if type(n) is not int or n < 0:
        raise ValueError("n must be a non-negative integer")
    return (factorial(n) - 1).bit_length()


for n in (0, 1, 2, 4, 8, 16):
print(f"n={n}: at least {comparison_lower_bound(n)} comparisons")n=0: at least 0 comparisons
n=1: at least 0 comparisons
n=2: at least 1 comparisons
n=4: at least 5 comparisons
n=8: at least 16 comparisons
n=16: at least 45 comparisons该计数只说明叶子至少需要多少空间,未保证能用合法的两元素比较把树恰好构造成最小高度。算法允许比较相等也不会推翻证明,因为我们选取了互异键的输入子集。 MIT 比较模型与排序
对总是正确的随机算法,可固定随机选择得到确定性树。若各叶深度为 ,这些路径互不为前缀,故 。由指数函数的凸性,均匀互异排列的平均深度至少为 。再对随机选择取期望,至少有一个输入的期望比较次数不低于这个下界。
为什么有时可以线性排序
计数排序可以直接用受限整数键索引计数数组。若键域大小为 ,典型代价为 ,在 的条件下是线性的。基数排序还取决于需要处理的位数和每轮成本,桶排序的效果依赖分布及桶内工作。它们利用了比较模型没有授予的操作。下一章从计数排序开始,检查这些条件如何进入复杂度。