
数据结构与算法 / 系统课时
建堆与堆排序
建堆与堆排序
堆排序把数组先转换为最大堆,再反复把堆顶最大值移动到数组末尾。完成本课后,你将理解为什么自底向上建堆是 ,并能实现时间复杂度稳定为 、额外空间为 的原地排序。
学习目标
- 掌握自底向上建堆的起始位置与执行顺序
- 使用最大堆实现原地升序堆排序
- 区分建堆复杂度、排序复杂度与算法稳定性
从无序数组到最大堆
数组的下标布局天然对应完全二叉树。所有下标大于等于 n / 2 的节点都是叶节点,单个叶节点已经满足堆性质,因此建堆只需从最后一个非叶节点 n / 2 - 1 开始,按下标递减执行向下堆化,直到根节点。
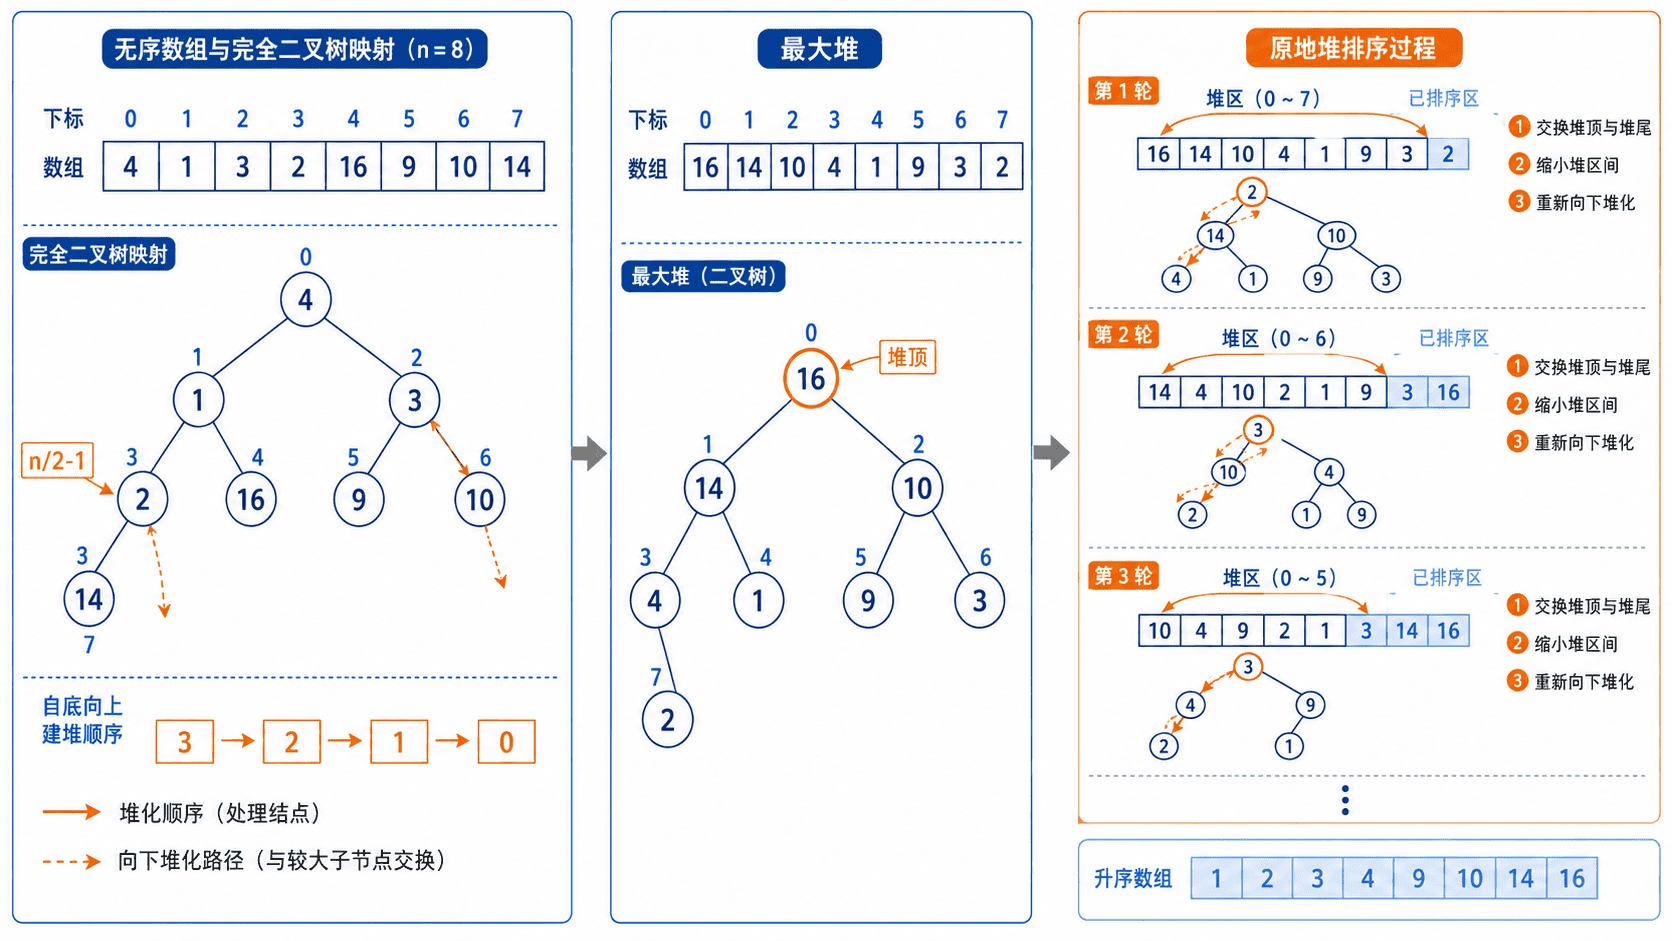
建成最大堆后,数组首元素是当前最大值。将它与堆区间最后一个元素交换后,最大值便进入最终位置。随后把堆大小减一,并只对根节点执行一次向下堆化。重复这一过程,已排序区从右向左逐步扩大。
为什么建堆是线性时间
容易产生的误解是:建堆对大约 n / 2 个节点调用一次 的向下堆化,所以复杂度一定是 。这个估算忽略了不同节点能够下沉的高度不同。
靠近叶子的节点数量多,但最多只移动一两层;靠近根的节点可能移动很多层,但数量很少。把所有节点的实际移动上界相加,可得到:
因此,自底向上建堆的时间复杂度是 。排序阶段需要进行约 n - 1 轮,每轮交换为 ,向下堆化为 ,总时间复杂度为 。
完整可运行示例
下面的 Java 17 示例使用最大堆完成升序排序。buildMaxHeap 只处理非叶节点,heapSort 每轮缩小有效堆区间,不创建辅助数组。
import java.util.Arrays;

public class HeapSortDemo {

    public static void buildMaxHeap(int[] array) {
        for (int i = array.length / 2 - 1; i >= 0; i--) {
            siftDown(array, array.length, i);
        }
    }

    public static void heapSort(int[] array) {
        buildMaxHeap(array);

        for (int end = array.length - 1; end > 0; end--) {
            // 堆顶是当前最大值,交换后进入最终位置
            swap(array, 0, end);
            siftDown(array, end, 0);
        }
    }

    private static void siftDown(int[] array, int size, int index) {
        while (true) {
            int largest = index;
            int left = 2 * index + 1;
            int right = 2 * index + 2;

            if (left < size && array[left] > array[largest]) {
                largest = left;
            }
            if (right < size && array[right] > array[largest]) {
                largest = right;
            }
            if (largest == index) {
                return;
            }

            swap(array, index, largest);
            index = largest;
        }
    }

    private static void swap(int[] array, int i, int j) {
        int temp = array[i];
        array[i] = array[j];
        array[j] = temp;
    }

    public static void main(String[] args) {
        int[] values = {4, 10, 3, 5, 1};

        int[] heapView = Arrays.copyOf(values, values.length);
        buildMaxHeap(heapView);
        System.out.println("最大堆: " + Arrays.toString(heapView));

        heapSort(values);
        System.out.println("升序结果: " + Arrays.toString(values));
    }
}
运行命令:
javac HeapSortDemo.java
java HeapSortDemo
预期输出:
最大堆: [10, 5, 3, 4, 1]
升序结果: [1, 3, 4, 5, 10]
复杂度与工程取舍
| 阶段 | 时间复杂度 | 额外空间 |
|---|---|---|
| 自底向上建堆 | ||
| 排序阶段 | ||
| 整体 |
堆排序的最好、平均和最坏时间复杂度都为 ,不会像朴素快速排序那样在极端输入下退化到 。它还能原地完成排序,但通常缓存局部性弱于归并排序和快速排序,并且不是稳定排序:交换堆顶与堆尾可能改变相等元素的原始相对顺序。
若目标是降序排列,可以构建最小堆并采用同样过程;也可以先得到升序结果再反转数组。前者能直接复用堆排序结构,但所有比较方向必须保持一致。
常见错误与验证
最常见的边界错误是从 array.length / 2 开始建堆。该位置已经是第一个叶节点,虽然多执行一次通常不会破坏结果,但会增加无意义操作;正确起点是 array.length / 2 - 1。
排序阶段调用向下堆化时,size 必须传入当前的 end,而不是完整数组长度。交换到右侧的元素已经进入最终位置,如果仍把它纳入堆区间,后续堆化会破坏已排序部分。
验证时可先单独调用 buildMaxHeap,检查根节点是否为全局最大值,并检查每个父节点是否不小于子节点;再执行完整排序,确认结果单调不降且元素数量、总和或频次没有变化。
本课练习
- 为示例增加每一轮排序后的数组输出,要求明确展示“堆区间”和“已排序区间”的边界。
- 将实现改为最小堆,并输出降序数组。验收条件是输入
[4, 10, 3, 5, 1]后得到[10, 5, 4, 3, 1]。 - 使用包含重复值的数组
[5, 1, 5, 3, 1]测试排序结果,并记录相同值对象的原始顺序是否保持,以验证堆排序不稳定的特点。
本课总结
- 自底向上建堆从最后一个非叶节点开始,总时间复杂度为
- 堆排序通过交换堆顶、缩小堆区间和重新堆化完成原地排序
- 整体时间复杂度为 ,额外空间为 ,但算法不稳定
下一课预告
完成堆排序后,下一阶段可以继续学习优先队列的接口设计与典型应用,理解如何把堆的插入、取顶和删除能力封装为可复用的数据结构。