
数据结构与算法 / 系统课时
启发式方法的使用边界
启发式方法的使用边界
启发式方法常能迅速找到可用解,但“运行得快”不等于“结果有保证”。本课通过路线规划示例建立一套使用边界:何时可以采用启发式、怎样与基准比较,以及何时必须停用或切换到更可靠的方案。
学习目标
- 区分启发式方法、近似算法与精确算法的质量承诺。
- 掌握基准、指标、测试集和停用条件组成的评估闭环。
- 能够识别启发式结果在关键业务中需要的校验与回退措施。
何时值得使用启发式方法
启发式方法利用经验规则缩小搜索范围,目标是在有限时间内得到足够好的可行解。它适合最优求解成本过高、响应时间明确受限、结果质量可以量化验证,并且系统具备失败回退路径的场景。
采用启发式前应先确认四件事:输出是否合法、质量指标是什么、比较基准是什么、最差结果能否被业务接受。若问题涉及安全、合规、资金结算或不可逆操作,仅凭历史平均效果不足以支撑上线,必须增加形式化约束、人工复核或可靠的保底算法。
与近似算法的关键区别
| 维度 | 近似算法 | 启发式方法 |
|---|---|---|
| 质量承诺 | 在明确假设下给出最坏情况近似比 | 通常依赖实验表现,不自动拥有理论界限 |
| 主要证据 | 数学证明与复杂度分析 | 基准测试、线上指标与失败案例 |
| 输入变化 | 保证覆盖模型内的全部合法输入 | 分布变化可能显著降低效果 |
| 结果使用 | 可直接依据证明判断上界 | 需要校验、监控和回退策略 |
二者不是由代码风格区分的。同一条经验规则若后来在明确假设下证明了性能上界,就可以作为近似算法讨论;没有证明时,应把它当作启发式方案管理风险。
评估闭环与停用条件
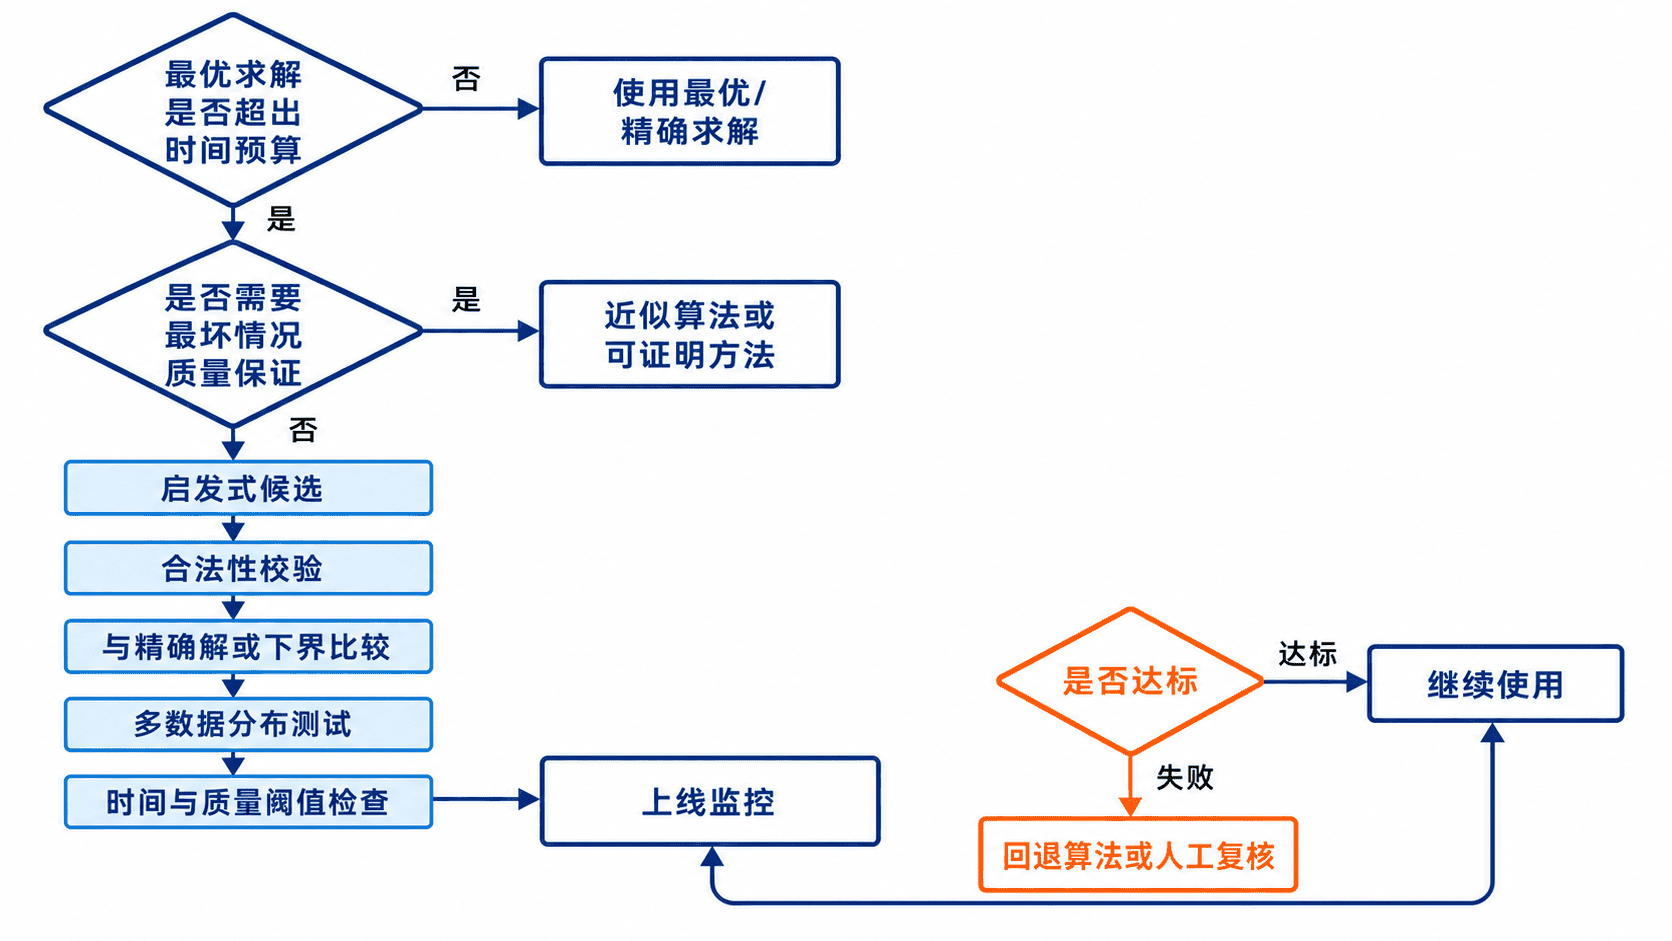
评估应覆盖离线和在线两个阶段。离线阶段使用精确算法、小规模穷举、已知下界或高质量公开结果作为基准,分别记录解质量、运行时间、内存和失败率;包含常规样例之外,还要加入极端规模、重复权重、密集约束和分布偏移样例。
上线后需要持续监控质量代理指标与输入分布。应预先写明停用条件,例如结果不合法、质量超过业务容忍阈值、超时比例持续升高,或新数据与训练和测试分布明显不同。停用条件触发后应切换到保底算法、降低问题规模或进入人工复核,而不是继续返回未经验证的结果。
完整可运行示例
下面的 Python 3 程序使用最近邻启发式构造一条巡回路线,再用全排列求出 5 个城市的小规模最优解。全排列的时间复杂度为阶乘级,只用于建立评估基准,不适合直接处理大规模实例。
from itertools import permutations

CITY_NAMES = ["A", "B", "C", "D", "E"]

COST = [
    [0, 4, 4, 6, 9],
    [4, 0, 15, 1, 1],
    [4, 15, 0, 8, 4],
    [6, 1, 8, 0, 15],
    [9, 1, 4, 15, 0],
]

def route_cost(route):
    return sum(COST[route[i]][route[i + 1]] for i in range(len(route) - 1))

def nearest_neighbor():
    current = 0
    unvisited = set(range(1, len(CITY_NAMES)))
    route = [current]

    while unvisited:
        # 成本相同时按城市下标选择,保证示例输出稳定。
        next_city = min(unvisited, key=lambda city: (COST[current][city], city))
        route.append(next_city)
        unvisited.remove(next_city)
        current = next_city

    route.append(0)
    return route

def exact_optimum():
    best_route = None
    best_cost = float("inf")

    for middle in permutations(range(1, len(CITY_NAMES))):
        route = (0, *middle, 0)
        cost = route_cost(route)
        if cost < best_cost:
            best_route = route
            best_cost = cost

    return best_route, best_cost

def format_route(route):
    return " -> ".join(CITY_NAMES[city] for city in route)

def main():
    heuristic_route = nearest_neighbor()
    optimal_route, optimal_cost = exact_optimum()
    heuristic_cost = route_cost(heuristic_route)

    print("启发式路线:", format_route(heuristic_route))
    print("启发式成本:", heuristic_cost)
    print("最优路线:", format_route(optimal_route))
    print("最优成本:", optimal_cost)
    print(f"质量比: {heuristic_cost / optimal_cost:.3f}")

if __name__ == "__main__":
    main()
将代码保存为 heuristic_boundary_demo.py,然后运行:
python heuristic_boundary_demo.py预期输出:
启发式路线: A -> B -> D -> C -> E -> A
启发式成本: 26
最优路线: A -> C -> E -> B -> D -> A
最优成本: 16
质量比: 1.625
最近邻规则迅速得到合法路线,但成本比最优解高 62.5%。这个结果不能推出所有输入都不超过该比例,也不能证明下一批数据仍有相同表现;它只是一条具体评估记录。
工程护栏与使用边界
启发式实现应把“生成候选解”和“验证候选解”分开。验证器必须检查硬约束,任何非法解都应被拒绝;质量阈值应根据业务损失定义,而不是只看算法平均分。含随机性的算法还应固定一组回归种子,并用多个种子报告分位数,避免只展示最好结果。
生产系统至少需要超时上限、输入规模限制、指标监控和回退路径。启发式适合做初始解生成器,也可以为精确搜索提供上界;当最坏情况损失不可接受、无法建立可靠校验器,或输入分布持续变化却缺少监控时,不应把启发式结果作为最终决策。
本课练习
- 修改成本矩阵中的一条边,使最近邻路线与最优路线相同。验收条件是程序输出的质量比为
1.000,并说明修改为何改变了局部选择。 - 为程序增加质量阈值
1.20:当质量比超过阈值时打印“切换到保底方案”。验收条件是当前样例触发回退,且最优路线仍作为评估基准输出。
本课总结
- 启发式方法的核心价值是快速获得可行候选解,其质量通常需要通过实验、监控和回退机制管理。
- 近似算法依赖可证明的最坏情况界限,启发式的单次或平均表现不能替代理论保证。
- 合法性校验、质量基准、停用阈值和保底路径共同决定启发式方案能否安全落地。
下一课预告
下一阶段可以把复杂性边界、随机化、近似与启发式方法结合起来,为同一优化问题选择可证明、可评估且符合时间预算的求解策略。