
数据结构与算法 / 系统课时
强连通分量
强连通分量
强连通分量把有向图划分为若干个内部互相可达、彼此不能继续合并的顶点集合。本课使用 Kosaraju 算法,通过完成时间顺序与转置图上的第二次 DFS 找出全部分量。
学习目标
- 准确判断两个顶点是否属于同一强连通分量。
- 理解两次 DFS、完成时间和转置图之间的配合关系。
- 使用邻接表实现 Kosaraju 算法并分析复杂度。
问题定义
在有向图中,若顶点 u 可以到达 v,且 v 也可以到达 u,二者就处于同一个强连通区域。强连通分量,简称 SCC,是满足互相可达且无法再加入其他顶点的最大集合。
单个顶点也可以构成 SCC。将每个 SCC 收缩成一个超级顶点后,分量之间形成的凝聚图一定是 DAG;否则若多个分量之间仍组成环,它们实际上应被合并为同一个更大的强连通分量。
两次 DFS 的核心机制
Kosaraju 算法第一遍在原图上执行 DFS,并在顶点完成时压栈。越晚完成的顶点越靠近栈顶,这个顺序能让第二遍搜索优先从凝聚图中尚未处理的源分量开始。
随后反转所有边得到转置图。按栈顶到栈底依次取顶点,在转置图上执行第二遍 DFS;一次搜索访问到的全部顶点恰好构成一个 SCC。第二遍必须使用独立的访问数组,不能沿用第一遍的标记。
| 阶段 | 操作对象 | 关键产物 |
|---|---|---|
| 第一次 DFS | 原图 | 顶点完成时间的逆序栈 |
| 图转置 | 全部有向边 | 每条 u -> v 变为 v -> u |
| 第二次 DFS | 转置图 | 每次搜索收集一个 SCC |
执行过程
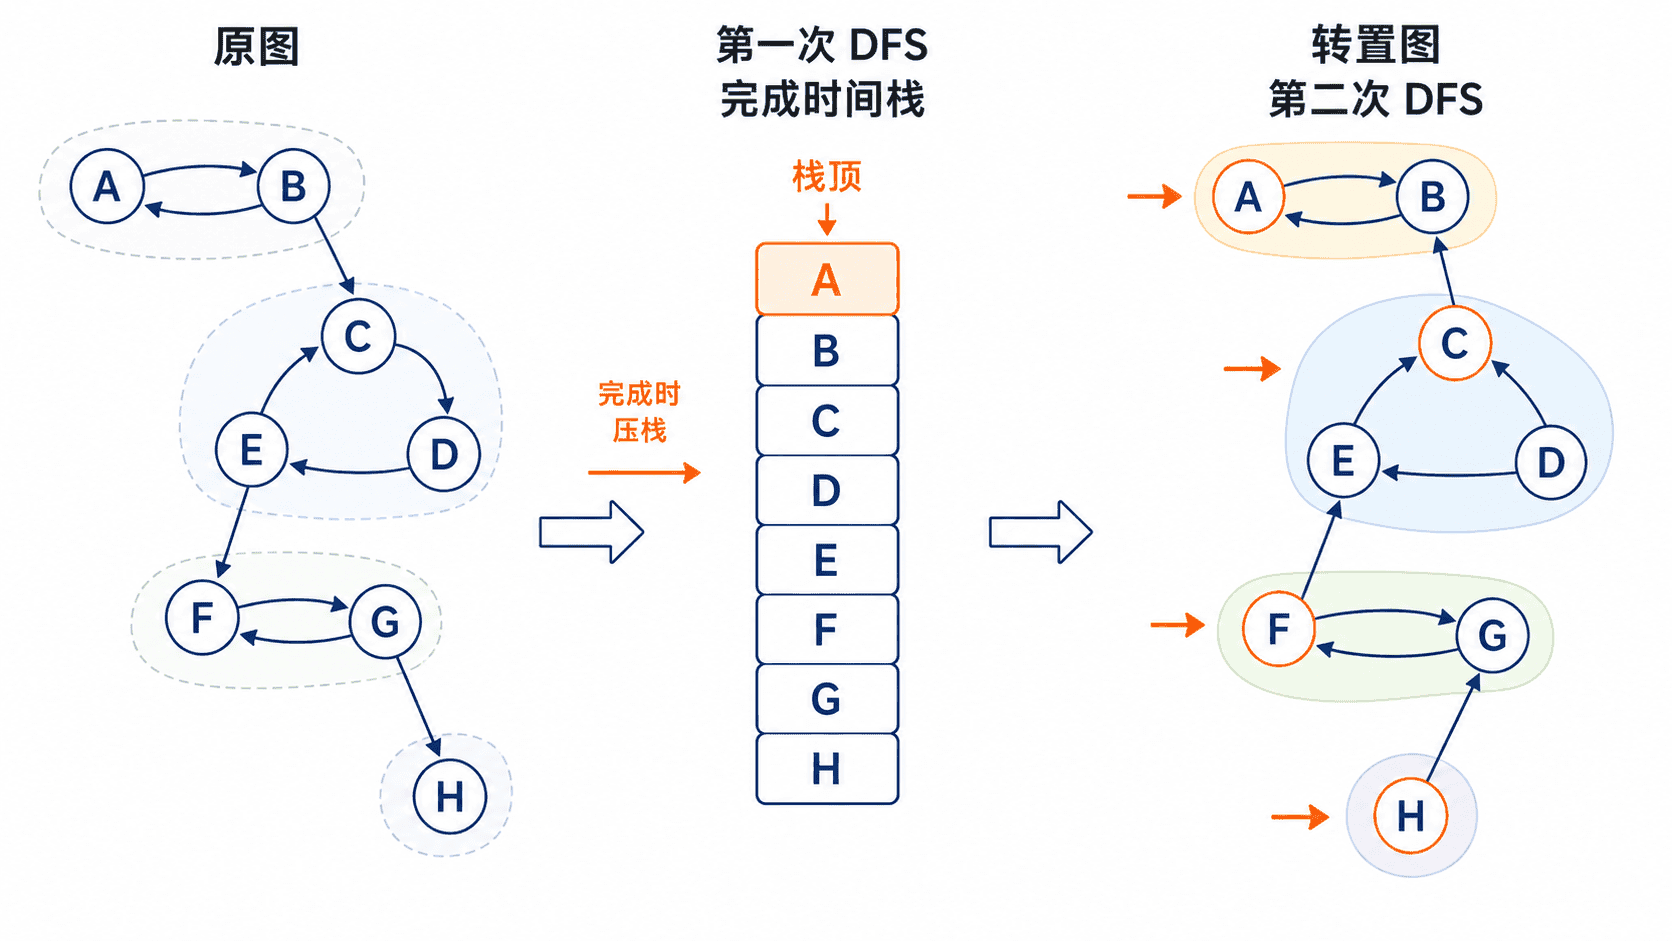
下图展示原图中的四个强连通区域、第一遍 DFS 的完成顺序,以及在转置图上按出栈顺序收集分量的过程。重点观察:转置只改变分量之间的方向,不会破坏分量内部的互相可达关系。
完整可运行示例
下面的 Java 17 程序构造四个 SCC:[A, B]、[C, D, E]、[F, G] 和 [H]。第一遍 DFS 记录完成顺序,第二遍在转置图上收集分量;为使输出易于核对,每个分量内部按字母排序。
import java.util.ArrayDeque;
import java.util.ArrayList;
import java.util.Collections;
import java.util.Deque;
import java.util.List;

public class StronglyConnectedComponentsDemo {

    public static void main(String[] args) {
        List<List<Integer>> graph = createGraph(8);
        addEdge(graph, 0, 1); // A -> B
        addEdge(graph, 1, 0); // B -> A
        addEdge(graph, 1, 2); // B -> C
        addEdge(graph, 2, 3); // C -> D
        addEdge(graph, 3, 4); // D -> E
        addEdge(graph, 4, 2); // E -> C
        addEdge(graph, 4, 5); // E -> F
        addEdge(graph, 5, 6); // F -> G
        addEdge(graph, 6, 5); // G -> F
        addEdge(graph, 6, 7); // G -> H

        List<List<Integer>> components = kosaraju(graph);
        for (int i = 0; i < components.size(); i++) {
            System.out.println("SCC " + (i + 1) + ": " + format(components.get(i)));
        }
        System.out.println("组件数量: " + components.size());
    }

    private static List<List<Integer>> kosaraju(List<List<Integer>> graph) {
        boolean[] visited = new boolean[graph.size()];
        Deque<Integer> finishOrder = new ArrayDeque<>();

        // 第一遍 DFS:按完成时间逆序保存顶点。
        for (int vertex = 0; vertex < graph.size(); vertex++) {
            if (!visited[vertex]) {
                fillFinishOrder(vertex, graph, visited, finishOrder);
            }
        }

        List<List<Integer>> reversed = reverseGraph(graph);
        boolean[] assigned = new boolean[graph.size()];
        List<List<Integer>> components = new ArrayList<>();

        // 第二遍 DFS:在转置图上一次收集一个强连通分量。
        while (!finishOrder.isEmpty()) {
            int vertex = finishOrder.pop();
            if (!assigned[vertex]) {
                List<Integer> component = new ArrayList<>();
                collect(vertex, reversed, assigned, component);
                Collections.sort(component);
                components.add(component);
            }
        }
        return components;
    }

    private static void fillFinishOrder(
            int current,
            List<List<Integer>> graph,
            boolean[] visited,
            Deque<Integer> finishOrder) {
        visited[current] = true;
        for (int next : graph.get(current)) {
            if (!visited[next]) {
                fillFinishOrder(next, graph, visited, finishOrder);
            }
        }
        finishOrder.push(current);
    }

    private static void collect(
            int current,
            List<List<Integer>> reversed,
            boolean[] assigned,
            List<Integer> component) {
        assigned[current] = true;
        component.add(current);
        for (int next : reversed.get(current)) {
            if (!assigned[next]) {
                collect(next, reversed, assigned, component);
            }
        }
    }

    private static List<List<Integer>> reverseGraph(List<List<Integer>> graph) {
        List<List<Integer>> reversed = createGraph(graph.size());
        for (int from = 0; from < graph.size(); from++) {
            for (int to : graph.get(from)) {
                reversed.get(to).add(from);
            }
        }
        return reversed;
    }

    private static List<List<Integer>> createGraph(int size) {
        List<List<Integer>> graph = new ArrayList<>();
        for (int i = 0; i < size; i++) {
            graph.add(new ArrayList<>());
        }
        return graph;
    }

    private static void addEdge(List<List<Integer>> graph, int from, int to) {
        graph.get(from).add(to);
    }

    private static String format(List<Integer> component) {
        List<String> labels = new ArrayList<>();
        for (int vertex : component) {
            labels.add(String.valueOf((char) ('A' + vertex)));
        }
        return labels.toString();
    }
}
将代码保存为 StronglyConnectedComponentsDemo.java,然后运行:
javac StronglyConnectedComponentsDemo.java
java StronglyConnectedComponentsDemo
预期输出
SCC 1: [A, B]
SCC 2: [C, D, E]
SCC 3: [F, G]
SCC 4: [H]
组件数量: 4
分量之间的输出顺序由 DFS 遍历顺序决定,但每个顶点必须且只能出现在一个 SCC 中。
复杂度、Tips 与常见错误
两遍 DFS 各访问一次全部顶点和边,构造转置图也需遍历全部边,因此总时间复杂度为 。原图、转置图、访问数组、完成顺序栈和递归栈合计需要 空间。
- 转置图必须新建反向邻接表;仅反转遍历顺序并不能替代反转边。
- 第一遍必须在“完成顶点”时压栈,若在刚进入顶点时压栈,第二遍起点顺序会失效。
- 第二遍必须使用新的
assigned数组,否则第一遍已标记的顶点会导致所有搜索被跳过。 - 不要把弱连通分量与 SCC 混淆;忽略边方向后连通,只能说明顶点属于同一弱连通区域。
本课练习
- 删除边
G -> F,重新运行程序,确认[F, G]被拆成两个单顶点分量,并解释原因。 - 为程序增加
componentId数组,使每个顶点都能查询自己所属的 SCC 编号,验收条件是 A、B 编号相同且 H 与其他顶点不同。 - 根据求得的分量构造凝聚图,去除重复边,并验证新图能够成功完成拓扑排序。
本课总结
- SCC 是有向图中内部互相可达且不可继续扩大的顶点集合,单个顶点也可能独立成分量。
- Kosaraju 算法先在原图记录完成顺序,再在转置图上按该顺序收集分量。
- 将 SCC 收缩后得到的凝聚图一定无环,可继续用于依赖分析和拓扑处理。
下一课预告
完成图的表示、遍历与连通性分析后,下一阶段可继续研究最短路径、最小生成树等带权图算法,并比较它们对边权和图结构的不同要求。