
数据结构与算法 / 系统课时
记忆化搜索
记忆化搜索
朴素递归会反复计算相同子问题,导致调用次数随输入规模快速增长。本课把缓存加入递归过程,使每个状态只在第一次访问时计算,后续直接复用结果。
学习目标
- 识别递归树中的重复子问题,并设计稳定的缓存键。
- 实现自顶向下的记忆化搜索,理解缓存命中与递归终止的关系。
- 分析记忆化搜索的时间复杂度、空间复杂度和常见边界问题。
核心原理
记忆化搜索保留递归写法,但在求解状态前先查询缓存。若状态已经计算过,就直接返回缓存值;若尚未计算,则递归求出结果并写入缓存。这样既保留了“从目标状态向依赖状态展开”的思考方式,又消除了重复计算。
以斐波那契数列为例,朴素递归中的 fib(8) 会多次进入 fib(6)、fib(5) 等状态。加入缓存后,每个 fib(k) 只执行一次真正的状态转移,其余调用只进行一次数组读取。
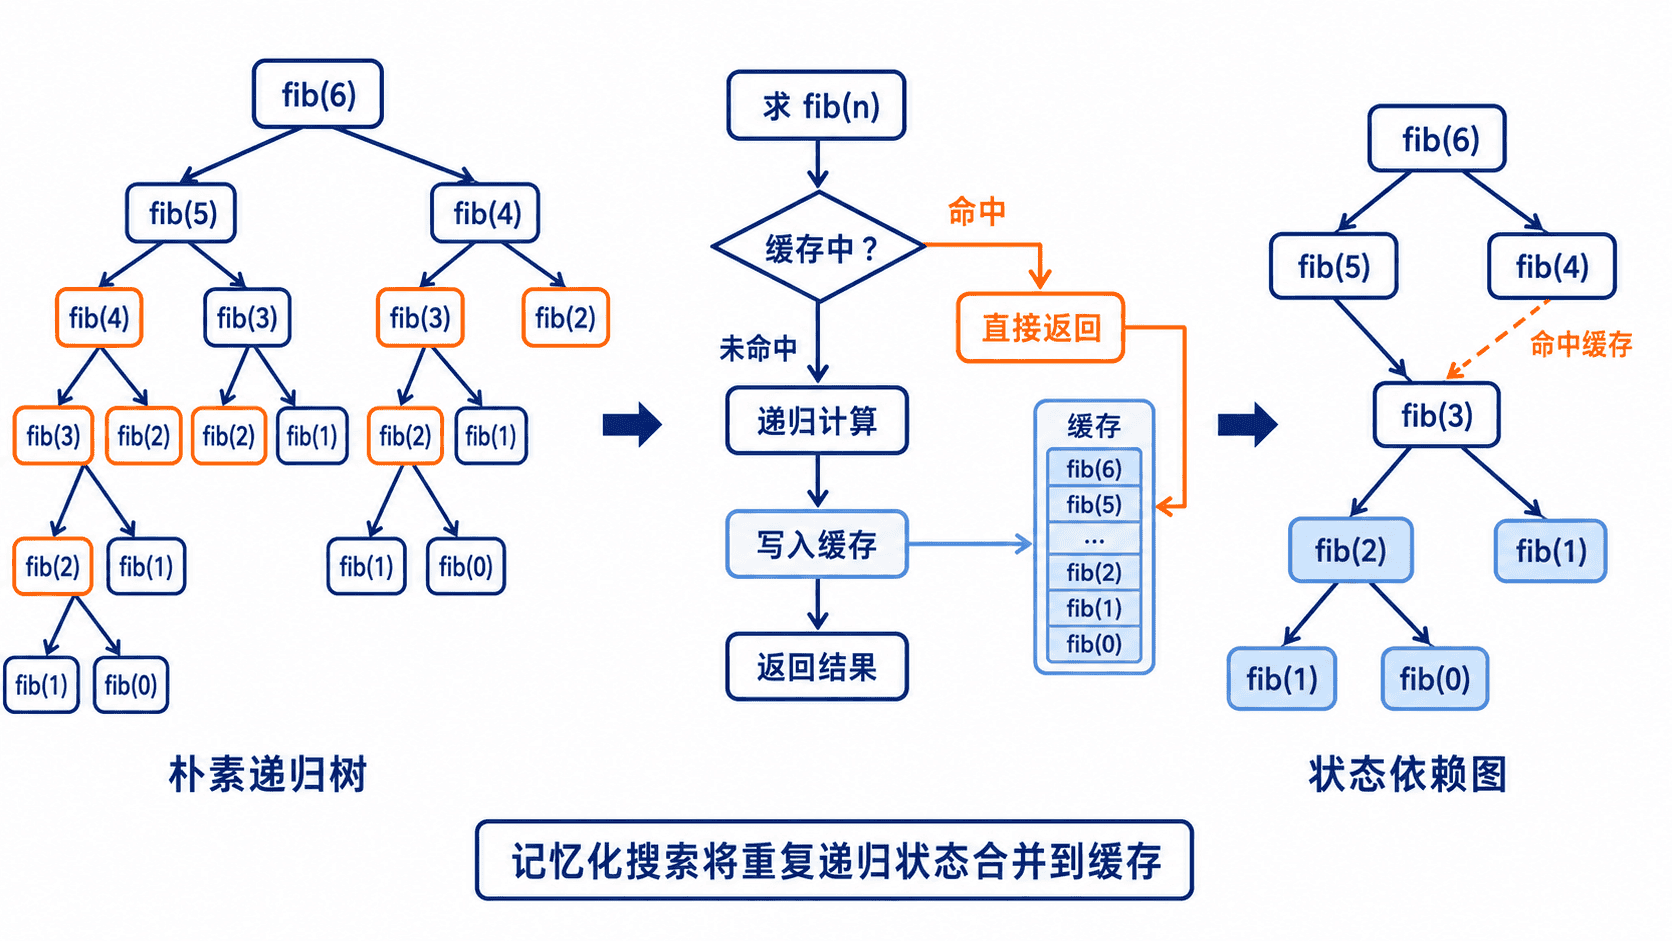
缓存键必须完整描述一个状态。若结果由两个参数共同决定,就不能只缓存其中一个参数。缓存还要能区分“尚未计算”和“结果恰好为 0”,因此常用额外的布尔数组、特殊哨兵值或映射容器表示未计算状态。
对于共有 n + 1 个状态、每个状态只依赖常数个子状态的问题,记忆化后的时间复杂度通常为 O(n)。数组缓存占用 O(n) 空间,递归调用栈最深也可能达到 O(n)。
完整可运行示例
下面的 Java 17 程序同时运行朴素递归和记忆化搜索,并统计方法调用次数。将代码保存为 MemoizedFibonacci.java。
java
import java.util.Arrays;

public class MemoizedFibonacci {

    private static long naiveCalls;
    private static long memoCalls;
    private static long[] memo;

    private static long fibonacciNaive(int n) {
        naiveCalls++;
        if (n <= 1) {
            return n;
        }
        return fibonacciNaive(n - 1) + fibonacciNaive(n - 2);
    }

    private static long fibonacciMemo(int n) {
        memoCalls++;

        // 已计算状态直接返回,避免继续展开递归树。
        if (memo[n] != -1) {
            return memo[n];
        }

        memo[n] = fibonacciMemo(n - 1) + fibonacciMemo(n - 2);
        return memo[n];
    }

    public static void main(String[] args) {
        int n = 10;

        long naiveResult = fibonacciNaive(n);

        // -1 表示尚未计算,基础状态提前写入缓存。
        memo = new long[n + 1];
        Arrays.fill(memo, -1);
        memo[0] = 0;
        memo[1] = 1;

        long memoResult = fibonacciMemo(n);

        System.out.println("fib(" + n + ") = " + memoResult);
        System.out.println("朴素递归调用次数: " + naiveCalls);
        System.out.println("记忆化调用次数: " + memoCalls);
        System.out.println("两种结果一致: " + (naiveResult == memoResult));
    }
}
编译并运行:
bash
javac MemoizedFibonacci.java
java MemoizedFibonacci
预期输出与常见错误
text
fib(10) = 55
朴素递归调用次数: 177
记忆化调用次数: 19
两种结果一致: true
常见错误是只读取缓存却忘记写回,结果仍然会重复递归;另一个错误是使用合法结果作为“未计算”标记,例如用 0 标记未计算,而某些状态的正确答案也可能是 0。修复时应选择不会与合法结果冲突的哨兵值,或单独记录计算状态。
递归深度过大时,即使时间复杂度已经下降,也可能出现栈溢出。此时应改为自底向上的迭代写法,或显式使用栈管理搜索过程。
本课总结
- 记忆化搜索等于“递归状态转移 + 缓存”,每个状态只进行一次真正计算。
- 缓存键必须覆盖决定结果的全部参数,并可靠区分未计算状态。
- 时间复杂度取决于状态数量与单个状态的转移成本,空间还需计入缓存和递归栈。
下一课预告
下一课将学习“自底向上动态规划”,根据状态依赖安排迭代顺序,把递归调用转化为可控的循环计算。
按自己的节奏,确认真正理解。