
数据结构与算法 / 系统课时
布隆过滤器
布隆过滤器
布隆过滤器可以作为精确查询前的一道预筛。它用固定数量的位描述已插入的集合。一个候选若通过过滤,仍可能是其他元素共享位造成的假阳性。
学习目标
- 从置位和查询规则解释假阳性与无假阴性的条件。
- 读懂位数、哈希个数、插入规模与假阳性率的关系。
- 运行打包位数组并核对一个可复现的假阳性。
查询结果表示什么
将每个元素映射到 个位置,插入时把对应位设置为 1。查询时只要某一位为 0,就能排除这个候选。所有位为 1 只能说明可能插入过。结论依赖插入完成、查询使用相同编码和参数、已置位不被清除。若过滤器在同步或重建时落后于真实集合,直接把未通过的请求当作不存在可能漏掉新数据。 Bloom 原论文 Broder 与 Mitzenmacher 的应用与变体综述
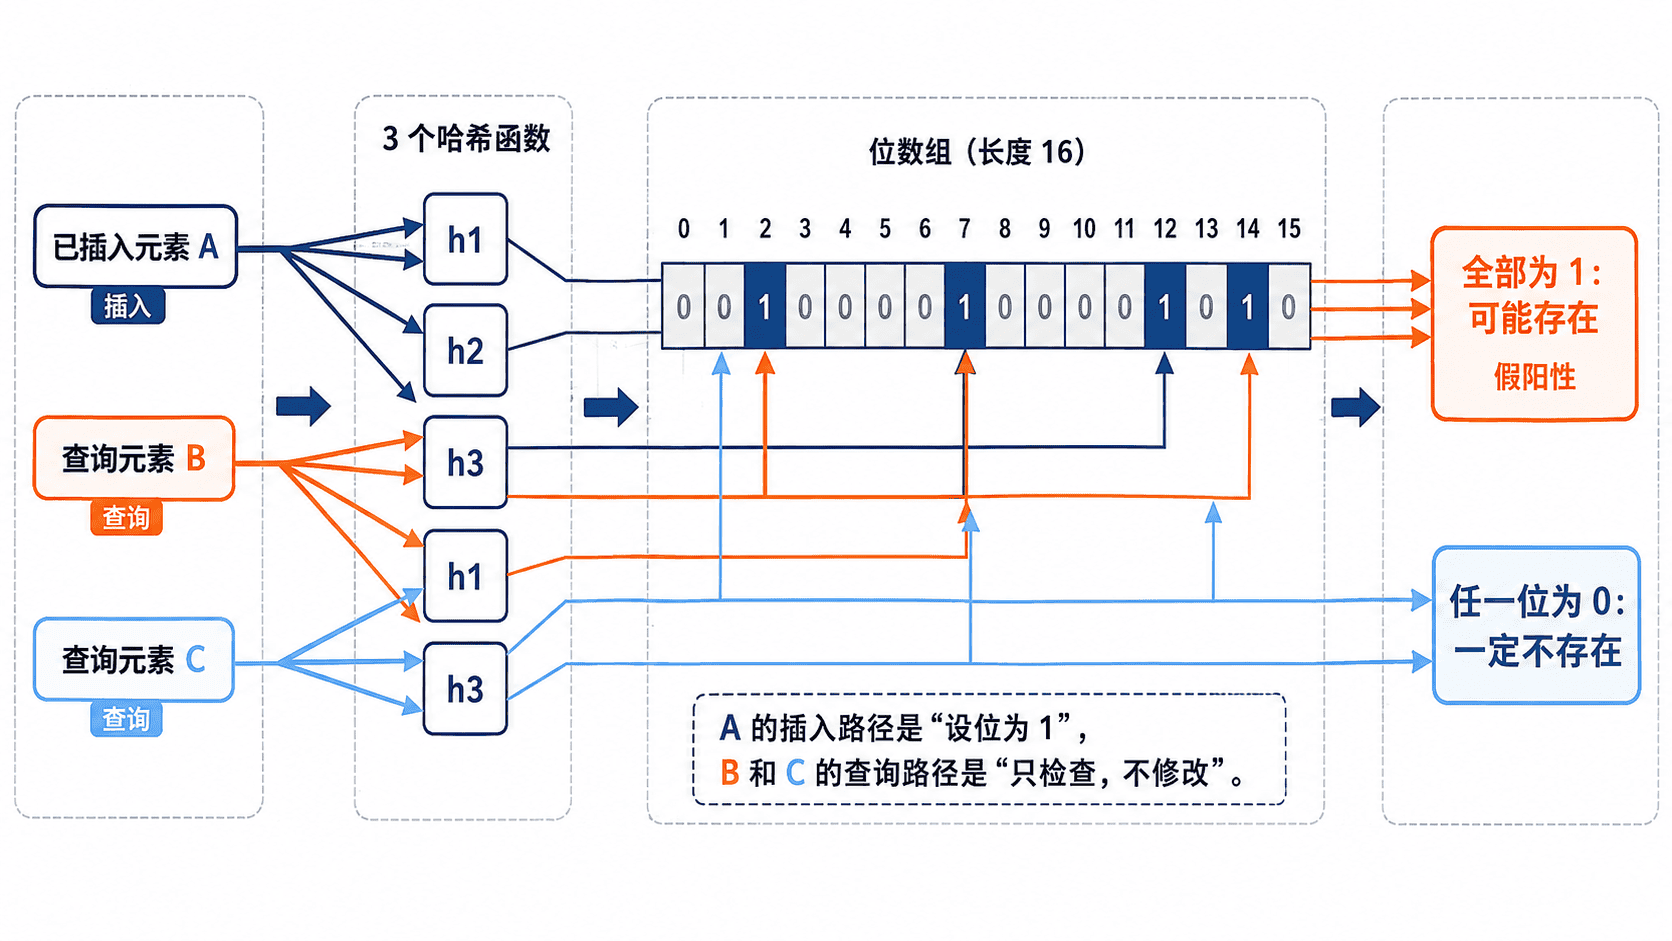
对 位、 次近似均匀独立映射和 个不同插入元素,未插入候选的假阳性率常用 估算。有限数组和相关位置会造成偏差,真实查询分布也会改变实测值。固定 时,连续近似的最优 为 ,实际取合适正整数,再评估误判率和计算预算。 Bloom 过滤器参数推导
Python 3.11 可运行示例
保存为 bloom_filter_demo.py。此例将位打包到 bytearray,用四字节编号作为哈希前缀,再以 SHA-256 计算稳定位置。前缀区分各次计算,但不意味着严格独立。此例每次哈希都处理编码后的键;对长度为 的字节串,除了 次位访问,还要考虑最多 的哈希工作。 Python hashlib
from hashlib import sha256


class BloomFilter:
    def __init__(self, bit_count: int, hash_count: int):
        if type(bit_count) is not int or bit_count < 1:
            raise ValueError("bit_count must be a positive integer")
        if type(hash_count) is not int or not 1 <= hash_count <= 2**32:
            raise ValueError("hash_count must fit the four-byte seed range")
        self.bit_count = bit_count
        self.hash_count = hash_count
        self._bits = bytearray((bit_count + 7) // 8)

    def _indexes(self, value: str):
        encoded = value.encode("utf-8")
        for seed in range(self.hash_count):
            digest = sha256(seed.to_bytes(4, "big") + encoded).digest()
            yield int.from_bytes(digest[:8], "big") % self.bit_count

    def add(self, value: str) -> None:
        for index in self._indexes(value):
            byte_index, offset = divmod(index, 8)
            self._bits[byte_index] |= 1 << offset

    def might_contain(self, value: str) -> bool:
        for index in self._indexes(value):
            byte_index, offset = divmod(index, 8)
            if not (self._bits[byte_index] & (1 << offset)):
                return False
        return True


if __name__ == "__main__":
    bloom = BloomFilter(32, 3)
    actual = {"apple", "banana"}
    for value in sorted(actual):
        bloom.add(value)
    for value in ("apple", "cherry", "item-548"):
print(f"{value}: maybe={bloom.might_contain(value)}, actual={value in actual}")apple: maybe=True, actual=True
cherry: maybe=False, actual=False
item-548: maybe=True, actual=False前两项分别展示已插入项和一个可排除项。最后一项是未插入的键,它的目标位恰好都被置为 1。重复添加同一个键只会设置同样的位。位区实际使用 字节,另有对象元数据。不同参数生成的位区不能直接混用。
删除与精确查询
多个键可能共享同一位,普通过滤器不能按单个元素安全清除位置。计数变体可按已确认插入的次数递增和递减,但仍需避免删不存在的元素、计数溢出或不同步。若任务要求精确去重,过滤器通过时还要查真实集合;仅靠过滤器丢弃候选会把假阳性当作重复。 Bloom 过滤器删除与计数变体
本课练习
固定同一批插入键和确定不重叠的查询集,分别测量 64 位与 512 位时的假阳性比例。用公式估算后比较差异,同时核对所有已插入键仍通过过滤。下一章将进入树与搜索树。