
数据结构与算法 / 系统课时
算法与数据结构选型
算法与数据结构选型
问题模型确定后,仍需选择能满足规模、延迟和内存目标的实现。本课以“百万级整数用户 ID 的在线状态查询”为例,建立一套从操作分布到候选结构、再到验证结论的选型方法。
学习目标
- 从数据规模、操作频率、内存和实时性四个维度比较方案
- 根据业务约束缩小算法与数据结构的候选范围
- 使用可运行样例和验收指标验证选型结论
先建立选择维度
选型不是背诵复杂度表,而是把复杂度与真实工作负载结合。对于同一个集合,查询占 99% 与写入占 99% 时,最佳结构可能完全不同;数据是否有界、是否要求排序,也会直接改变候选范围。
| 维度 | 必须确认的问题 | 对选型的影响 |
|---|---|---|
| 数据规模 | 元素数量和键空间上限是多少 | 决定内存预算与复杂度常数 |
| 操作频率 | 查询、插入、删除、遍历各占多少 | 决定需要优先优化的操作 |
| 内存限制 | 单实例可用内存和对象开销是多少 | 排除高额对象封装方案 |
| 实时性 | 关注平均延迟还是尾延迟 | 决定是否需要稳定上界和压测 |
| 数据特征 | 键是否连续、有界、重复或有序 | 决定能否使用数组、位图或树 |
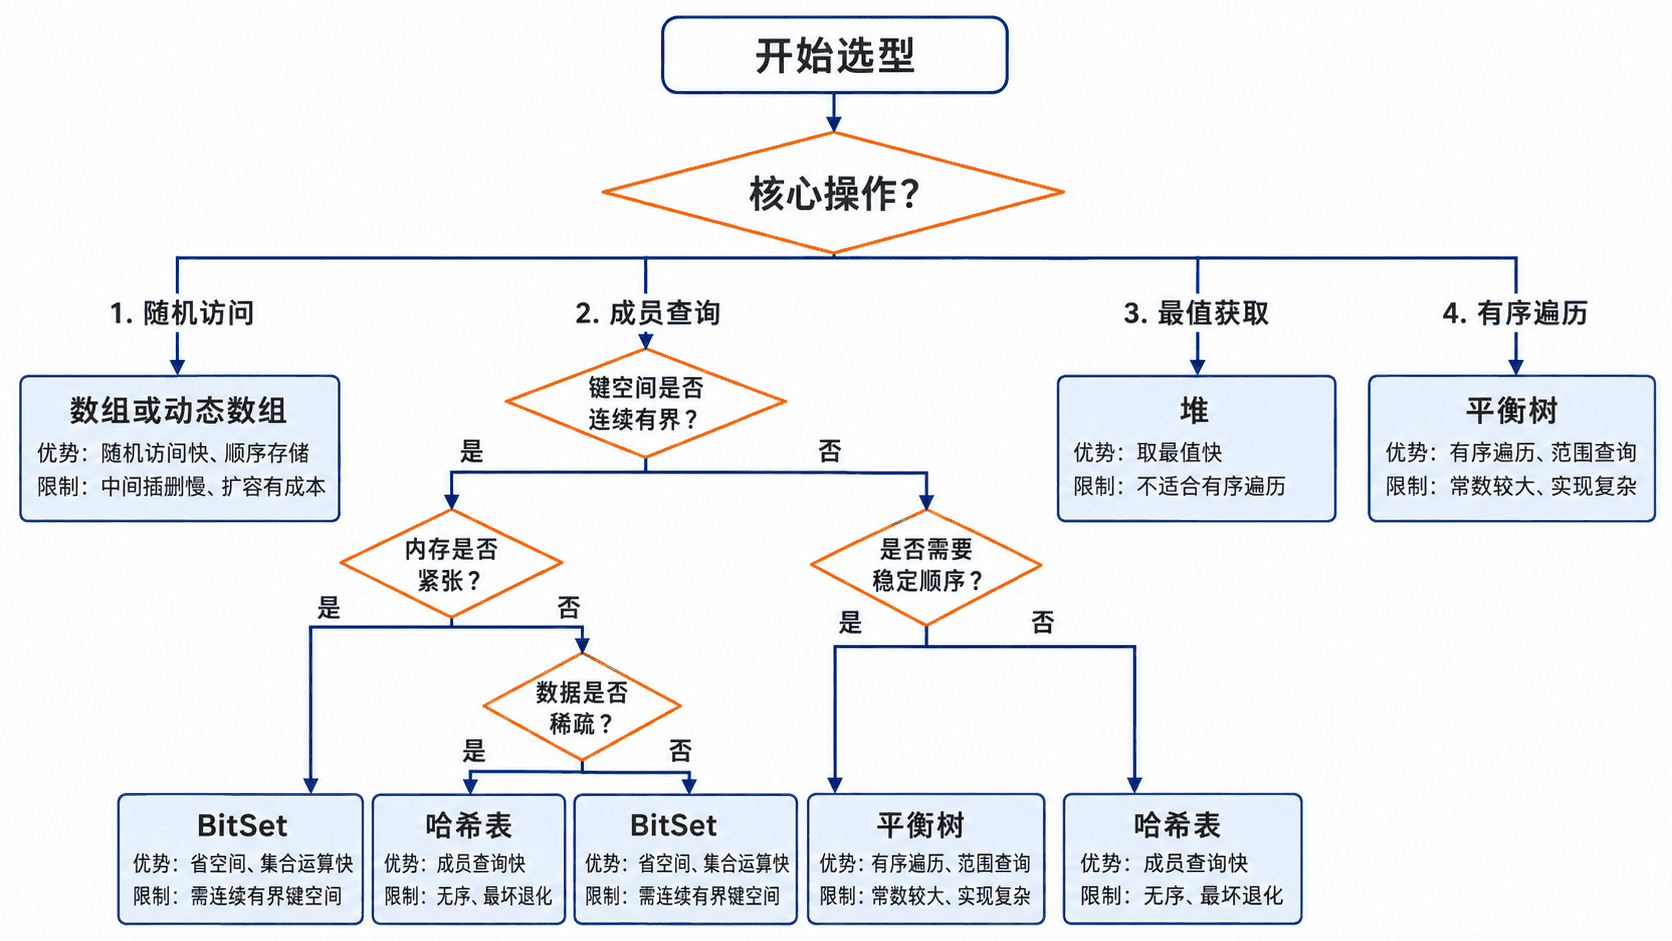
用操作分布估算总成本
可以用一个简化表达式比较候选方案:
其中 、、 分别表示查询、写入和删除次数,、、 表示对应操作的单次成本。这个表达式不是精确性能预测,但能避免只看某一个操作的复杂度。
以成员查询为核心时,常见候选结构可这样比较:
| 结构 | 成员查询 | 插入或设置 | 顺序能力 | 适用条件 |
|---|---|---|---|---|
ArrayList |
尾部均摊 | 保留插入顺序 | 数据较少,遍历多于查询 | |
HashSet |
期望 | 期望 | 不保证稳定顺序 | 键空间离散,通用成员查询 |
TreeSet |
自动有序 | 需要范围查询或有序遍历 | ||
BitSet |
按整数下标扫描 | 非负整数键有明确上界 |
复杂度相同也不代表实际成本相同。对象数量、缓存局部性、哈希计算、扩容和垃圾回收都会影响延迟,因此复杂度用于初筛,基准测试用于最终确认。
场景选型
假设系统维护用户是否在线,用户 ID 是 到 的非负整数。业务每秒进行大量成员查询,写入和删除较少,不要求按上线时间排序,并希望单实例内存尽量小。
在这个约束下,BitSet 比 HashSet<Integer> 更合适:
- 键空间连续且上界明确,可以直接用用户 ID 作为位下标。
- 每个状态只占 1 位,100 万个位约需 125000 字节的位存储空间,约为 122 KiB,不包含少量对象开销。
- 查询、设置和清除都通过位运算完成,路径短且没有整数装箱。
- 如果键改为 UUID,或整数上界极大而实际元素极少,
BitSet会浪费空间,此时应重新评估HashSet。
完整可运行示例
下面的 Java 17 程序使用 BitSet 保存在线状态,并演示设置、清除、查询和统计操作。
java
import java.util.BitSet;

public class BitSetSelectionDemo {

    public static void main(String[] args) {
        int userIdUpperBound = 1_000_000;
        BitSet onlineUsers = new BitSet(userIdUpperBound);

        // 用户上线时设置对应位,下线时清除对应位。
        onlineUsers.set(42);
        onlineUsers.set(700_000);
        onlineUsers.set(999_999);
        onlineUsers.clear(700_000);

        System.out.println("用户 42 在线: " + onlineUsers.get(42));
        System.out.println("用户 700000 在线: " + onlineUsers.get(700_000));
        System.out.println("当前在线人数: " + onlineUsers.cardinality());

        // previousSetBit 用于从右向左寻找最高的已设置下标。
        int highestOnlineUser = onlineUsers.previousSetBit(onlineUsers.length() - 1);
        System.out.println("最大在线用户 ID: " + highestOnlineUser);
    }
}
将代码保存为 BitSetSelectionDemo.java,然后执行:
bash
javac BitSetSelectionDemo.java
java BitSetSelectionDemo
预期输出
text
用户 42 在线: true
用户 700000 在线: false
当前在线人数: 2
最大在线用户 ID: 999999
输出验证了用户 42 和 999999 仍在线,用户 700000 已被清除,集合中共有两个有效状态。
用指标验证选型
完成初步选择后,应使用接近生产的数据验证,而不是只运行一个功能样例。验证清单至少包括:
- 使用真实数量级和相似分布的数据,避免只测几十个元素。
- 分别记录查询、写入和删除的吞吐量、平均延迟与高分位延迟。
- 测量稳定状态下的内存占用,并观察扩容或垃圾回收带来的波动。
- 覆盖空集合、最大合法键、重复写入和非法键等边界。
- Java 微基准应使用 JMH 等专用框架,避免把 JVM 预热和编译优化误判为算法差异。
常见错误
- 只看大 O 记号:两个期望 的结构可能有显著不同的对象和缓存成本。修复方式是同时比较常数、内存和目标硬件上的实测结果。
- 忽略数据特征变化:当前整数键有界,不代表未来接入的键仍然有界。应把键空间假设写入设计文档和监控指标。
- 用平均延迟代替实时性结论:平均值可能掩盖扩容或回收造成的尖峰。需要同时检查高分位延迟和最坏业务场景。
本课练习
- 为“保存 500 万个商品 ID,并频繁判断是否已售罄”设计候选方案。分别讨论连续整数 ID 与 UUID 两种输入,给出首选结构、排除理由和需要验证的指标。
- 一个任务调度器需要频繁插入任务并获取最早截止任务。比较排序数组、
TreeSet和优先队列,写出操作频率假设与验收条件,要求结论能解释为何成员查询不是首要指标。
本课总结
- 选型必须同时考虑数据规模、操作分布、内存、实时性和键特征。
- 复杂度用于缩小候选范围,功能样例与基准测试用于验证真实可用性。
- 任何选型结论都依赖明确假设,假设变化时应重新评估,而不是沿用旧方案。
下一课预告
下一阶段将把需求建模与选型方法应用到综合算法项目中,继续完成实现、测试、性能验证和验收闭环。
按自己的节奏,确认真正理解。