
数据结构与算法 / 系统课时
KMP 匹配算法
KMP 匹配算法
KMP 在文本扫描过程中保留“模式串已经匹配了多长”这一状态,失配时利用前缀函数跳转到仍可能成立的边界。这样文本指针始终向前移动,并能在线性时间内找出单次或全部匹配位置。
学习目标
- 使用前缀函数维护 KMP 的匹配状态。
- 解释失配回退与重叠匹配的处理方式。
- 分析算法的时间、空间复杂度和边界条件。
问题定义
给定文本 text 和非空模式串 pattern,目标是找出模式串在文本中的起始下标。朴素匹配在失配后会移动起点并重复比较已经确认过的字符;KMP 则让文本下标 i 只向右移动,用状态 j 表示当前已经匹配的模式串前缀长度。
当 j = 0 时,当前没有可复用的匹配;当 j = pattern.length() 时,说明刚刚找到一次完整匹配,其起点为 i - pattern.length() + 1。
状态转移与执行过程
每读取一个文本字符,KMP 按以下顺序处理:
- 若当前字符与
pattern[j]不同且j > 0,令j = pi[j - 1],继续尝试更短边界。 - 若当前字符与
pattern[j]相同,令j++。 - 若
j达到模式串长度,记录匹配起点,再令j = pi[j - 1],以支持重叠匹配。
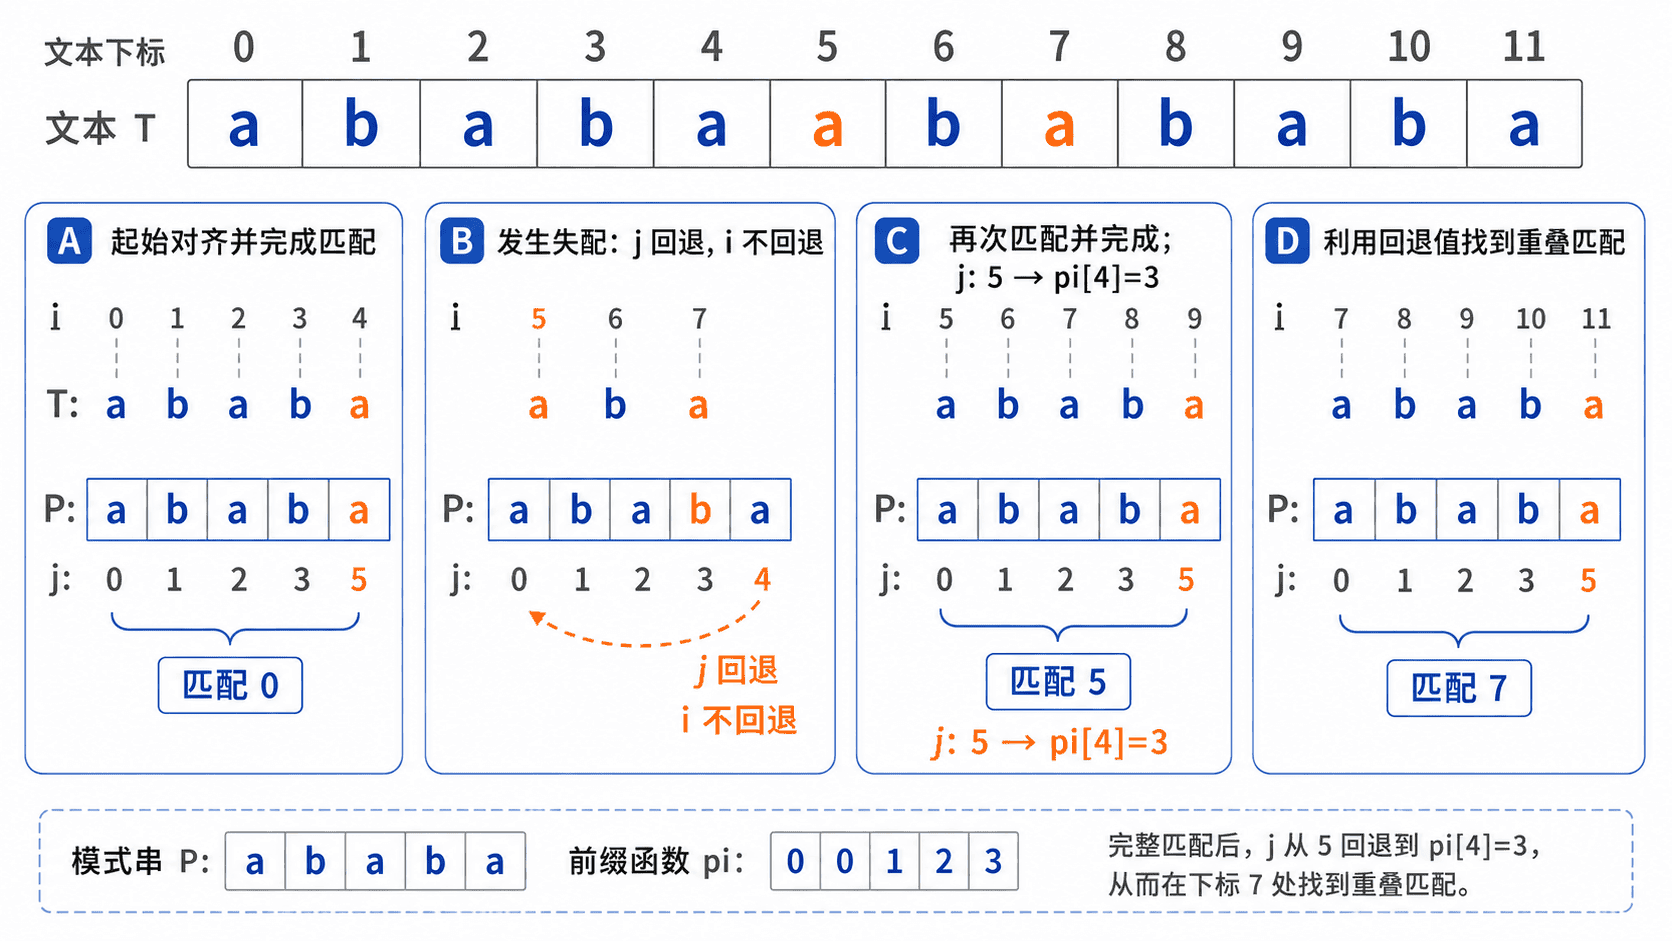
例如完整匹配 ababa 后,不能把 j 直接清零。该模式串的 pi[4] = 3,说明结尾的 aba 同时也是开头的 aba,保留状态 3 才能继续发现与前一次重叠的后续匹配。
预处理前缀函数需要 O(m),扫描长度为 n 的文本需要 O(n),总时间复杂度为 O(n + m)。保存前缀函数需要 O(m) 空间;若只返回第一个匹配位置,额外结果空间为 O(1)。
完整可运行示例
下面的 Java 17 程序输出每次读取字符后的状态,并返回全部匹配起点。将文件保存为 KmpSearchDemo.java。
import java.util.ArrayList;
import java.util.List;

public class KmpSearchDemo {

    static int[] buildPrefixFunction(String pattern) {
        int[] pi = new int[pattern.length()];

        for (int i = 1; i < pattern.length(); i++) {
            int j = pi[i - 1];

            while (j > 0 && pattern.charAt(i) != pattern.charAt(j)) {
                j = pi[j - 1];
            }

            if (pattern.charAt(i) == pattern.charAt(j)) {
                j++;
            }

            pi[i] = j;
        }

        return pi;
    }

    static List<Integer> findAll(String text, String pattern) {
        if (pattern.isEmpty()) {
            throw new IllegalArgumentException("pattern must not be empty");
        }

        int[] pi = buildPrefixFunction(pattern);
        List<Integer> matches = new ArrayList<>();
        int j = 0;

        for (int i = 0; i < text.length(); i++) {
            // 文本指针 i 不回退,只调整已匹配长度 j。
            while (j > 0 && text.charAt(i) != pattern.charAt(j)) {
                j = pi[j - 1];
            }

            if (text.charAt(i) == pattern.charAt(j)) {
                j++;
            }

            System.out.printf(
                    "i=%d, char=%c, state=%d%n",
                    i,
                    text.charAt(i),
                    j
            );

            if (j == pattern.length()) {
                int start = i - pattern.length() + 1;
                matches.add(start);
                System.out.println("match at index " + start);

                // 保留最长边界,继续查找可能重叠的匹配。
                j = pi[j - 1];
            }
        }

        return matches;
    }

    public static void main(String[] args) {
        String text = "ababaabababa";
        String pattern = "ababa";

        List<Integer> matches = findAll(text, pattern);
        System.out.println("matches = " + matches);
    }
}
运行命令:
javac KmpSearchDemo.java
java KmpSearchDemo
预期输出:
i=0, char=a, state=1
i=1, char=b, state=2
i=2, char=a, state=3
i=3, char=b, state=4
i=4, char=a, state=5
match at index 0
i=5, char=a, state=1
i=6, char=b, state=2
i=7, char=a, state=3
i=8, char=b, state=4
i=9, char=a, state=5
match at index 5
i=10, char=b, state=4
i=11, char=a, state=5
match at index 7
matches = [0, 5, 7]
验证、Tips 与常见错误
调试 KMP 时,应同时观察 i 和 j:i 代表已经消费到的文本位置,j 代表模式串状态。失配只改变 j,不能把 i 移回旧位置,否则会失去线性扫描的优势。
常见错误是在找到完整匹配后执行 j = 0。这样仍能找到不重叠匹配,却会漏掉共享前后缀的重叠结果;正确做法是执行 j = pi[j - 1]。另一个错误是直接访问空模式串的 pattern.charAt(0),示例通过抛出 IllegalArgumentException 明确拒绝该输入。
若只需要第一次出现的位置,可以在首次满足 j == pattern.length() 时立即返回起点。处理超大文本流时,前缀函数只依赖模式串,因此可以预先构建并复用,而文本字符可以逐块读取。
本课练习
- 修改
findAll,只返回第一个匹配下标;找不到时返回-1。使用文本hello algorithm和模式串algorithm验证结果应为6。 - 使用文本
aaaaa和模式串aaa验证重叠匹配。验收条件是返回[0, 1, 2],且文本下标从不回退。
本课总结
- KMP 用
j保存已匹配前缀长度,文本指针始终向前。 - 失配和完整匹配后的跳转都由前缀函数决定。
- 预处理与扫描合计为
O(n + m),并能正确处理重叠匹配。
下一课预告
接下来可以继续学习字符串周期、重复结构与多模式匹配,理解前缀函数之外的字符串预处理方法如何服务于更复杂的检索任务。