
数据结构与算法 / 系统课时
霍夫曼编码
霍夫曼编码
给定字符频率,本课将使用最小优先队列反复合并两个最低频节点,构造无歧义的前缀码。你将完成编码树、编码表、编码与解码程序,并理解局部最优合并如何导向最小加权路径长度。
学习目标
- 能够使用优先队列构造霍夫曼树。
- 能够从根到叶生成前缀编码并完成解码。
- 能够分析构造过程的复杂度与关键边界。
构造原理与合并过程
霍夫曼算法把每个字符视为一棵单节点树,并将它们放入按频率升序排列的最小优先队列。每轮取出频率最低的两棵树,创建频率之和作为父节点,再把新树放回队列,直到只剩一棵树。
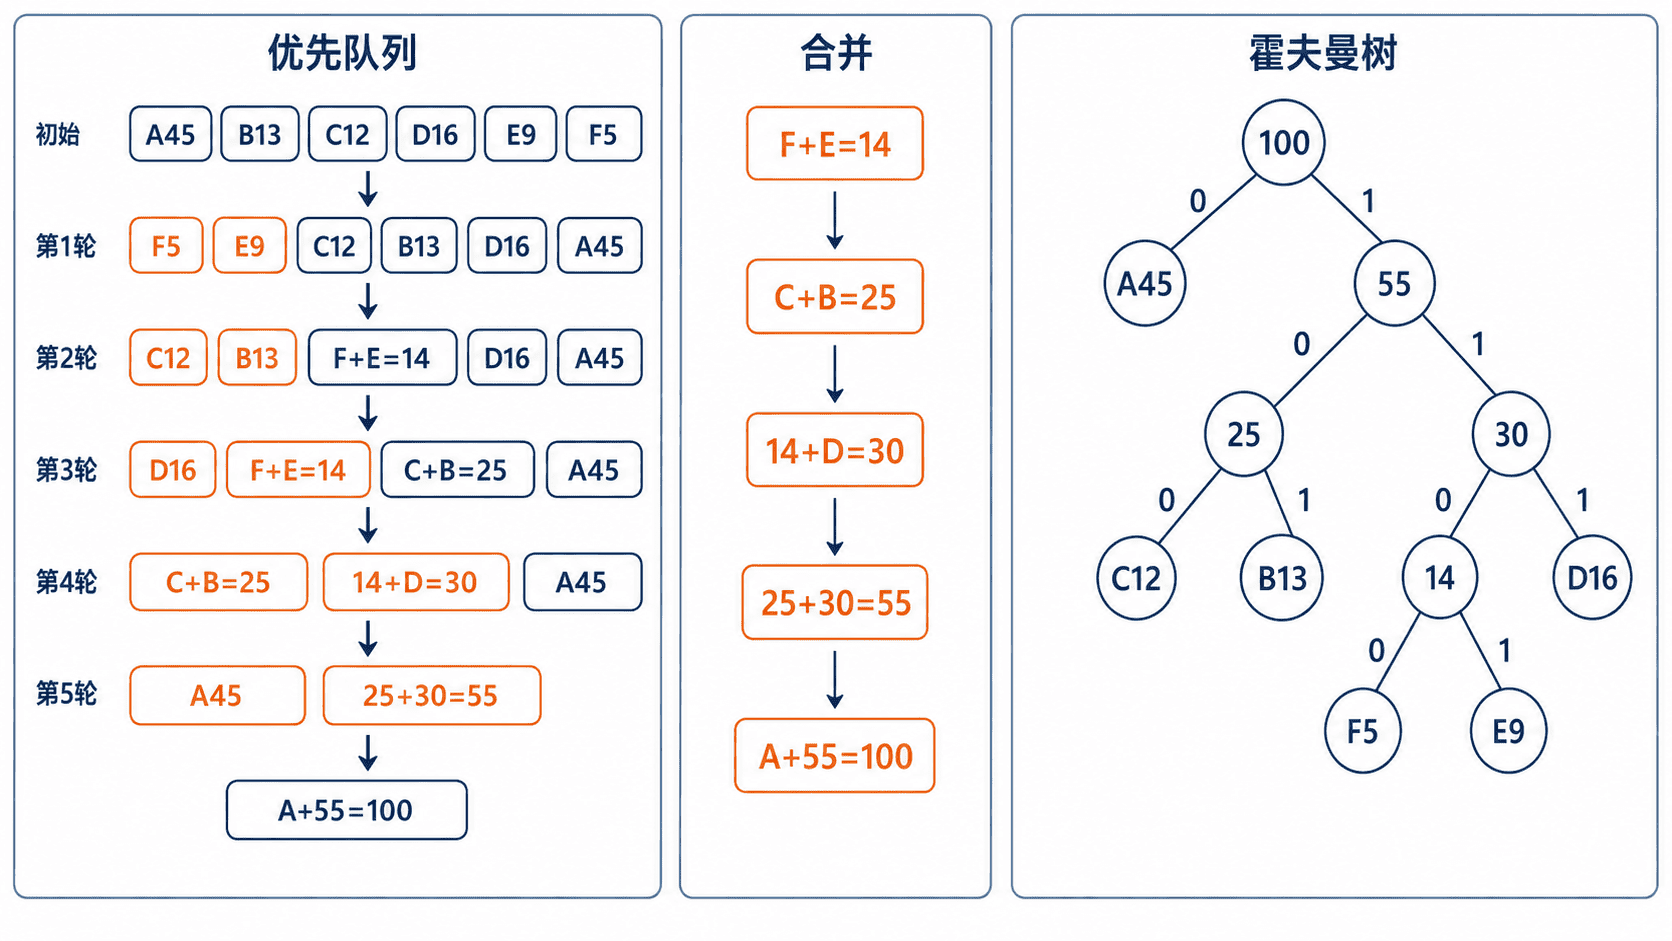
叶节点代表字符,根到叶路径上的左边记为 0、右边记为 1。任何字符编码都不会成为另一个字符编码的前缀,因此解码时可以从根开始逐位行走,到达叶节点后立即输出字符并回到根节点。
低频节点被安排在较深位置,高频节点更接近根。算法最小化的是加权路径长度:
其中 是字符频率, 是对应叶节点深度,也就是编码长度。
完整可运行示例
下面的 Java 17 程序使用 PriorityQueue 构造树,并使用 TreeMap 按字符顺序输出编码。将代码保存为 HuffmanCodingDemo.java。
java
import java.util.Arrays;
import java.util.Comparator;
import java.util.Map;
import java.util.PriorityQueue;
import java.util.TreeMap;

public class HuffmanCodingDemo {

    private static final class Node {
        final Character symbol;
        final int frequency;
        final Node left;
        final Node right;
        final String orderKey;

        Node(Character symbol, int frequency, Node left, Node right, String orderKey) {
            this.symbol = symbol;
            this.frequency = frequency;
            this.left = left;
            this.right = right;
            this.orderKey = orderKey;
        }

        boolean isLeaf() {
            return symbol != null;
        }
    }

    private static final Comparator<Node> NODE_ORDER =
            Comparator.comparingInt((Node node) -> node.frequency)
                    .thenComparing(node -> node.orderKey);

    public static void main(String[] args) {
        Map<Character, Integer> frequencies = new TreeMap<>();
        frequencies.put('A', 45);
        frequencies.put('B', 13);
        frequencies.put('C', 12);
        frequencies.put('D', 16);
        frequencies.put('E', 9);
        frequencies.put('F', 5);

        Node root = buildTree(frequencies);
        Map<Character, String> codes = new TreeMap<>();
        buildCodes(root, "", codes);

        System.out.println("霍夫曼编码:");
        codes.forEach((symbol, code) -> System.out.println(symbol + " -> " + code));

        String text = "FACE";
        String encoded = encode(text, codes);
        String decoded = decode(encoded, root);

        int weightedPathLength = frequencies.entrySet().stream()
                .mapToInt(entry -> entry.getValue() * codes.get(entry.getKey()).length())
                .sum();

        System.out.println("原文:" + text);
        System.out.println("编码:" + encoded);
        System.out.println("解码:" + decoded);
        System.out.println("加权路径长度:" + weightedPathLength);
    }

    private static Node buildTree(Map<Character, Integer> frequencies) {
        if (frequencies.isEmpty()) {
            throw new IllegalArgumentException("频率表不能为空");
        }

        PriorityQueue<Node> queue = new PriorityQueue<>(NODE_ORDER);
        frequencies.forEach((symbol, frequency) -> {
            if (frequency <= 0) {
                throw new IllegalArgumentException("字符频率必须大于 0");
            }
            queue.add(new Node(symbol, frequency, null, null, String.valueOf(symbol)));
        });

        while (queue.size() > 1) {
            Node left = queue.remove();
            Node right = queue.remove();
            queue.add(new Node(
                    null,
                    left.frequency + right.frequency,
                    left,
                    right,
                    mergeKey(left.orderKey, right.orderKey)
            ));
        }
        return queue.remove();
    }

    private static String mergeKey(String first, String second) {
        char[] chars = (first + second).toCharArray();
        Arrays.sort(chars);
        return new String(chars);
    }

    private static void buildCodes(Node node, String prefix, Map<Character, String> codes) {
        if (node.isLeaf()) {
            codes.put(node.symbol, prefix.isEmpty() ? "0" : prefix);
            return;
        }
        buildCodes(node.left, prefix + "0", codes);
        buildCodes(node.right, prefix + "1", codes);
    }

    private static String encode(String text, Map<Character, String> codes) {
        StringBuilder result = new StringBuilder();
        for (char symbol : text.toCharArray()) {
            String code = codes.get(symbol);
            if (code == null) {
                throw new IllegalArgumentException("编码表中不存在字符:" + symbol);
            }
            result.append(code);
        }
        return result.toString();
    }

    private static String decode(String bits, Node root) {
        if (root.isLeaf()) {
            return String.valueOf(root.symbol).repeat(bits.length());
        }

        StringBuilder result = new StringBuilder();
        Node current = root;

        for (char bit : bits.toCharArray()) {
            current = bit == '0' ? current.left : bit == '1' ? current.right : null;
            if (current == null) {
                throw new IllegalArgumentException("编码串包含非法路径");
            }
            if (current.isLeaf()) {
                result.append(current.symbol);
                current = root;
            }
        }

        if (current != root) {
            throw new IllegalArgumentException("编码串在字符边界前结束");
        }
        return result.toString();
    }
}
编译并运行:
bash
javac HuffmanCodingDemo.java
java HuffmanCodingDemo
预期输出
text
霍夫曼编码:
A -> 0
B -> 101
C -> 100
D -> 111
E -> 1101
F -> 1100
原文:FACE
编码:110001001101
解码:FACE
加权路径长度:224
复杂度与关键边界
若不同字符数为 ,建堆和连续合并的时间复杂度为 ,生成编码表需要访问整棵树,时间复杂度为 。编码长度为 的文本时,若编码表查询为常数时间,编码过程为 。
同一组频率可能存在多棵等价的最优霍夫曼树,因此具体比特串不一定唯一,但加权路径长度相同。工程实现还要处理空频率表、非正频率、待编码字符缺失、非法比特和编码串未在叶节点结束等情况。只有一个字符时,应显式给它分配如 0 的编码,避免产生空字符串。
本课总结
- 每轮合并两个最低频节点,是霍夫曼算法的核心贪心选择。
- 根到叶的比特路径天然形成前缀码,可按树结构无歧义解码。
- 编码结果可能不唯一,但最小加权路径长度这一最优性质保持不变。
下一课预告
后续将继续学习贪心算法的正确性证明与适用边界,重点判断局部最优选择能否安全地扩展为全局最优解。
按自己的节奏,确认真正理解。