
数据结构与算法 / 系统课时
扩容与再哈希
扩容与再哈希
上一节用开放寻址在同一个数组里查找空位。元素增多时,过多的连续占用槽会增加探测。扩容的任务是取得新槽位,并让每个有效键在新容量下重新可达。
学习目标
- 区分新增键和更新键,按插入后的有效元素数触发扩容。
- 在新表中完成定位与冲突处理,再切换表引用。
- 区分迁移次数、实际探测成本和摊还界。
哪些插入需要扩容
负载因子是 。本例只做插入和更新,最多使用容量的四分之三,阈值向下取整。容量 8 时可容纳 6 个有效键,准备加入第 7 个键时扩容。更新已有值不会增加元素数。支持墓碑删除的开放寻址表还应检查有效项加墓碑的占用,因为查询可能穿过墓碑。 开放寻址与重建资料
为什么不能保留旧下标
旧表与新表的起点分别由键对各自容量取模得出。容量变化后,起点或探测路径可能不同。迁移每条有效记录时,应从新起点按同样的冲突策略重新找槽;若旧表有墓碑,重建时只迁移有效记录。 开放寻址与重建资料
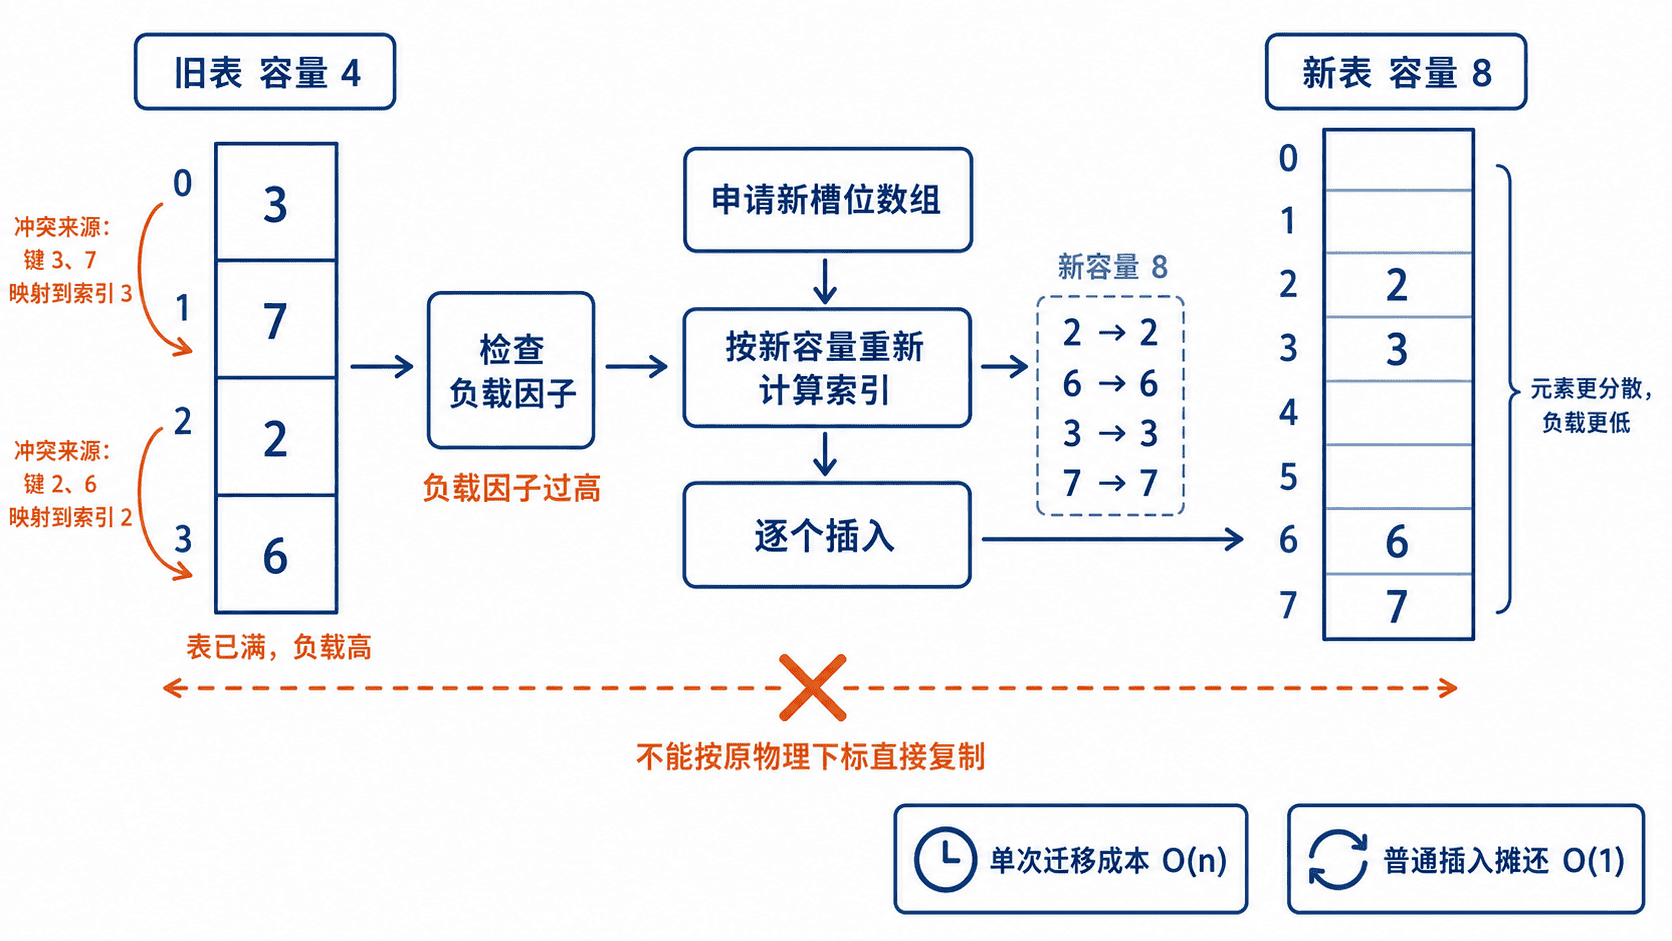
本例在局部变量中分配并填充新槽数组,把本次新增键也放进去后才替换表引用。迁移中若失败,旧槽及有效键数量仍然可用。这样描述的是单线程示例的提交边界,多线程或渐进迁移还需要明确读写与状态协调。
Python 3.11 可运行示例
保存为 rehash_demo.py。本例使用整数键,允许值为 None。槽中的 None 表示空槽,键值元组中的 None 则只是值。每次探测最多访问当前容量个位置。该实现没有删除接口。
class LinearProbingHashTable:
    def __init__(self, capacity: int = 4):
        if type(capacity) is not int or capacity < 2:
            raise ValueError("capacity must be an integer >= 2")
        self._slots = [None] * capacity
        self.size = 0
        self.resize_count = 0

    @property
    def capacity(self) -> int:
        return len(self._slots)

    @staticmethod
    def _locate(slots, key: int) -> int:
        if type(key) is not int:
            raise TypeError("expected an integer key")
        start = key % len(slots)
        for offset in range(len(slots)):
            index = (start + offset) % len(slots)
            entry = slots[index]
            if entry is None or entry[0] == key:
                return index
        raise RuntimeError("no free slot")

    def put(self, key: int, value) -> None:
        index = self._locate(self._slots, key)
        if self._slots[index] is not None:
            self._slots[index] = (key, value)
            return

        if self.size + 1 > (3 * self.capacity) // 4:
            new_slots = [None] * (2 * self.capacity)
            for entry in self._slots:
                if entry is not None:
                    new_slots[self._locate(new_slots, entry[0])] = entry
            new_slots[self._locate(new_slots, key)] = (key, value)
            self._slots = new_slots
            self.resize_count += 1
        else:
            self._slots[index] = (key, value)
        self.size += 1

    def get(self, key: int):
        entry = self._slots[self._locate(self._slots, key)]
        if entry is None:
            raise KeyError(key)
        return entry[1]


if __name__ == "__main__":
    table = LinearProbingHashTable()
    for key, value in [(1, "A"), (5, "B"), (9, "C")]:
        table.put(key, value)
    table.put(9, "updated")
    print("after update:", table.capacity, table.size, table.resize_count)
    table.put(13, None)
    print("after new key:", table.capacity, table.size, table.resize_count)
print("values:", [table.get(key) for key in (1, 5, 9, 13)])after update: 4 3 0
after new key: 8 4 1
values: ['A', 'B', 'updated', None]成本要算上探测
扩容时须扫描旧数组、初始化新数组并迁移有效项。本例达到阈值时,容量与有效项数量同阶。在哈希分布使每次探测的期望成本为常数时,重建的期望时间为线性。倍增策略使一连串新增键的迁移量可用几何级数求和,因此能得到期望摊还常数。若所有键从同一槽开始探测,重建时可能需要 次探测,即平方量级。容量倍增本身只约束迁移次数,无法消除这种探测代价。扩容期间新旧槽位同时占用内存。 开放寻址的期望复杂度
本课练习
把初始容量设为 8,加入前 6 个新键后更新其中一个,验证容量不变。加入第 7 个键后检查各键与值是否可达。下一课观察相同负载下哈希策略如何改变查找成本。