
数据结构与算法 / 系统课时
并查集基础
并查集基础
并查集用于维护一组不断合并的集合,并快速判断两个元素是否属于同一组。本课从父节点数组出发,实现查找代表元、合并集合和判断连通性,并通过路径压缩与按大小合并优化性能,最终完成一个可运行的 Java 并查集。
学习目标
- 理解代表元、父节点数组和集合合并之间的关系。
- 掌握
find、union和connected的完整实现。 - 能解释路径压缩与按大小合并的作用、复杂度和适用边界。
核心原理
初始化时,每个元素单独构成一个集合,并让 parent[i] = i。同一集合中的元素通过父节点指针形成一棵树,根节点作为集合的代表元,满足 parent[root] == root。不同集合的树彼此独立。
find(x) 沿父节点指针向上查找根,union(a, b) 找到两个元素的根后,将其中一个根连接到另一个根。判断两个元素是否属于同一集合,只需比较它们的代表元。
| 操作 | 关键动作 | 返回或效果 |
|---|---|---|
find(x) |
沿父节点查找根并压缩路径 | 返回元素所在集合的代表元 |
union(a, b) |
找到两个根并按集合大小连接 | 合并成功返回 true,原本同组返回 false |
connected(a, b) |
比较两个元素的代表元 | 返回是否属于同一集合 |
如果合并时总是随意连接两个根,树可能退化成长链,导致一次查找需要访问大量节点。为避免这种情况,通常同时使用两项优化:
- 路径压缩:执行
find时,将查找路径上的节点直接连接到根,缩短后续查找路径。 - 按大小合并:使用
size[root]记录根节点对应的集合规模,始终把较小集合的根挂到较大集合的根下面,限制树高。
两项优化解决不同问题:按大小合并限制树的增长高度,路径压缩则在查找过程中进一步缩短已有路径。它们可以组合使用,而不会改变集合的连通关系。
合并与路径压缩的执行过程
以元素 0 到 6 为例,最初存在 7 个独立集合。执行 union(0, 1)、union(1, 2) 和 union(3, 4) 后,得到两个多元素集合 {0, 1, 2} 和 {3, 4},另有单独的 {5}、{6}。
此时第一个集合的根为 0,大小为 3;第二个集合的根为 3,大小为 2。执行 union(2, 4) 时,先通过 find 得到两个根 0 和 3,再把较小集合的根 3 挂到 0 下面。元素 4 暂时仍指向 3。
随后执行 find(4),查找路径是 4 → 3 → 0。路径压缩会把 parent[4] 直接改为 0,但代表元仍然是 0,集合中的成员也没有改变。
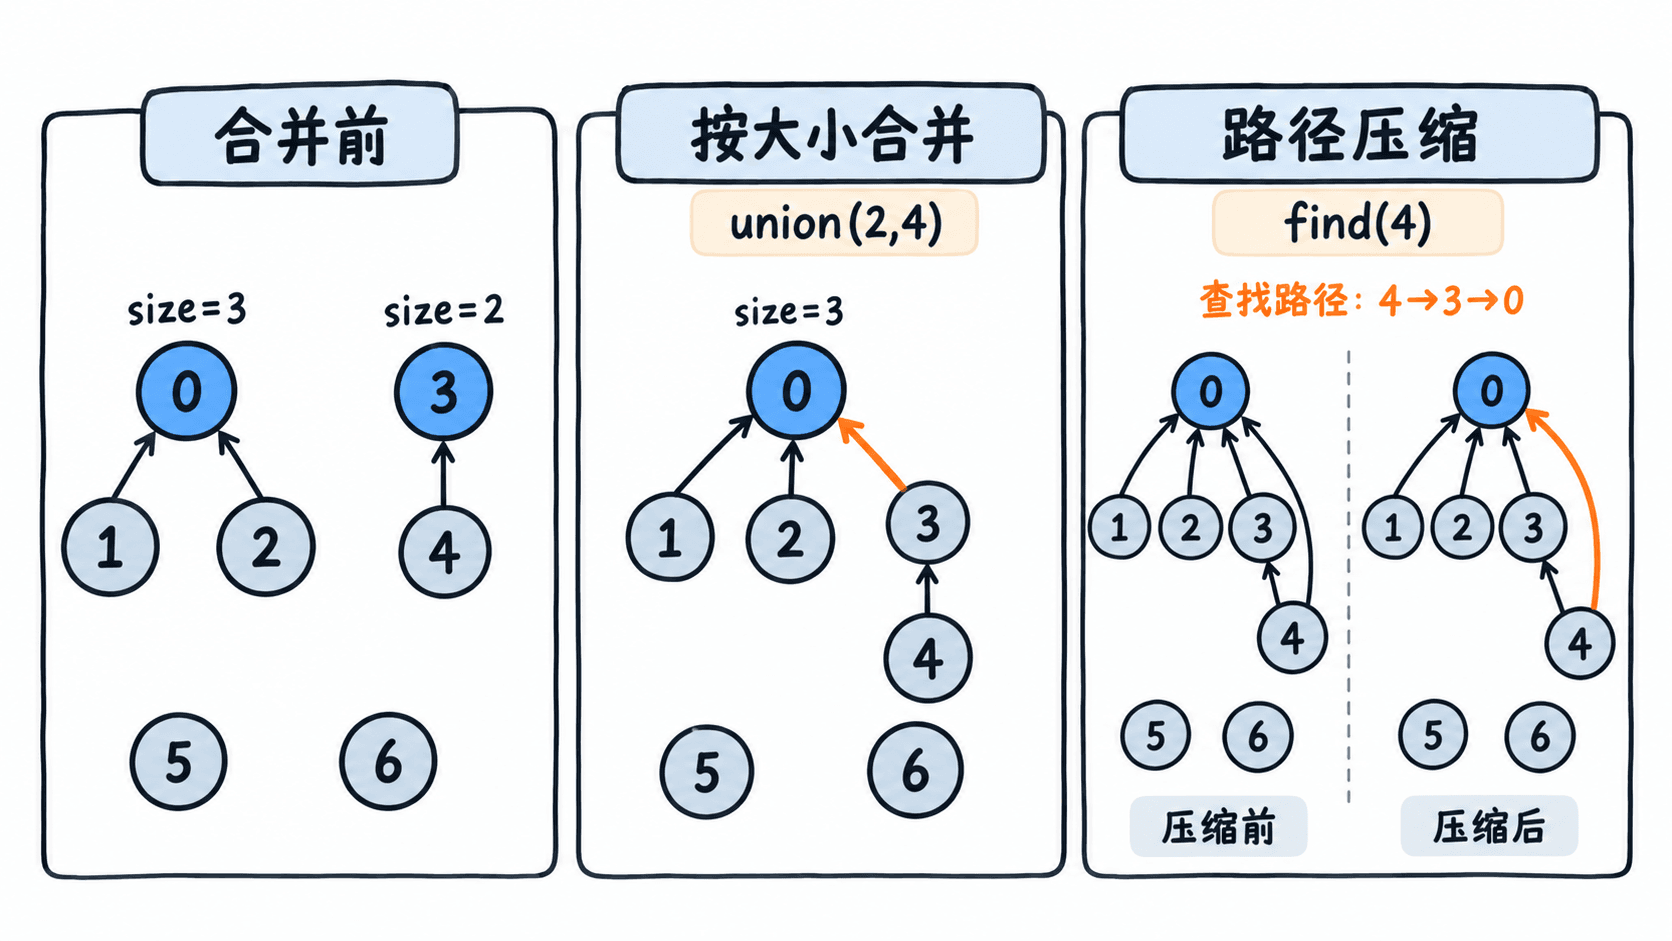
合并后的大集合包含 5 个元素,但当前仍有 {5} 和 {6} 两个独立集合,因此总集合数量从 7 减少到 3。路径压缩只调整树的形状,不会减少集合数量。
完整可运行示例
下面使用 Java 17 实现并查集。parent 保存父节点,size 保存根节点对应集合的元素数量,components 记录当前集合个数。find 采用两次遍历:先定位根,再压缩路径,避免递归查找在极端深链上产生调用栈问题。
import java.util.Arrays;

public class UnionFindDemo {

    static class UnionFind {
        private final int[] parent;
        private final int[] size;
        private int components;

        public UnionFind(int elementCount) {
            if (elementCount <= 0) {
                throw new IllegalArgumentException("元素数量必须大于 0");
            }

            parent = new int[elementCount];
            size = new int[elementCount];
            components = elementCount;

            for (int i = 0; i < elementCount; i++) {
                parent[i] = i;
                size[i] = 1;
            }
        }

        public int find(int element) {
            checkElement(element);

            // 先沿父节点指针找到当前集合的根。
            int root = element;
            while (root != parent[root]) {
                root = parent[root];
            }

            // 将原查找路径上的节点直接连接到根。
            while (element != root) {
                int next = parent[element];
                parent[element] = root;
                element = next;
            }
            return root;
        }

        public boolean union(int first, int second) {
            int firstRoot = find(first);
            int secondRoot = find(second);

            // 重复合并不会改变集合数量。
            if (firstRoot == secondRoot) {
                return false;
            }

            // 始终把较小集合的根挂到较大集合的根下面。
            if (size[firstRoot] < size[secondRoot]) {
                int temporary = firstRoot;
                firstRoot = secondRoot;
                secondRoot = temporary;
            }

            parent[secondRoot] = firstRoot;
            size[firstRoot] += size[secondRoot];
            components--;
            return true;
        }

        public boolean connected(int first, int second) {
            return find(first) == find(second);
        }

        public int componentCount() {
            return components;
        }

        public String parentSnapshot() {
            return Arrays.toString(parent);
        }

        private void checkElement(int element) {
            if (element < 0 || element >= parent.length) {
                throw new IndexOutOfBoundsException("元素下标越界: " + element);
            }
        }
    }

    public static void main(String[] args) {
        UnionFind unionFind = new UnionFind(7);

        unionFind.union(0, 1);
        unionFind.union(1, 2);
        unionFind.union(3, 4);
        unionFind.union(2, 4);

        System.out.println("0 与 4 连通: " + unionFind.connected(0, 4));
        System.out.println("0 与 6 连通: " + unionFind.connected(0, 6));
        System.out.println("4 的代表元: " + unionFind.find(4));
        System.out.println("父节点数组: " + unionFind.parentSnapshot());
        System.out.println("集合数量: " + unionFind.componentCount());
    }
}
将代码保存为 UnionFindDemo.java。确认已经安装 JDK 17 或更新版本,并在文件所在目录执行以下命令:
javac UnionFindDemo.java
java UnionFindDemo
预期输出:
0 与 4 连通: true
0 与 6 连通: false
4 的代表元: 0
父节点数组: [0, 0, 0, 0, 0, 5, 6]
集合数量: 3
输出表明,元素 0 到 4 已经属于同一集合,5 和 6 仍各自独立。父节点数组中,前五个元素都直接指向根 0,这是合并与后续查找共同作用的结果。
可以在四次合并后再调用一次 unionFind.union(0, 4)。预期返回 false,且 componentCount() 仍为 3,说明对同一集合内的元素重复执行合并不会错误地减少集合数量。
复杂度与使用边界
设并查集包含 个元素。初始化父节点和大小数组需要 时间与 空间。若不进行任何优化,父节点关系可能退化成长度为 的链,导致单次 find 和 union 的最坏时间复杂度达到 。
仅使用按大小合并时,树高最多为 。同时使用路径压缩与按大小合并后,连续 次查找或合并操作的总时间通常记为 ,即每次操作的均摊时间为 。其中 是反阿克曼函数,在实际数据规模下增长极慢,因此通常将其视为接近常数的均摊性能,而不是严格的单次最坏 。
使用时还要注意三个边界:
- 重复合并:
union必须先比较两个根。若代表元相同,应返回false,不能再次减少components。 - 根与集合大小:合并后,只有当前根节点对应的
size[root]才表示整个集合的大小;旧根的size可能保留过时数值。需要查询集合大小时,应先执行find(x)再读取size[root]。 - 元素范围与代表元:本实现只接受
0到n - 1的整数下标,非法下标会抛出异常。代表元只用于标识当前集合,后续合并可能改变它,不能将其长期当作固定业务 ID。
并查集适合处理只发生集合合并的动态连通问题,例如判断无向图中两个顶点是否连通、在 Kruskal 最小生成树算法中检测成环,以及合并具有共同标识的账户。若业务要求删除连接或将一个集合重新拆分,普通并查集无法直接完成,需要使用支持动态连通或其他专门操作的数据结构。