
数据结构与算法 / 系统课时
最大堆与最小堆
最大堆与最小堆
堆在完全二叉树的结构上增加局部顺序约束,使堆顶始终保存最大值或最小值。本课将对比两类堆的性质、复杂度与典型用途,并用可运行代码验证核心接口。
学习目标
- 区分最大堆与最小堆的堆序性质。
- 理解查看堆顶、插入、删除堆顶和建堆的复杂度。
- 能根据业务目标选择合适的堆类型。
核心原理
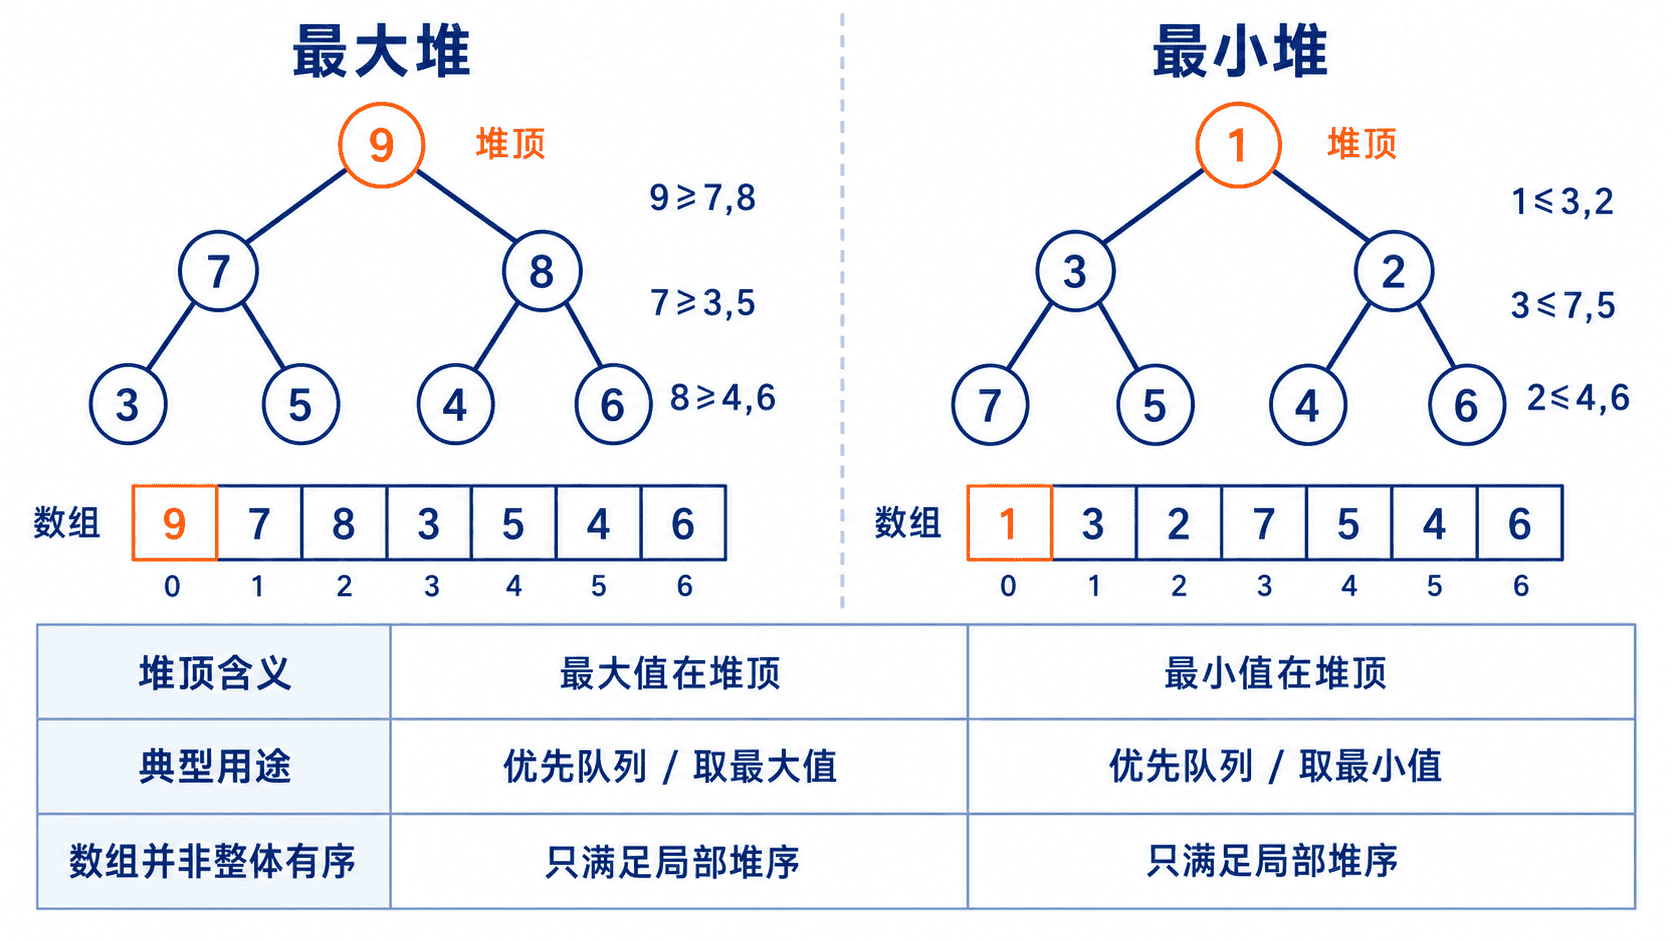
最大堆要求每个父节点都不小于它的孩子,因此根节点是全局最大值;最小堆要求每个父节点都不大于它的孩子,因此根节点是全局最小值。堆序只约束父子关系,不保证兄弟节点之间有序,也不保证数组整体有序。
| 操作 | 最大堆结果 | 最小堆结果 | 时间复杂度 |
|---|---|---|---|
| 查看堆顶 | 当前最大值 | 当前最小值 | O(1) |
| 插入元素 | 上浮恢复堆序 | 上浮恢复堆序 | O(log n) |
| 删除堆顶 | 末元素移到根后下沉 | 末元素移到根后下沉 | O(log n) |
| 批量建堆 | 自底向上下沉 | 自底向上下沉 | O(n) |
最大堆适合反复取得最高优先级、前 K 大元素等场景;最小堆适合任务调度、最短候选边、前 K 大元素中的当前门槛等场景。选择标准不是数据名称,而是“每次最先取出哪个极值”。
完整可运行示例
Python 标准库 heapq 实现最小堆。对数值取相反数,可以用同一接口模拟最大堆。将代码保存为 heap_demo.py 后运行。
python
import heapq

numbers = [7, 2, 9, 4, 1]

min_heap = numbers.copy()
# heapq 原地把列表调整为最小堆。
heapq.heapify(min_heap)

# 对数值取相反数来复用最小堆接口。
max_heap = [-value for value in numbers]
heapq.heapify(max_heap)

print("最小堆堆顶:", min_heap[0])
print("最大堆堆顶:", -max_heap[0])

heapq.heappush(min_heap, 0)
print("插入 0 后最小堆堆顶:", min_heap[0])

min_order = [heapq.heappop(min_heap) for _ in range(len(min_heap))]
max_order = [-heapq.heappop(max_heap) for _ in range(len(max_heap))]

print("最小堆依次出队:", min_order)
print("最大堆依次出队:", max_order)
运行命令:
bash
python heap_demo.py预期输出
text
最小堆堆顶: 1
最大堆堆顶: 9
插入 0 后最小堆堆顶: 0
最小堆依次出队: [0, 1, 2, 4, 7, 9]
最大堆依次出队: [9, 7, 4, 2, 1]
常见错误
不要把堆数组误认为已排序数组。最大堆只保证根节点最大,数组中相邻元素未必按降序排列;需要完整有序结果时,必须连续删除堆顶或使用排序算法。
使用相反数模拟最大堆时,入堆和出堆都要转换符号。若对象不是纯数值,应使用包含优先级的元组,并明确处理优先级相同的情况,避免对象之间发生不可比较错误。
本课练习
- 将示例改为持续插入
6、3、10,每次输出最大堆堆顶,并验证堆顶始终是当前最大值。 - 使用最小堆维护数据流中最大的
3个数:堆大小超过3时删除堆顶,最终验收结果应包含三个最大元素,但不要求堆数组本身有序。
本课总结
- 最大堆和最小堆都基于完全二叉树,只是父子比较方向相反。
- 堆顶访问为
O(1),插入和删除堆顶通常为O(log n),批量建堆为O(n)。 - 堆提供快速极值访问,但不等同于完整排序。
下一课预告
下一阶段将继续学习堆的上浮、下沉与优先队列实现,重点理解每次结构调整为何只沿一条根到叶路径进行。
按自己的节奏,确认真正理解。