
数据结构与算法 / 系统课时
Trie 树
Trie 树
Trie 树把字符串拆成逐字符路径,让拥有相同前缀的单词共享节点。它能够按查询串长度完成插入、完整单词查询和前缀查询。本课将实现一个仅接收小写英文字母的可运行 Trie,并明确单词结束标记的作用。
学习目标
- 理解 Trie 节点、字符边和公共前缀共享机制。
- 区分完整查询
search与前缀查询startsWith。 - 能够实现插入、查询和输入边界校验。
结构与存储方式
Trie 的根节点不代表字符。从根开始,每条边对应一个字符;沿路径读取字符即可还原前缀或单词。多个单词共享相同前缀,因此 app、apple 和 apply 会共用 a → p → p 这段路径。
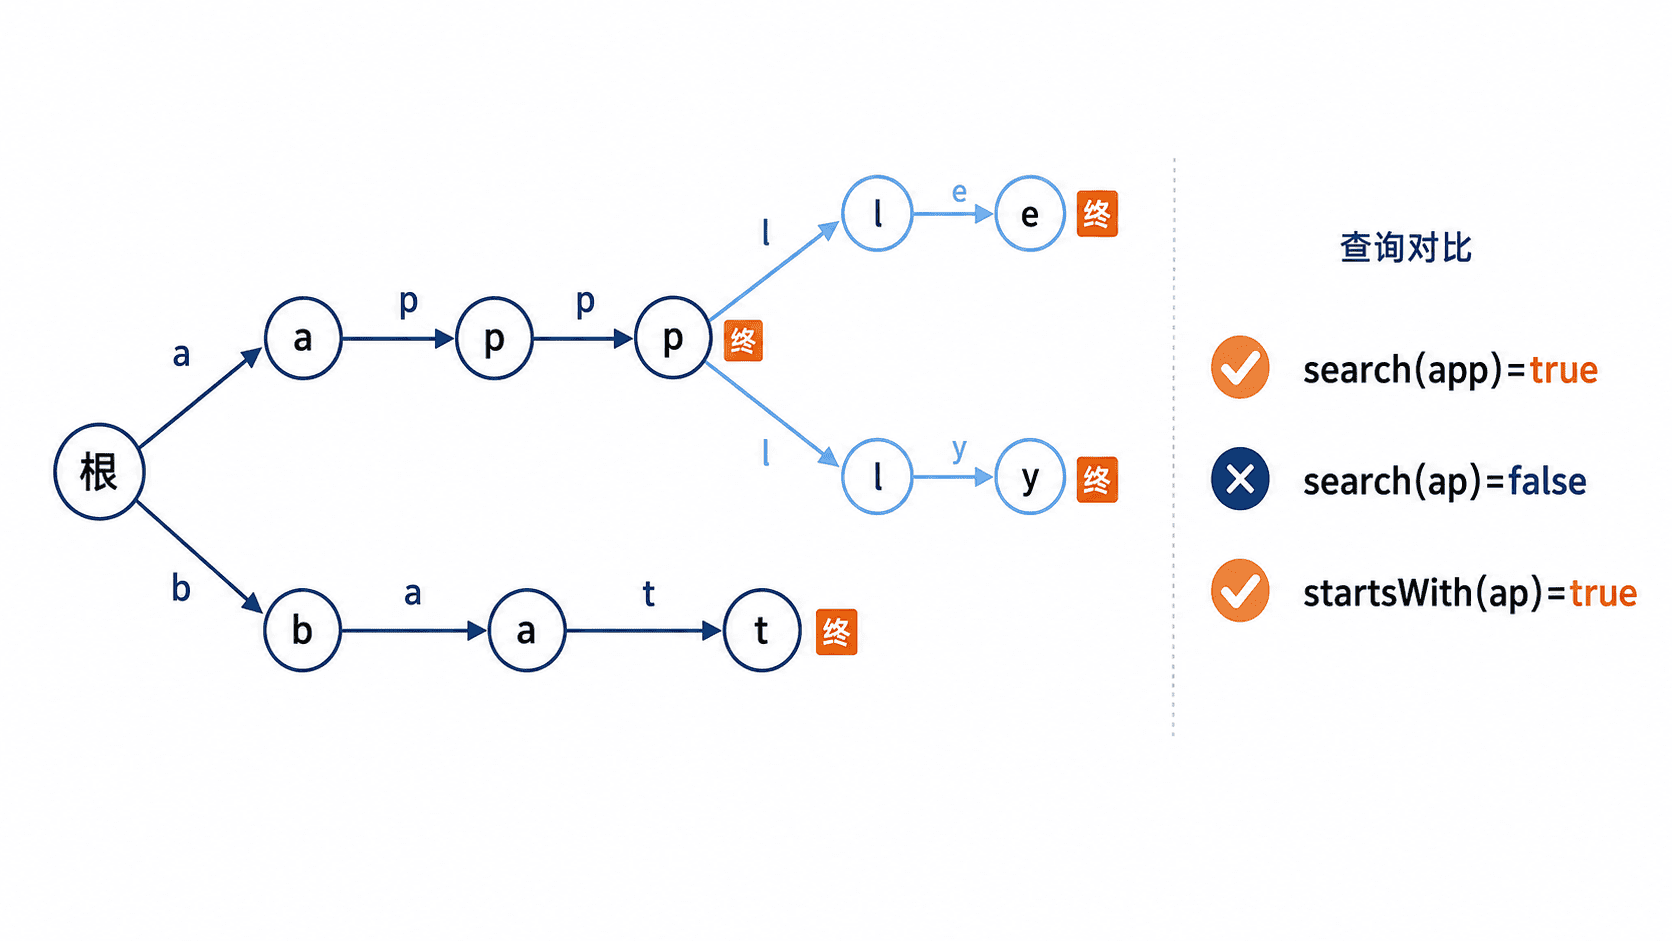
节点必须额外保存 wordEnd。仅仅能够走完路径,只能证明该字符串是某个已插入单词的前缀;只有末节点的 wordEnd 为 true,才能证明完整单词存在。
三个核心操作
插入
从根节点依次处理字符。对应子节点不存在时创建节点,存在时复用节点。处理完最后一个字符后,把当前节点标记为单词结束。
完整查询
沿字符路径查找目标单词。路径缺失时返回 false;路径存在但末节点未标记结束时也返回 false。例如插入 apple 后,search("app") 仍为 false,除非 app 也被单独插入。
前缀查询
前缀查询只要求路径存在,不检查末节点的 wordEnd。因此插入 apple 后,startsWith("app") 为 true。
完整可运行示例
下面使用长度为 26 的子节点数组保存 a 到 z。这种实现访问速度稳定,但输入范围固定。将代码保存为 TrieDemo.java。
public class TrieDemo {

    private static class TrieNode {
        private final TrieNode[] children = new TrieNode[26];
        private boolean wordEnd;
    }

    private final TrieNode root = new TrieNode();

    public void insert(String word) {
        TrieNode current = root;

        for (char ch : word.toCharArray()) {
            int index = toIndex(ch);
            if (current.children[index] == null) {
                current.children[index] = new TrieNode();
            }
            current = current.children[index];
        }

        // 只有完整单词的最后一个节点才标记结束。
        current.wordEnd = true;
    }

    public boolean search(String word) {
        TrieNode node = findNode(word);
        return node != null && node.wordEnd;
    }

    public boolean startsWith(String prefix) {
        return findNode(prefix) != null;
    }

    private TrieNode findNode(String text) {
        TrieNode current = root;

        for (char ch : text.toCharArray()) {
            int index = toIndex(ch);
            current = current.children[index];
            if (current == null) {
                return null;
            }
        }

        return current;
    }

    private static int toIndex(char ch) {
        if (ch < 'a' || ch > 'z') {
            throw new IllegalArgumentException("只支持小写英文字母: " + ch);
        }
        return ch - 'a';
    }

    public static void main(String[] args) {
        TrieDemo trie = new TrieDemo();
        trie.insert("apple");
        trie.insert("app");
        trie.insert("apply");
        trie.insert("bat");

        System.out.println("search(app): " + trie.search("app"));
        System.out.println("search(ap): " + trie.search("ap"));
        System.out.println("startsWith(ap): " + trie.startsWith("ap"));
        System.out.println("startsWith(cat): " + trie.startsWith("cat"));
    }
}
编译并运行:
javac TrieDemo.java
java TrieDemo
预期输出
search(app): true
search(ap): false
startsWith(ap): true
startsWith(cat): false
复杂度与工程边界
设待处理字符串长度为 L,插入、完整查询和前缀查询的时间复杂度均为 O(L)。复杂度与 Trie 中已存单词总数没有直接线性关系,但节点数量可能接近所有字符数之和。
数组子节点适合字符集固定且较小的场景;若需要中文、符号或稀疏字符集,可把 TrieNode[] 改为 Map<Integer, TrieNode>,并按 Unicode 码点遍历。删除操作还需要判断节点是否被其他单词共享,不能直接切断整条路径。
常见错误
- 不设置
wordEnd:会把所有前缀误判为完整单词。 search与startsWith使用同一返回条件:完整查询必须额外检查结束标记。- 字符下标未校验:
ch - 'a'对大写字母或符号可能越界,示例通过toIndex明确拒绝非法字符。 - 每次插入都覆盖已有子节点:这会破坏共享前缀,应只在子节点为空时创建新节点。
本课练习
- 插入
car、card、care和dog,验证search("car")、search("ca")与startsWith("ca")的结果。 - 增加
countPrefix(String prefix),返回具有指定前缀的单词数量;要求在节点中维护经过次数或子树单词数。 - 实现删除操作:删除一个存在的单词后保留仍被其他单词使用的公共节点,并给出删除前后的查询验收结果。
本课总结
- Trie 通过共享字符前缀降低重复存储,并按字符串长度完成查询。
wordEnd是区分完整单词与普通前缀的关键状态。- 子节点容器应根据字符集大小和稀疏程度选择数组或映射。
下一课预告
接下来可继续学习字符串多模式匹配、自动补全与词典检索,把 Trie 的前缀结构扩展为更完整的字符串处理工具。