
数据结构与算法 / 系统课时
基准测试与性能剖析
基准测试与性能剖析
一次 System.nanoTime() 的差值很容易受到 JVM 预热、即时编译、垃圾回收和系统负载影响。本课使用 JMH 构造可重复的排序基准,通过预热、分叉、重复测量和分配剖析建立可靠的性能优化闭环。
学习目标
- 能控制输入规模、数据分布、预热、测量轮次和运行环境。
- 能读取平均耗时、误差范围及每次操作分配字节数。
- 能根据剖析结果定位热点,并通过复测验证优化是否真实有效。
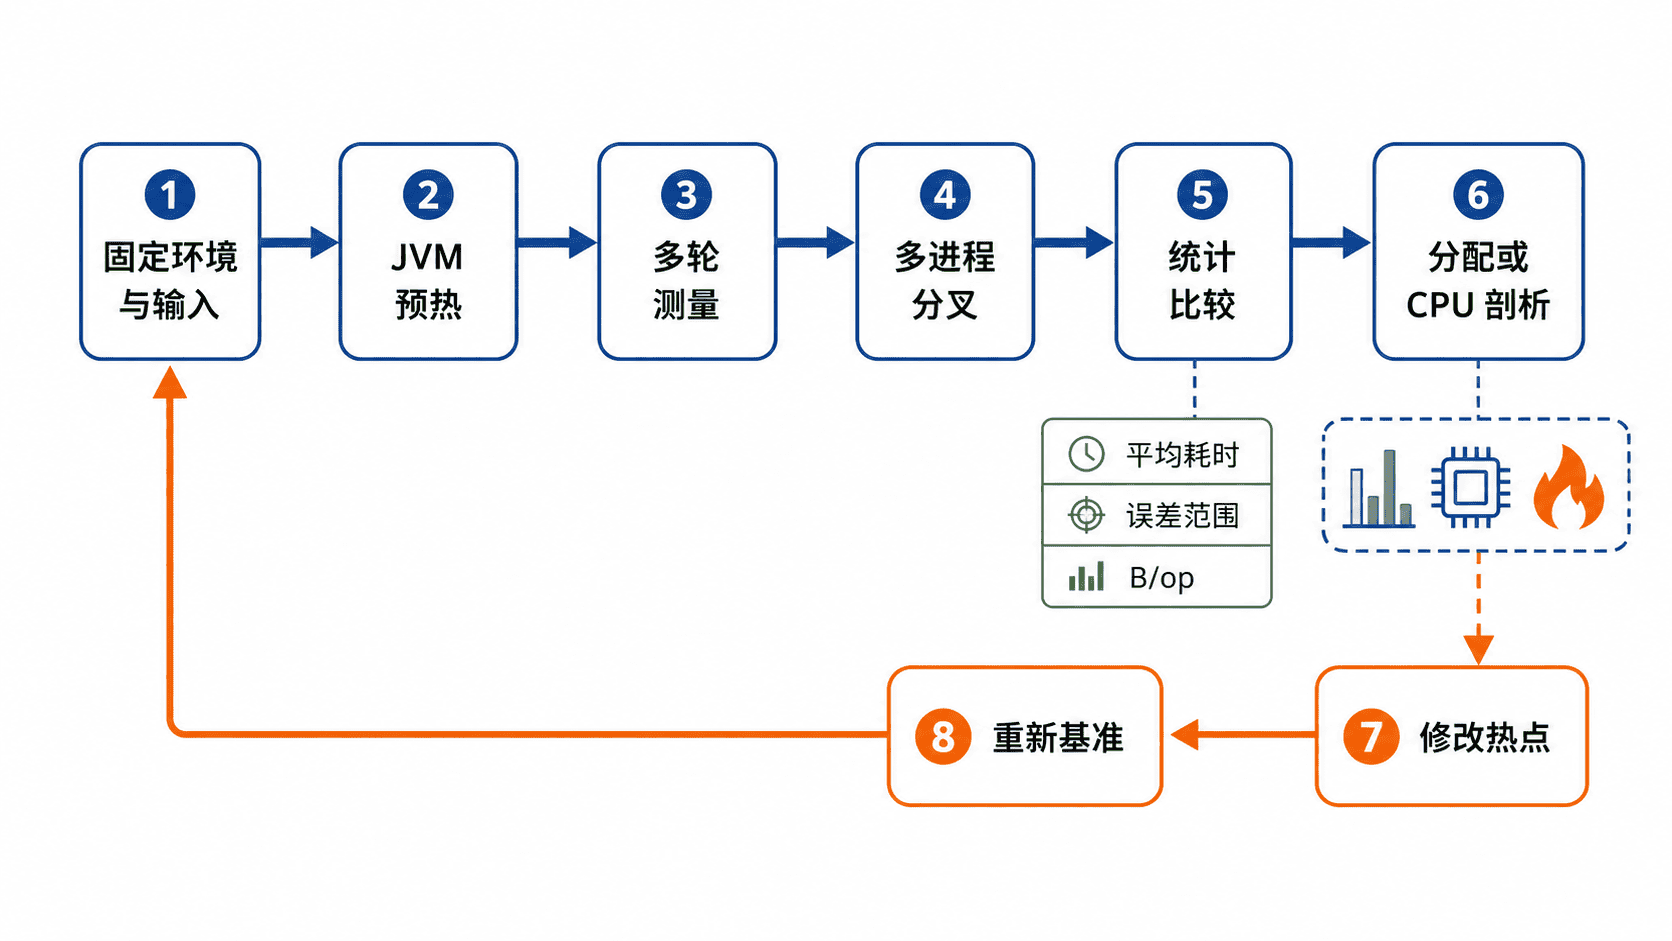
公平基准的测量流程
可靠基准不是“运行一次并记录最快值”,而是固定变量、重复采样并报告波动。待比较实现必须完成相同任务、使用相同输入分布、返回可观察结果,并在同一机器和同一 JDK 上运行。
| 控制项 | 作用 | 本课设置 |
|---|---|---|
| 输入规模 | 观察增长趋势 | 100 与 1000 个整数 |
| 输入分布 | 防止样本偏差 | 固定种子的伪随机整数 |
| 预热 | 让热点代码完成即时编译 | 3 轮,每轮 1 秒 |
| 正式测量 | 获取稳定样本 | 5 轮,每轮 1 秒 |
| 分叉 | 隔离单个 JVM 状态 | 2 个独立 JVM |
| 结果消费 | 防止无用代码被消除 | 基准方法返回排序后的数组 |
以下示例使用 JMH 1.37。JMH 官方推荐通过独立 Maven 项目生成正确的构建配置,构建可执行基准 JAR 后再从命令行运行。:contentReference[oaicite:0]{index=0}
完整可运行示例
先使用 Maven Archetype 创建项目。命令需要本机已经安装 JDK 17 和 Maven:
mvn archetype:generate -DinteractiveMode=false -DarchetypeGroupId=org.openjdk.jmh -DarchetypeArtifactId=jmh-java-benchmark-archetype -DarchetypeVersion=1.37 -DgroupId=org.example -DartifactId=algorithm-benchmark -Dversion=1.0预期结果是当前目录生成 algorithm-benchmark 项目,并包含可构建的 pom.xml、基准源码目录和 JMH 依赖配置。
删除生成的 MyBenchmark.java,将下面代码保存为 algorithm-benchmark/src/main/java/org/example/SortBenchmark.java:
package org.example;

import java.util.Arrays;
import java.util.Random;
import java.util.concurrent.TimeUnit;
import org.openjdk.jmh.annotations.Benchmark;
import org.openjdk.jmh.annotations.BenchmarkMode;
import org.openjdk.jmh.annotations.Fork;
import org.openjdk.jmh.annotations.Level;
import org.openjdk.jmh.annotations.Measurement;
import org.openjdk.jmh.annotations.Mode;
import org.openjdk.jmh.annotations.OutputTimeUnit;
import org.openjdk.jmh.annotations.Param;
import org.openjdk.jmh.annotations.Scope;
import org.openjdk.jmh.annotations.Setup;
import org.openjdk.jmh.annotations.State;
import org.openjdk.jmh.annotations.Warmup;

@BenchmarkMode(Mode.AverageTime)
@OutputTimeUnit(TimeUnit.MICROSECONDS)
@Warmup(iterations = 3, time = 1)
@Measurement(iterations = 5, time = 1)
@Fork(2)
@State(Scope.Thread)
public class SortBenchmark {

    @Param({"100", "1000"})
    public int size;

    private int[] source;

    @Setup(Level.Trial)
    public void setUp() {
        // 固定种子使不同实现接收同一分布的可复现输入。
        source = new Random(42L)
                .ints(size, -100_000, 100_000)
                .toArray();
    }

    @Benchmark
    public int[] arraysSort() {
        // 两个基准都包含克隆成本,保证被测工作范围一致。
        int[] copy = source.clone();
        Arrays.sort(copy);
        return copy;
    }

    @Benchmark
    public int[] insertionSort() {
        int[] copy = source.clone();
        insertionSortInPlace(copy);
        return copy;
    }

    private static void insertionSortInPlace(int[] data) {
        for (int i = 1; i < data.length; i++) {
            int value = data[i];
            int j = i - 1;

            while (j >= 0 && data[j] > value) {
                data[j + 1] = data[j];
                j--;
            }

            data[j + 1] = value;
        }
    }
}
进入项目目录,构建可执行 JAR,并启用 JMH 的 gc 剖析器测量每次操作的内存分配:
cd algorithm-benchmark
mvn clean verify
java -jar target/benchmarks.jar SortBenchmark -prof gc
预期输出
耗时和误差会随 CPU、JDK、系统负载变化,因此下面用占位符表示动态值;实际结果应包含两个输入规模、两个算法以及 gc.alloc.rate.norm 指标。
Benchmark                                   (size)  Mode  Cnt    Score     Error   Units
SortBenchmark.arraysSort                       100  avgt   10   <TIME> ±   <ERR>   us/op
SortBenchmark.arraysSort                      1000  avgt   10   <TIME> ±   <ERR>   us/op
SortBenchmark.insertionSort                    100  avgt   10   <TIME> ±   <ERR>   us/op
SortBenchmark.insertionSort                   1000  avgt   10   <TIME> ±   <ERR>   us/op
SortBenchmark.arraysSort:gc.alloc.rate.norm    100  avgt   10  <BYTES> ±   <ERR>    B/op
SortBenchmark.insertionSort:gc.alloc.rate.norm 100 avgt 10 <BYTES> ± <ERR> B/op平均耗时模式中,Score 越低表示单次操作越快,Error 表示测量不确定性。只有差异明显大于噪声并且多次复测方向一致时,才应认定存在性能差异。gc.alloc.rate.norm 较高说明每次操作分配更多内存,可继续检查数组复制、临时对象或装箱行为;CPU 热点则应在同一代表性负载上继续使用 JFR 或采样型分析器确认。
常见错误与练习
常见错误
- 在 IDE 调试模式中运行基准,会引入调试器、后台索引和不受控 JVM 参数。
- 不做预热或只测一次,会把类加载、即时编译和偶发调度误认为算法成本。
- 两个基准使用不同输入或完成不同工作,得到的数字没有可比性。
- 忽略返回值可能触发无用代码消除;本例返回结果数组,让 JMH 消费计算结果。
- 只看最快一轮或只比较绝对数字,会掩盖误差范围、机器差异和复杂度增长趋势。
本课练习
- 在同一基准类中增加冒泡排序,保持输入、克隆、预热、测量和分叉设置不变;验收条件是结果同时包含 3 个算法和 2 个规模,且能够解释规模增大后耗时增长的差异。
- 把规模扩展为
100、1000、5000,分别记录平均耗时与B/op;验收条件是使用同一机器连续运行 3 次,并区分稳定趋势与落在误差范围内的波动。
本课总结
- 公平基准必须控制输入、环境和被测工作范围,并通过预热、重复测量与分叉降低偶然性。
- 性能结论应同时观察得分、误差、规模趋势和资源分配,而不是依赖单个最快值。
- 剖析负责回答时间和内存消耗在哪里,修改后必须回到同一基准再次验证。
下一课预告
接下来可以把正确性测试与基准测试接入持续集成,在代码变更后自动执行回归验证、保存性能基线,并对明显退化进行告警。