
数据结构与算法 / 系统课时
调用栈与递归成本
调用栈与递归成本
递归代码通常很短,但每次函数调用都要在调用栈中保存独立状态。本课通过递归求和统计调用次数和最大栈深度,并据此区分运行时间、递归深度与辅助空间复杂度,理解递归和循环实现的成本差异。
学习目标
- 解释递归调用如何创建、保留和释放栈帧。
- 根据最大递归深度判断辅助空间复杂度。
- 比较线性递归与循环实现的时间、空间成本。
调用栈如何增长与回退
从调用模型看,每个尚未完成的调用都有一份逻辑帧,保存参数、局部状态和后续执行位置。解释器与编译器对物理栈和帧对象的实现可能不同。当前调用必须等待更深一层返回,因此这些栈帧会同时保留;当基本情况返回后,栈帧才按后进先出的顺序逐个释放。
以 recursive_sum(3) 为例,递归调用依次传入 3、2、1、0。到达基本情况时,已有四层调用尚未完成,递归栈深度达到最大值 4。随后最内层返回 0,外层依次计算 1 + 0 = 1、2 + 1 = 3、3 + 3 = 6,对应栈帧逐层释放。
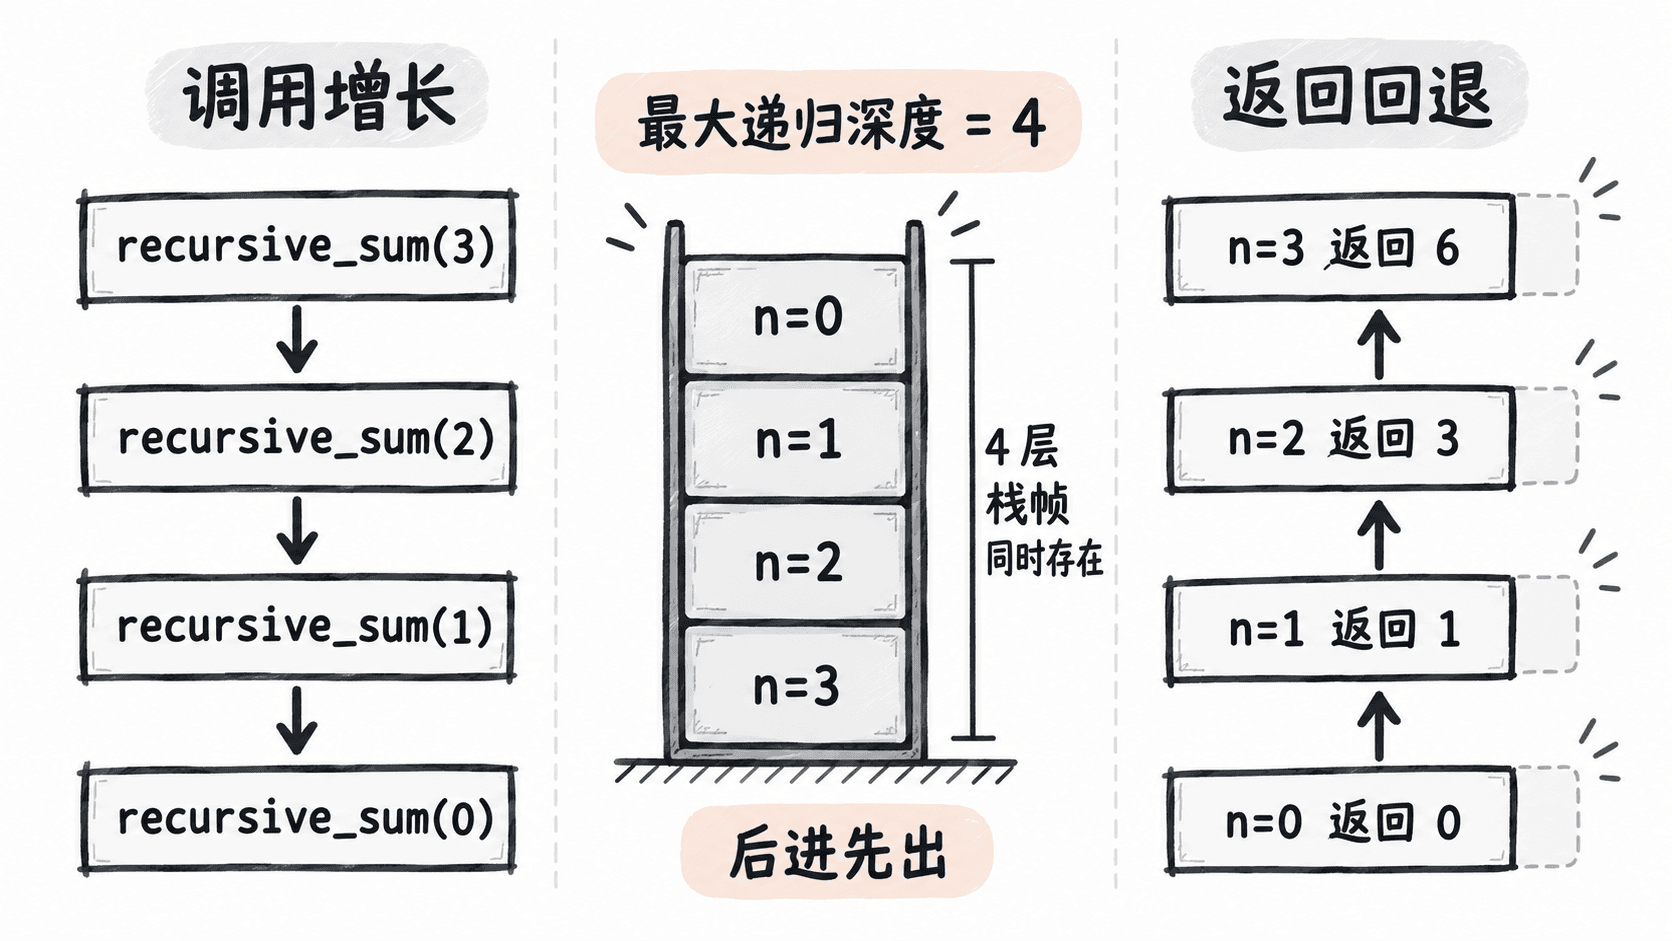
栈深度取决于同一时刻尚未返回的调用层数,而不是整个程序累计执行了多少次函数调用。对于线性递归,这两个数值可能相同;对于存在多个分支的递归,它们通常不同。
递归与循环的时间、空间成本
同一个问题既可以用递归实现,也可以用循环实现。两种写法可能具有相同的渐进时间复杂度,却消耗不同的辅助空间。分析递归时,如果只统计执行次数而忽略调用栈,就会低估内存成本和深层输入带来的失败风险。
对于从 n 递减到 0 的线性递归,共有 n + 1 次调用,最大同时存在 n + 1 个递归栈帧。若每层只做常数工作,且不考虑整数位宽增长带来的额外成本,则时间复杂度为 Θ(n),辅助空间复杂度也为 Θ(n)。
等价循环仍需执行 n 次迭代,但只保留固定数量的变量,因此辅助空间复杂度为 Θ(1)。这里的辅助空间指算法执行时额外使用的空间,不包括输入数据本身。
| 实现方式 | 工作次数 | 最大额外状态 | 时间复杂度 | 辅助空间复杂度 |
|---|---|---|---|---|
| 线性递归 | n + 1 次调用 |
n + 1 个递归栈帧 |
Θ(n) |
Θ(n) |
| 循环 | n 次迭代 |
固定数量变量 | Θ(n) |
Θ(1) |
这里假设每个递归栈帧只保存常数规模的数据。如果每层额外创建长度与当前问题规模相关的列表或字符串,就需要进一步统计这些对象在递归过程中同时占用的空间,不能直接套用 Θ(n)。
用代码统计调用次数与递归深度
下面的程序使用 Python 3.9 或更高版本,同时计算递归版本和循环版本。stats 记录递归调用总数与最大深度,便于把抽象复杂度映射到可观察数据。
def recursive_sum(n: int, stats: dict[str, int], depth: int = 1) -> int:
    if n < 0:
        raise ValueError("n must be non-negative")

    # 每次进入函数统计一次调用,depth 表示当前递归层数。
    stats["calls"] += 1
    stats["max_depth"] = max(stats["max_depth"], depth)

    # 到达基本情况后,不再创建新的递归栈帧。
    if n == 0:
        return 0

    return n + recursive_sum(n - 1, stats, depth + 1)


def iterative_sum(n: int) -> int:
    if n < 0:
        raise ValueError("n must be non-negative")

    # 循环只更新固定数量的变量,不累积调用栈帧。
    total = 0
    for value in range(1, n + 1):
        total += value
    return total


if __name__ == "__main__":
    number = 5
    stats = {"calls": 0, "max_depth": 0}

    recursive_result = recursive_sum(number, stats)
    iterative_result = iterative_sum(number)

    print(f"recursive result = {recursive_result}")
    print(f"recursive calls = {stats['calls']}")
    print(f"maximum stack depth = {stats['max_depth']}")
    print(f"iterative result = {iterative_result}")
预期结果:当 number = 5 时,两种方法均得到 15。递归从 5 调用到 0,因此调用次数与统计得到的最大递归深度均为 6。
这里的 depth 是程序自行维护的计数器,只统计 recursive_sum 函数自身的活跃调用层数,不包含解释器、模块入口或其他外部函数的栈帧。它适合分析递归算法的空间增长趋势,但不是进程实际栈内存占用量。
运行与验证
将代码保存为 recursion_cost.py,在安装了 Python 3.9 或更高版本的环境中执行:
python recursion_cost.py预期输出:
recursive result = 15
recursive calls = 6
maximum stack depth = 6
iterative result = 15
两个结果相同,说明递归与循环实现了相同的求和功能。调用次数和最大深度均为 6,对应从 5 到 0 的六层递归调用。
可以进一步检查三个边界:
n = 0:递归执行一次并直接返回0,最大深度为1;循环不执行任何迭代。n = 1:递归调用两次,最大深度为2,两种实现都返回1。n < 0:两种实现都抛出ValueError,避免递归继续向负数方向深入。
基本情况和每条分支的递减度量共同决定终止。对深度有界的递归,也仍需考虑具体运行环境的资源上限。
递归深度限制与常见误判
Python 默认设置递归深度限制,深层递归可能触发 RecursionError。例如,将 number 改成一个远大于默认递归限制的数值,递归版本可能在完成计算前失败,而循环版本没有相同的递归深度限制。
另一个常见误判是把尾递归直接视为 Θ(1) 空间。只有运行环境明确执行尾调用优化或尾调用消除时,尾递归才可能复用栈帧。Python 不保证尾调用消除,因此即使把递归调用放在函数返回位置,也不能据此认定其空间复杂度为 Θ(1)。
对于树形递归,还需要区分总调用次数和最大栈深度。例如,深度优先遍历包含 1000 个节点的平衡二叉树,虽然累计访问 1000 个节点,但沿单条递归路径同时保留的栈帧数量只与树高同阶,不必同时保留所有节点对应的调用帧。
分叉后调用次数和深度会分开
顺序遍历一棵高度为 h 的满层二叉树。程序按从根到叶的边数定义 h,根调用深度计作 1。每个内部调用先完整执行左分支,再执行右分支。
def count_complete_tree(height):
    """height 是根到叶的边数,height=0 表示只有一个节点。"""
    if type(height) is not int or height < 0:
        raise ValueError("height 必须是非负整数")
    calls = 0
    max_depth = 0

    def visit(remaining, depth):
        nonlocal calls, max_depth
        calls += 1
        max_depth = max(max_depth, depth)
        if remaining > 0:
            visit(remaining - 1, depth + 1)
            visit(remaining - 1, depth + 1)

    visit(height, 1)
    return calls, max_depth

print(count_complete_tree(3))
输出为 (15, 4)。访问次数为 ,同时活跃深度为 。这两个计数都基于不创建树对象的访问示例。如果实现另外构造结果树或保存遍历序列,需单独计入相应空间。
动手验证与复杂度判断
- 将示例中的
number改为8,再次运行程序。递归调用次数和最大深度都应为9,递归结果与循环结果都应为36。解释为什么结果增加不意味着栈深度按同样比例增长。 - 编写递归函数计算列表最大值,要求空列表抛出异常,长度为
1时直接返回唯一元素。使用索引传递当前位置,避免每层创建列表切片,并统计最大递归深度。假设每层只保存常数额外状态,分析其时间复杂度和辅助空间复杂度。
判断递归空间成本时,先找出最长的尚未返回的调用路径,再计算每层需要保留多少额外状态。对于本课的线性递归求和,时间复杂度与辅助空间复杂度都是 Θ(n);循环求和保持 Θ(n) 时间复杂度,同时将辅助空间降为 Θ(1)。