
容器与云原生 / 系统课时
处理启动期指标偏差
处理启动期指标偏差
慢启动服务常在启动阶段同时出现 CPU 峰值、Pod 尚未就绪和指标暂缺。若这些信号直接进入 HPA,可能造成过早扩容、扩容后迟迟不收敛,或在新副本尚未可用时误判容量。本课用探针、资源请求与 HPA 行为参数把启动期和稳态指标分开。
学习目标
- 判断启动探针、readiness 与 CPU 指标何时会影响 HPA 计算。
- 为慢启动服务配置能隔离初始化峰值的探针与资源请求。
- 用 HPA 行为参数和运行状态验证扩缩容是否按预期收敛。
启动期为什么会误导 HPA
HPA 按控制周期读取指标并计算期望副本数。对 CPU 利用率目标而言,Pod 的 CPU 使用量会与 resources.requests.cpu 比较;新 Pod 若过早进入 Ready,预热、JIT、缓存加载等初始化峰值就可能被当作稳态负载,推动继续扩容。
反过来,刚创建的 Pod 可能尚未上报指标,或者 CPU 样本产生在它真正 Ready 之前。HPA 会把缺失指标和“尚未就绪”的 Pod 暂时搁置,并用保守方式重新计算结果,因此启动阶段的扩容建议往往会被削弱,而不是简单地把缺失值当成零。
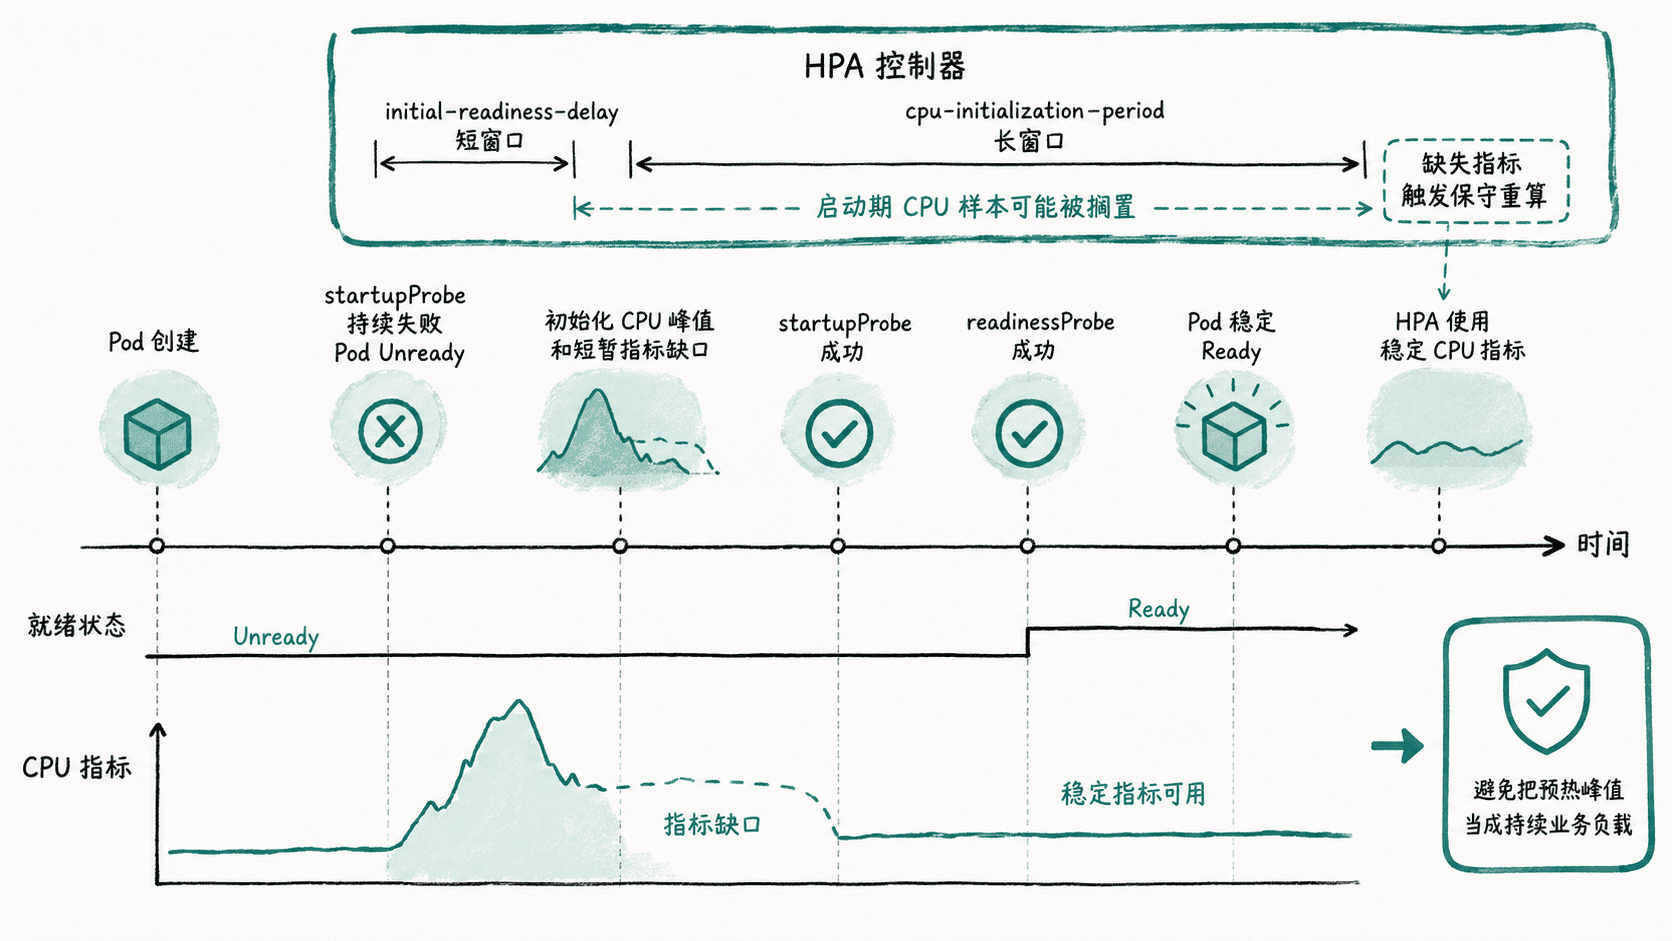
关键不是让探针“替 HPA 过滤指标”,而是让 Pod 的 Ready 时刻尽量接近它真正可以稳定接流量、且启动峰值已经结束的时刻。这样 readiness 语义、Service 流量入口与 HPA 的 CPU 判断才能对齐。
用探针隔离不可代表稳态的 CPU
下面是片段示例,假设应用镜像已经提供 /startupz 和 /readyz 两个 HTTP 端点。startupProbe 在预热完成前保持失败;它成功后,readiness 才开始决定 Pod 是否可以接流量。CPU 利用率 HPA 同时要求业务容器设置合理的 CPU request。
apiVersion: apps/v1
kind: Deployment
metadata:
  name: slow-api
spec:
  selector:
    matchLabels:
      app: slow-api
  template:
    metadata:
      labels:
        app: slow-api
    spec:
      containers:
      - name: app
        image: <IMAGE>
        resources:
          requests:
            cpu: 500m
            memory: 256Mi
          limits:
            cpu: "2"
            memory: 512Mi
        startupProbe:
          httpGet:
            path: /startupz
            port: 8080
          periodSeconds: 5
          failureThreshold: 36
        readinessProbe:
          httpGet:
            path: /readyz
            port: 8080
          periodSeconds: 5
          failureThreshold: 2
---
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: slow-api
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: slow-api
  minReplicas: 3
  maxReplicas: 20
  metrics:
  - type: Resource
    resource:
      name: cpu
      target:
        type: Utilization
        averageUtilization: 60
  behavior:
    scaleUp:
      policies:
      - type: Percent
        value: 100
        periodSeconds: 60
      - type: Pods
        value: 4
        periodSeconds: 60
      selectPolicy: Min
    scaleDown:
      stabilizationWindowSeconds: 300
这里的 failureThreshold × periodSeconds 给启动探针约 180 秒容忍时间,应按真实 P95/P99 启动时长留余量。minReplicas 要覆盖至少一个启动周期内的基础流量;scaleUp 示例把每分钟增长限制为“100% 或 4 个 Pod 中较小者”,避免新副本尚未就绪时成倍放大。缩容稳定窗口则避免预热峰值结束后立即删掉刚变热的副本。
把控制器窗口与真实启动时长对齐
kube-controller-manager 还有两个集群级参数影响 CPU 启动期处理:--horizontal-pod-autoscaler-initial-readiness-delay 默认 30 秒,主要处理 Pod 启动后短时间内 Ready/Unready 抖动;--horizontal-pod-autoscaler-cpu-initialization-period 默认 5 分钟,用于识别启动早期的 CPU 样本。
这两个参数不是单个 HPA 对象的字段,托管集群也未必允许修改。通常先把 startupProbe、readiness 语义和 CPU request 校准;只有大量工作负载都具有更长的初始化阶段,并且你能控制控制平面时,才考虑调整集群级窗口。
验证新 Pod 是否在正确时机进入采样
应用配置后,先观察 HPA 的目标值和副本数,再结合 Pod Ready 时间确认:新 Pod 在启动峰值结束前不应过早成为稳定流量承载者,扩容后也不应连续出现无边界的副本增长。
kubectl get hpa slow-api预期输出类似如下,<VALUE>、<TIME> 会随负载和集群状态变化;指标尚未可用时 TARGETS 也可能暂时显示 <unknown>/60%。
NAME       REFERENCE             TARGETS        MINPODS   MAXPODS   REPLICAS   AGE
slow-api   Deployment/slow-api   <VALUE>%/60%   3         20        <VALUE>    <TIME>
若 HPA 在每批新 Pod 尚未 Ready 时仍持续大幅扩容,优先检查 readiness 是否过早、CPU request 是否明显偏小,以及指标是否存在采样缺口;不要先用更长的稳定窗口掩盖错误的就绪语义。