
容器与云原生 / 系统课时
理解 Pod 到节点的容量链路
理解 Pod 到节点的容量链路
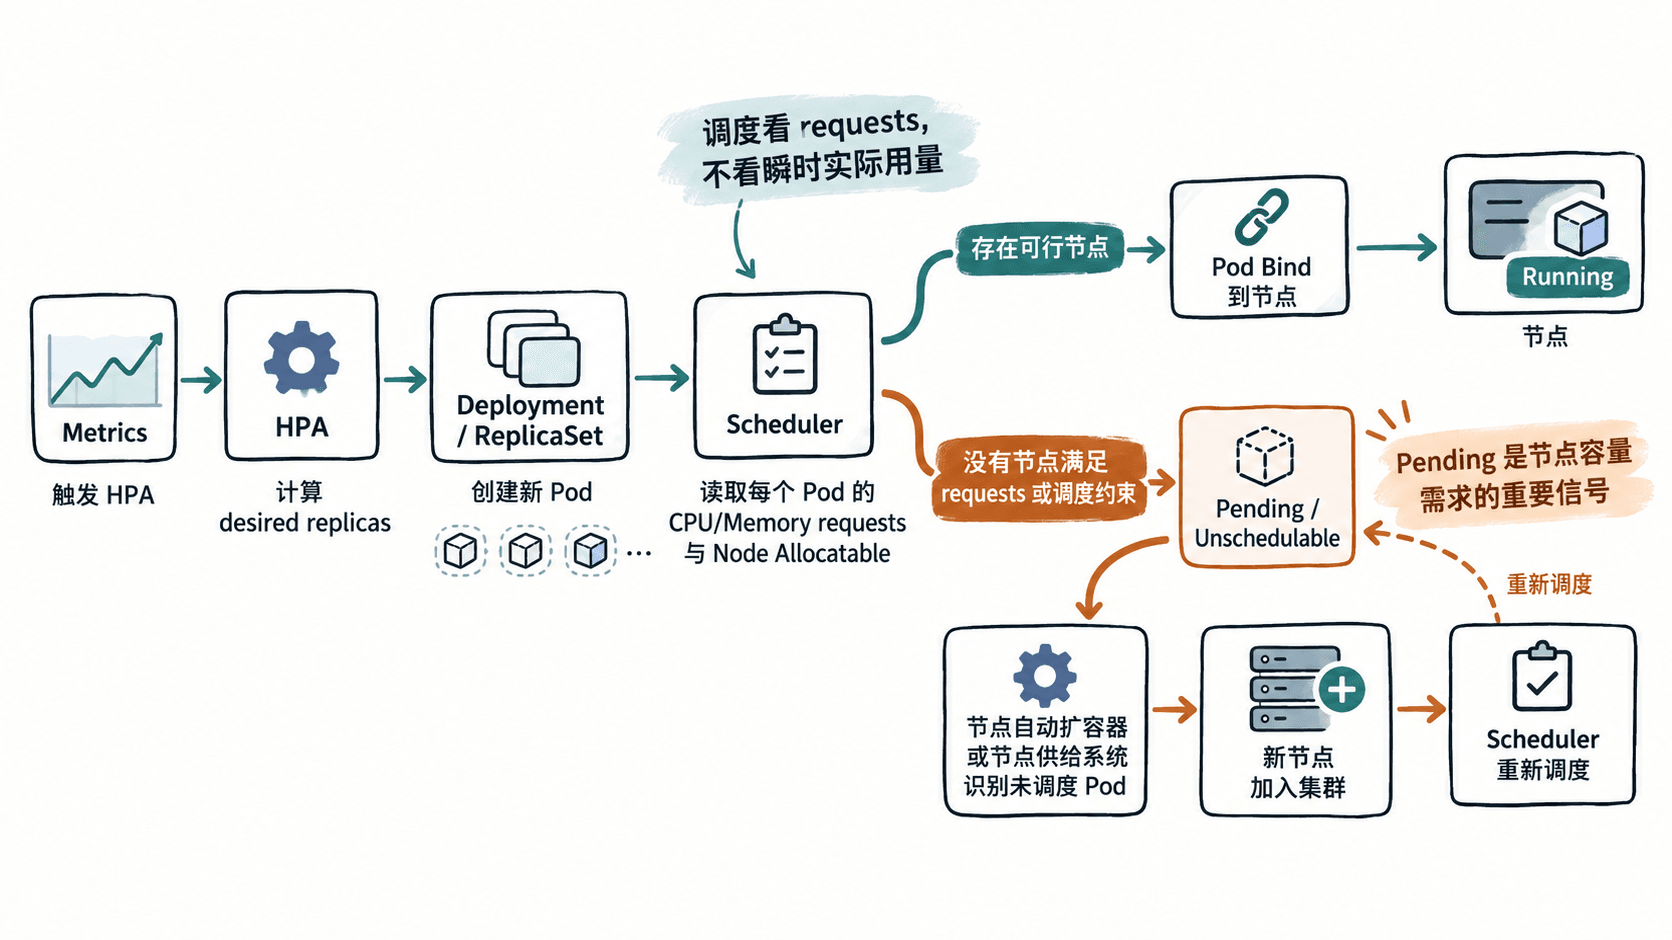
HPA 把副本数调大,只代表控制器希望创建更多 Pod,并不代表集群已经有地方运行它们。本篇沿着“扩副本 → 创建 Pod → Scheduler 判定 → Pending → 节点扩容”的链路,说明 requests 为什么会把 Pod 级伸缩转化成节点级容量需求。
学习目标
- 解释 HPA 扩容后新 Pod 如何进入调度与节点容量判断
- 理解
requests、Node Allocatable 与可调度资源之间的关系 - 从 Pending Pod 的调度事件判断是否真的需要增加节点
HPA 只负责提出更多 Pod
HPA 根据指标计算期望副本数,并通过目标工作负载的 scale 接口调整副本。Deployment 等控制器随后创建新的 Pod。到这一步为止,HPA 并不会选择节点,也不会保证新副本一定能够运行。
新 Pod 进入 Scheduler 后,调度器会先做过滤:节点是否满足 CPU、内存 requests,是否符合 nodeSelector、亲和性、污点容忍、拓扑约束等条件。只有至少存在一个可行节点,Pod 才能进入后续打分并最终绑定。
requests 决定能不能放下
Scheduler 判断资源是否足够时,核心依据是 Pod 的资源请求与节点的可分配容量,而不是容器此刻实际用了多少。可以把单个节点的剩余可调度 CPU 简化为:
如果一个新 Pod 请求 1000m CPU,而所有候选节点都只剩 600m,即使机器监控显示当前 CPU 很空闲,Scheduler 仍会认为该 Pod 放不下。反过来,requests 设得过低会让更多 Pod 被塞进节点,运行时再因真实负载上升出现争抢。
因此,VPA 校准 requests 与 HPA 扩副本并不是两套无关机制:前者改变“每个副本占多少可调度容量”,后者改变“需要多少副本”,二者共同决定节点层需要多少资源。
Pending 如何变成节点扩容信号
当没有任何节点满足条件时,Pod 会保持 Pending,调度事件通常出现 FailedScheduling。节点自动扩容系统会关注这类不可调度 Pod,并判断是否存在某种节点规格,加入集群后能够让它们被调度。
这里要区分“容量不够”和“约束无解”。例如缺 CPU、缺内存通常可以通过增加合适节点解决;但错误的 nodeSelector、无法满足的拓扑约束、缺少 toleration,即使继续加同类型节点也可能一直 Pending。节点扩容前必须先看调度原因,而不是见到 Pending 就扩机器。
用调度事件定位容量瓶颈
下面命令适用于已经出现 Pending Pod 的场景。它先取一个 Pending Pod,再查看其 requests 与最近的 FailedScheduling 事件。
NAMESPACE=shop
POD=$(kubectl get pods -n "$NAMESPACE" \
  --field-selector=status.phase=Pending \
  -o jsonpath='{.items[0].metadata.name}')

kubectl get pod "$POD" -n "$NAMESPACE" \
  -o custom-columns='NAME:.metadata.name,CPU_REQ:.spec.containers[*].resources.requests.cpu,MEM_REQ:.spec.containers[*].resources.requests.memory'

kubectl get events -n "$NAMESPACE" \
  --field-selector involvedObject.name="$POD",reason=FailedScheduling \
  --sort-by=.lastTimestamp
预期输出
NAME                 CPU_REQ   MEM_REQ
<POD_NAME>           <VALUE>   <VALUE>

<TIME>   Warning   FailedScheduling   pod/<POD_NAME>   <REASON>
<REASON> 的实际文本取决于集群状态。若其中明确包含 Insufficient cpu、Insufficient memory 等资源不足信息,才说明节点容量是直接瓶颈;若提示节点选择、污点或亲和性冲突,应先修正调度约束。
从 Pod 伸缩走到节点伸缩,真正的桥梁不是 HPA 本身,而是 新 Pod 的 requests 无法被现有节点满足后产生的不可调度状态。把这条链路分开观察,就能避免把“副本数不够”“单 Pod 申请不合理”和“节点容量不足”混成同一个问题。